はじめに
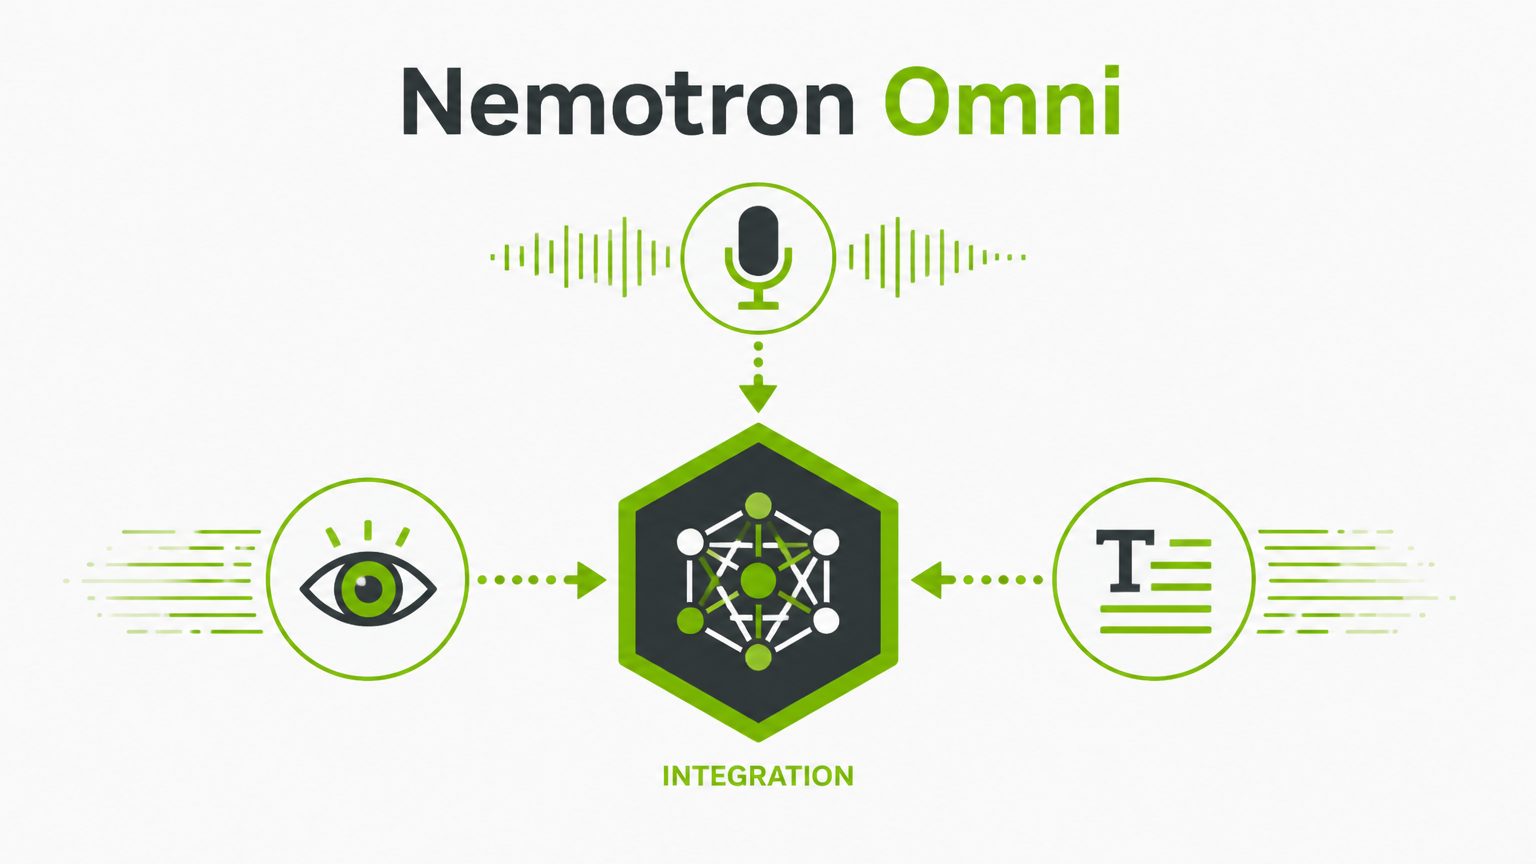
NVIDIAは2026年5月12日、視覚・音声・言語の処理を1つのモデルに統合したオープンなマルチモーダルAI「Nemotron 3 Nano Omni」を発表しました。本稿では、このモデルのアーキテクチャと性能、エージェント型AIワークフローへの活用方法を解説します。
参考記事
- タイトル: NVIDIA が視覚、音声、言語を統合し、AI エージェントの効率を最大 9 倍向上させる Nemotron 3 Nano Omni モデルを発表
- 著者: Kari Briski
- 発行元: NVIDIA Japan Blog
- 発行日: 2026年5月12日
- URL: https://blogs.nvidia.co.jp/blog/nemotron-3-nano-omni-multimodal-ai-agents/
関連記事
要点
- Nemotron 3 Nano Omniは、視覚・音声・言語を1つのモデルに統合したオープンなマルチモーダルAIである
- 同等のオープンオムニモデルと比較して9倍のスループットを実現し、6つのリーダーボードでトップを獲得した
- 30B-A3BのハイブリッドMoEアーキテクチャを採用し、256Kトークンのコンテキスト長に対応する
- コンピュータ操作・ドキュメント理解・音声/ビデオ分析という3つのエージェント型ワークフローのサブエージェントとして機能する
- モデルの重み・データセット・学習手法がオープンで公開されており、Hugging Face等から入手可能である
詳細解説
マルチモーダル統合が解決する課題
今日のAIエージェントシステムの多くは、視覚・音声・言語それぞれに専用のモデルを組み合わせて動作しています。NVIDIAによれば、この構成ではモデル間でデータを受け渡すたびにレイテンシ(処理の遅延)が蓄積し、文脈情報が断片化されるという問題があるとのことです。推論処理の繰り返しによってコストと精度が時間とともに悪化していく点も、企業利用における課題と位置づけられています。
こうした課題に対して、Nemotron 3 Nano Omniは視覚エンコーダと音声エンコーダを30B-A3Bのハイブリッド混合エキスパート(MoE)アーキテクチャに統合しています。MoEとは、処理内容に応じて適切な「エキスパート」モジュールを選択的に起動する効率的なアーキテクチャで、全パラメータを常時使用せずに済むためコンパクトな構成でも高い性能を発揮しやすい方式です。NVIDIAによれば、この設計により同等のインタラクティビティを持つ他のオープンオムニモデルと比較して9倍のスループットを実現しているとのことです。
3つのエージェント型ワークフロー
NVIDIAは、Nemotron 3 Nano Omniが対応するエージェント向けユースケースとして3つを挙げています。
コンピュータ利用エージェントでは、グラフィカルユーザーインターフェース(GUI)をナビゲートしながら画面上のコンテンツを理解し、操作を自律実行します。H CompanyはNemotron 3 Nano Omniをフル HD(1920×1080ピクセル)解像度で自社のコンピュータ利用エージェントに組み込み、OSWorld ベンチマーク(PCの複雑な操作能力を評価する指標)による予備評価で、複雑なインターフェース操作の性能が大幅に向上したと報告しています。同社CEOは「画面録画を瞬時に解釈できるようになり、エージェントがデジタル環境をリアルタイムで認識する仕組みに根本的な変革をもたらすもの」とコメントしています。
ドキュメントインテリジェンスでは、PDF・グラフ・表・スクリーンショットなど複数のメディアを統合的に解釈し、視覚的な構造とテキスト内容を整合して理解します。企業の分析業務やコンプライアンスワークフローでの活用が想定されています。
音声・ビデオ理解では、カスタマーサービスや調査・監視ワークフローにおいて、音声と映像の文脈を維持しながら単一の推論ストリームとして処理します。発言・映像・文書化された情報を断片的な要約ではなく一貫して扱える点が特徴です。
オープン公開と展開の柔軟性
Nemotron 3 Nano Omniはモデルの重み・データセット・学習手法とともにオープンで公開されています。これにより、組織はモデルのカスタマイズと展開方法を透明な形でコントロールできると説明されています。規制要件・データローカリゼーション(データを特定の地域内に保管する要件)への対応も想定されており、NVIDIA NeMoなどのツールを使ったドメイン固有のカスタマイズも可能です。
展開環境はNVIDIA Jetsonなどのエッジデバイス(現場に近い小型端末)から、DGX SparkやDGX Stationなどのローカルワークステーション、データセンター・クラウド環境まで幅広くサポートしています。NVIDIAのJetsonを活用したエッジAIの取り組みと方向性を共有する展開戦略といえます。Hugging Face・OpenRouter・build.nvidia.comのほか、25以上のパートナープラットフォームでも利用可能です。
採用企業にはFoxconn、Palantirなどが名を連ねており、Dell Technologies・DocuSign・Oracleなども評価を進めているとのことです。Nemotronファミリー全体は過去1年間で5,000万回以上ダウンロードされており、今回のOmniはその機能をマルチモーダルおよびエージェント領域に拡張するモデルとして位置づけられています。
まとめ
Nemotron 3 Nano Omniは、視覚・音声・言語を1つのモデルで処理することで、複数モデルの組み合わせに伴うレイテンシとコストを抑えながら高いスループットを実現するアプローチです。オープン公開のため導入や評価がしやすく、エージェント型AI活用を検討する企業の選択肢として注目されます。NVIDIAのエージェントAI戦略についてさらに知りたい方は、NVIDIA・Adobe・WPPの三社連携記事もあわせてご覧いただければと思います。