はじめに
Googleは2026年11月11日、はい/いいえや選択肢の判定に特化した新しい「Gemini Decisions API」を発表しました。文章を生成せず確率だけを返すことで、150〜250ミリ秒の応答と出力トークン無料を実現しています。本稿では、その仕組みと使い方を整理します。
参考記事
- タイトル: Gemini Decisions API: Fast, calibrated multimodal decisions
- 著者: Min Choi, Felix Yu
- 発行元: Google(The Keyword)
- 発行日: 2026年11月11日
- URL: https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/
関連記事
要点
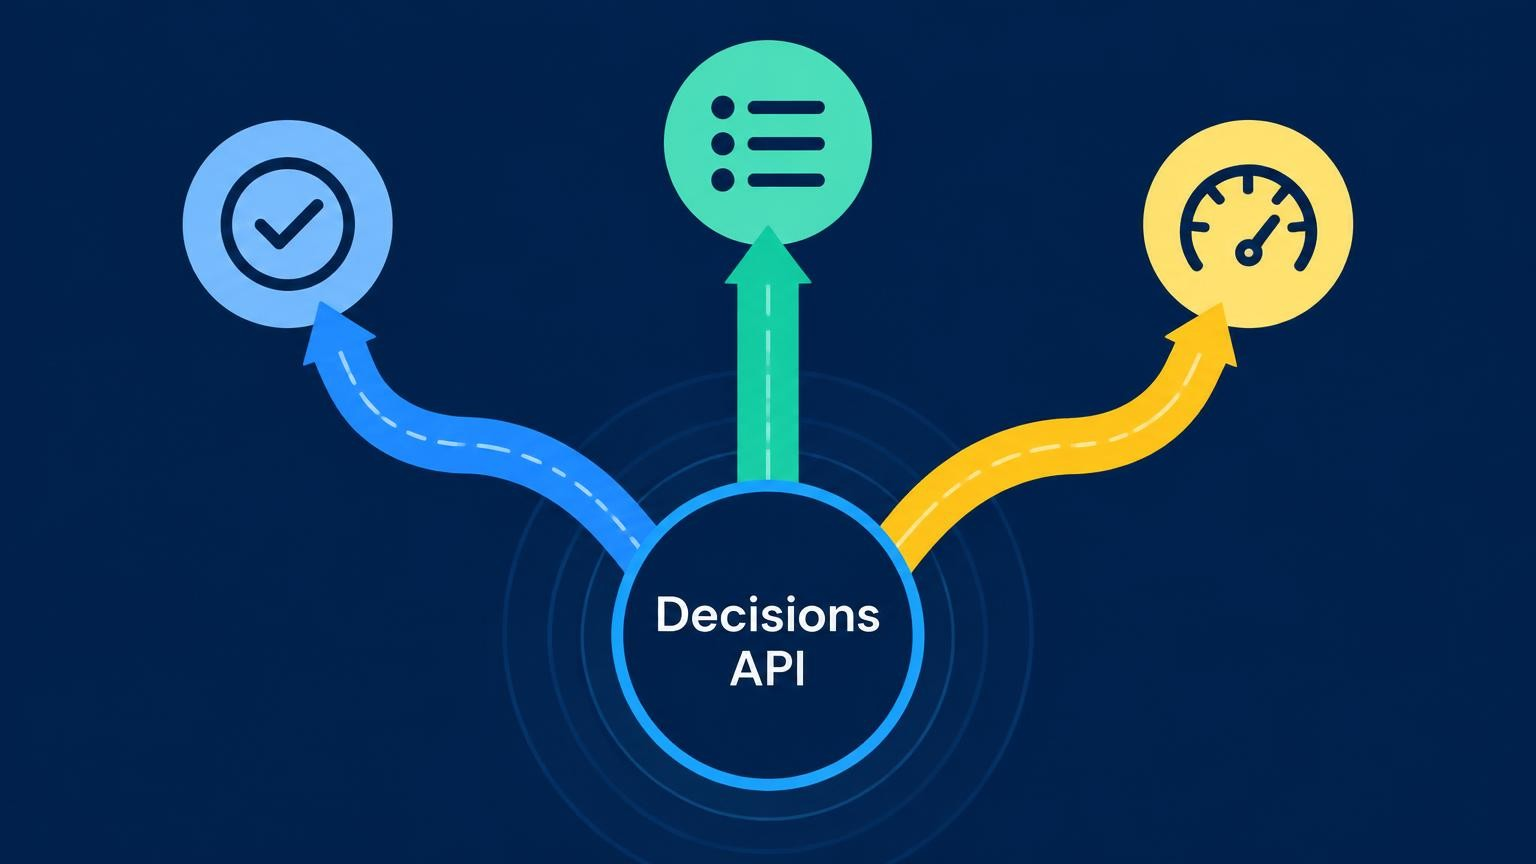
- Gemini Decisions APIは、新モデル「Gemini Decision 1」(gemini-decision-1)を使う、選択肢が決まった判定のための新しいエンドポイントである
- 文章を1トークンずつ生成する代わりに、候補の選択肢を1回の順伝播で採点し、確率と信頼度スコアを返す。応答はエンドツーエンドで150〜250ミリ秒である
- テキスト・画像・音声・動画・PDFの入力(最大25.6万トークン)1つに対し、最大1,000件の独立した質問を一度に評価できる
- 質問の種類は、はい/いいえ(noul)、多肢選択(choice)、順序付きルーブリック(score)の3つで、すべての回答に0〜1の信頼度が付く
- 料金は入力100万トークンあたり0.10ドルで、出力トークンは課金されない。共有ベンチマークでは、Interactions API経由のGemini 3.5 Flash-Liteより約5倍安いとしている
詳細解説
概要——ツール選択やモデル振り分けのための「判定専用」API
Gemini Decisions APIは、Google AI StudioのGemini APIから利用できる、選択肢の決まった判定(クローズドセットの判定)のための新しいエンドポイントです。Googleは、ツールの選択、ポリシーへの適合チェック、モデルの振り分け(ルーティング)、文脈の評価といった「範囲の決まった選択」のための専用の部品だと説明しています。
テキスト、画像、音声、動画、PDFを組み合わせた1つの入力(最大25.6万トークン)と、最大1,000件の独立した質問を一緒に渡せます。Gemini Decision 1は回答の文章を1トークンずつ生成するのではなく、候補の選択肢を1回の順伝播(モデルに入力を1回通す計算)で採点し、確率と信頼度スコアを返します。
生成AIで「はい」か「いいえ」かを判定させる場合、これまではモデルに文章を生成させ、その文字列を解析するのが一般的でした。本稿としては、判定に必要なのは答えの文章ではなく選択肢ごとの確率だ、という割り切りがこのAPIの核心だと受け止めています。
性能と較正(キャリブレーション)
Googleによれば、エージェントのルーティング、推論、ランキング、マルチモーダル理解にまたがるベンチマークで、Gemini Decision 1は全体的に首位となり、較正誤差も最も低かったとしています。較正誤差とは、モデルが示す確信度と実際の正答率のずれのことで、これが小さいほど「90%の確信」が実際に約9割当たるという意味になります。
速度とコストについては、次のように説明されています。
- レイテンシ: トークン単位のデコードを行わないため、モデルの計算時間の中央値は50〜100ミリ秒(エンドツーエンドで150〜250ミリ秒)。マルチモーダル入力や最大1.6万トークンの文脈でも、1リクエストあたりの質問数が1から100に増えてもほぼ一定だった
- コスト: 出力トークンが課金されないため、共有のベンチマーク群では、Interactions API経由のGemini 3.5 Flash-Liteと比べて約5倍安い
3種類の判定を1回で評価する
Gemini Decision 1はGeminiのネイティブなマルチモーダル構造をもとにしており、テキスト、画像、音声、動画、PDFを1回の順伝播で直接処理できます。通話の録音とアカウント情報、スキャンしたPDFの請求書と損傷の写真のように、複数の形式を1つの入力にまとめることもできます。画像や動画は解像度を調整でき、見る細かさとトークンのコストを制御できます。
1つの入力に対して複数の質問を1リクエストで評価でき、はい/いいえ、多肢選択、ルーブリック評価を混在させられます。すべての回答には0から1の信頼度スコアが付くため、判断が曖昧なケースだけを代替処理や人間のレビュアーに回す、といった制御をコードで書けます。質問の種類は次の3つです。
- noul(はい/いいえ): 条件が成り立つ確率を推定する。「真」「偽」それぞれの説明基準を任意で指定できる
- choice(多肢選択): 2〜255個の選択肢から選び、選ばれた選択肢と全候補の正規化された確率を返す
- score(順序付きルーブリック): 0から始まる順序付きの評価基準で採点し、連続値の加重スコアと各段階の確率を返す
実装例——休憩室のカウンターを3種類の質問でチェックする
入力欄は、Interactions APIと同じContentブロック形式を使います。以下は、休憩室のカウンターの写真とテキストのメモを組み合わせ、3種類の質問を1回のリクエストで評価する例です。コードは参考記事のもので、コメントは本稿で日本語に訳して補っています。
from google import genai

# v1betaのAPIバージョンを指定してクライアントを作成する
client = genai.Client(http_options={"api_version": "v1beta"})
result = client.decisions.create(
    model="gemini-decision-1",

    # 共有の入力: 画像とテキストを組み合わせる
    input=[{
            "type": "image",
            "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
            "mime_type": "image/jpeg",
        },
        {
            "type": "text",
            "text": "Breakroom counter check before the 9 AM client meeting.",
        },
    ],

    # 同じ入力に対して評価する質問(キーは任意の名前)
    questions={
        # はい/いいえ: カウンターに拭き残しの液体がこぼれているか
        "has_spill": {
            "type": "noul",
            "instructions": "Is there an uncleaned liquid spill on the counter?",
        },

        # 多肢選択: どの片付け方法が状況に合うか
        "next_action": {
            "type": "choice",
            "instructions": "Which cleanup action fits the scene?",
            "criteria": {
                # 小さなこぼれで、布やタオルが近くにある
                "wipe_with_cloth": "Small counter spill with a cloth or towel already nearby.",
                # 床の大きな危険、割れたガラス、漏れが続いている
                "dispatch_janitorial": "Large floor hazard, broken glass, or active leak.",
                # カウンターはきれいで準備ができている
                "ready_for_meeting": "Counter is clean and ready.",
            },
        },

        # 順序付きルーブリック: 汚れの深刻度を0から順に評価する
        "severity": {
            "type": "score",
            "instructions": "Rate the severity of the counter mess.",
            "criteria": [
                "Clean and ready.",                # 0: きれいで準備完了
                "Minor localized spill.",          # 1: 局所的な軽いこぼれ
                "Major spill or safety hazard.",   # 2: 大きなこぼれ、または安全上の危険
            ],
        },
    },
)
この例では、questionsに名前付きで3つの質問を並べ、typeでそれぞれの種類を指定しています。choiceでは選択肢の名前と説明を辞書で、scoreでは低い段階から順に説明をリストで渡します。参考記事にはレスポンスの形式は示されていないため、返り値の詳しい扱い方は公式のDecisions APIドキュメント(Python・JavaScript・RESTのガイドがある)で確認する必要があります。
Google社内での活用例
Googleの各チームは、独自の分類器を訓練したり生成型の呼び出しを待ったりする代わりに、選択肢を定義するだけで機能を出す「低遅延の制御層」としてDecisions APIを使い始めているといいます。
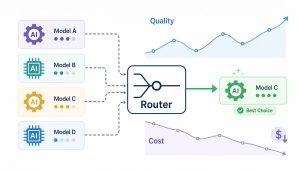
- Gemini Notebookでの動的なモデル振り分け: 受け取った質問を、リクエストごとに最適なモデルの階層と思考レベルへ即座に振り分ける。意図をミリ秒単位で分類し、日常的な質問の遅延を最大40%減らしつつ、深い推論モデルは複雑なタスクに温存している
- Stitchでの高速なデザイン反復: Stitchの新しい実験機能「rapid canvas」で、製品フローの操作可能なワイヤーフレームを数秒で生成し、音声やタップによる編集をほぼ即座に反映する
- CCでの絵文字選択: Google LabsのCCが、200以上の候補から適切な絵文字のリアクションを一瞬で選び、遅延を増やさずに表示する
- 検索のMCPツール向け安全層: Google検索が、敵対的な振る舞いやコンテンツの検出に使い、遅延の許容範囲内で高い効果を上げている
本稿としては、モデルの振り分けや安全チェックのように「本処理の前に毎回挟む判定」は、遅延とコストが積み重なりやすい部分だと思います。そこを生成モデルから切り離せる点が、実際の導入で効いてきそうです。
料金と始め方
料金と課金の仕組みは次のとおりです。
- 料金: 入力100万トークンあたり0.10ドル、出力トークンは0ドル。Google AI Studioでは試作向けの無料枠を利用できる
- 共有入力の課金: 評価する質問の数にかかわらず、共有の入力はリクエストごとに1回だけ課金される。各質問で追加されるのは、その質問の指示と基準のトークンのみ
- 追加費用なし: 出力トークンの課金、変動する思考トークンの費用、音声の文字起こしやOCRの別料金はかからない
始めるには、Google AI StudioでAPIキーを取得し、デモアプリ(Doorstep Parcels、Speed Sketch、Find the Zoo Keeper)を試し、Decisions APIのドキュメントにあるPython、JavaScript、RESTのガイドに従います。また、OpenRouter、LangChain、Vercel、LiteLLM、Pydantic AI、Pipecat、LiveKit、OpenCodeとの連携がgoogle-genai SDKとあわせて順次提供されており、Google CloudのGeminiへの対応も近日予定とされています。
一方で、このAPIが扱えるのはあらかじめ決めた選択肢の中での判定に限られ、自由な文章での回答や理由の説明は返しません。判定の根拠を利用者に示す必要がある場面では、生成モデルとの組み合わせを検討する必要があると考えられます。
まとめ
Gemini Decisions APIは、文章を生成せず選択肢の確率だけを返すことで、速く安い判定を可能にしました。信頼度で曖昧なケースを人に回せる点も実務向きです。ポリシーを「問い」として判定する考え方は、Mistralの安全性分類器「Shieldstral」を紹介した記事もあわせてご覧ください。