はじめに
Anthropicの開発者向けブログ「claude.dev」が2026年11月16日、Claude Codeチームがエージェントの成果物をどう検証しているかを解説する記事を公開しました。本稿では、投資する価値のある3種類のテストと、チーム内で実際に運用されている検証の仕組みを整理して紹介します。
参考記事
- タイトル: How the Claude Code team thinks about verification
- 著者: Addy Osmani
- 発行元: Anthropic(claude.dev)
- 発行日: 2026年11月16日
- URL: https://claude.dev/blog/how-the-claude-code-team-thinks-about-verification/
関連記事
要点
- Claude Codeチームではコードの約90%をClaudeが書き、レビューしており、エージェントが証拠をもって自らの作業を検証できる仕組みが重視されている
- 投資する価値のあるテストとして、E2Eテスト、プロパティテスト、差分テストの3種類が挙げられている
- チームは「変更を実際に動かすこと」を検証の中心に置き、verifyスキル、39項目の信頼性チェックリスト、コミットゲートなどを運用している
- 変更が自らを判定するチェックを書き換えられない構造にすること、見逃しをルールに変えることが原則として示されている
詳細解説
なぜ検証ループが重要なのか
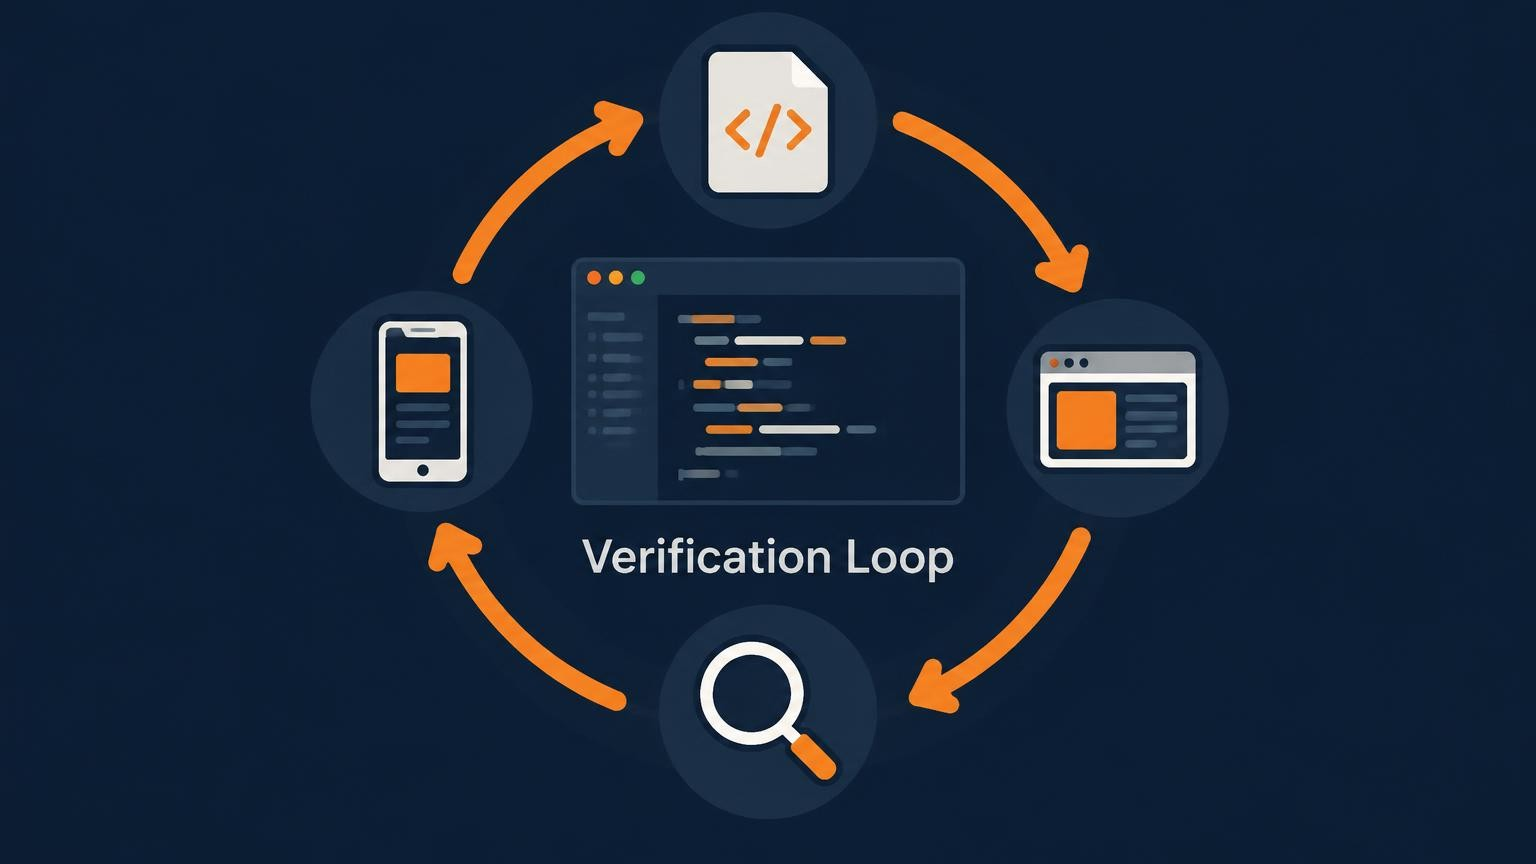
Anthropicによれば、Claude Codeチームではコードの約90%をClaudeが書き、レビューしています。この規模になると、エージェントが証拠にもとづいて自分の作業を検証できるようにすることが極めて重要になると記事は述べています。検証ループがなければ、人がすべてを確認しなければならないため同時に動かせるClaudeは1〜2体が限界ですが、検証ループがあれば数十〜数百体を並列で動かせるという整理です。
品質面の効果も示されています。構造化ファイル生成に関する社内テストでは、別の採点役(グレーダー)がルーブリックに照らしてClaudeの成果物をチェックすることで、標準的なプロンプトループと比べてタスク成功率が最大10ポイント向上し、難しい問題ほど効果が大きかったとされています。
さらに記事は、かつて高コストだったテスト・ベンチマーク・仕様書・実際のエンドツーエンド実行が、いまではエージェントに安く依頼できるようになった点を指摘しています。一度生成したテストはソフトウェアとして動くため、追加のトークンをほとんど使わずに繰り返し実行できます。結果をエージェントの改善に戻すこともでき、たとえばログにユーザーデータが含まれていないかを確認するテストに何度も失敗するなら、フック(hook)を作るかCLAUDE.mdにより明示的なルールを書くことで、同じ問題の再発を(ほぼ)防げるとしています。
本稿としては、「エージェントの性能を上げる」よりも「エージェントの出力を人が見なくて済む範囲を広げる」ための投資として検証を位置づけている点が、この記事の出発点だと読んでいます。
テスト選びで避けたい失敗パターン
どのテストを選ぶ場合でも、避けるべき失敗モードがあると記事は述べています。
- 不安定(flaky)なテスト: 失敗したコードを直すのではなく、テストを再実行するようエージェントを「しつけて」しまう
- 遅いテスト: エージェントがバッチをまたいで実行するテストの回数が減り、問題の特定が難しくなる。重いテストはコミット前に実行するのが適している
flakyなテストとは、同じコードでも実行のたびに成功したり失敗したりするテストを指します。人間の開発者でも「とりあえず再実行」が習慣化しがちですが、エージェントは与えられたフィードバックに素直に適応するため、その悪影響がより強く出る可能性があると考えられます。
1. E2Eテスト: 一つ選ぶならこれ
記事は、テストの種類を一つに絞るならエンドツーエンド(E2E)テストを選ぶよう勧めています。E2Eテストは、カートに商品を追加し、購入手続きを進め、確認ページに移動するといった実際のユーザーフローを記述するテストです。
E2Eテストが有効な理由は、ごまかしが効きにくいことです。機能全体が動くか動かないかのどちらかであり、完了条件が明確で、何が壊れているかを具体的に示してくれます。記事の図では、ユニットテストが「Error: Timeout after 30s」としか表示しないのに対し、E2Eテストは手順のトレースやスクリーンショットとともに「決済フォームが読み込まれず、注文ボタンが無効のままだった」といった失敗箇所の説明を示せる、という対比が描かれています。
ユニットテストは高速で不安定さも少ない一方、通過しても機能が壊れていることがあります。エージェントもテストもタスク全体を理解していないためだと記事は説明しています。E2Eテストでは、エージェントに実際に動いているシステムを操作し観察する「手と目」を与えるのが効果的で、スキルを使ってアプリを起動・操作・検査できるようにし、CDP(Chrome DevTools Protocol)、シミュレーター、APIハーネスなどのツールを活用する方法が紹介されています。
また、ユーザー視点で機能を列挙し、操作経路・キーボードショートカット・セレクター・期待される結果を記した「機能マップ」は、エージェントにとってのガイド兼採点基準として使えるとしています。既存のQA用テスト仕様書がある組織であれば、それを機能マップの下地として転用できる可能性があると思います。
2. プロパティテスト: 壊れてはいけない制約
多くのテストは「何がうまくいかなそうか」という作り手の想定にもとづいています。プロパティテストは、人が見落としがちでエージェントもつまずきやすいエッジケースを狙う手法です。まず「これは絶対に成り立つ」という性質を書き、テストライブラリにその反例を探させるために何千もの入力を自動生成させます。記事で挙げられているライブラリは次のとおりです。
- JavaScript / TypeScript: fast-check
- Python: Hypothesis
- Rust: proptest
ほぼすべてのソフトウェアプロジェクトに存在する性質として、記事は次の4つを挙げています。
- 往復変換(Round-trip encoding): Xをエンコードしてデコードし直すと元のXに戻る。パースやシリアライズにも使える
- 不変条件(Invariants): 「口座残高は決してマイナスにならない」のように、常に成り立たなければならないこと
- 冪等性(Idempotency): マイグレーション、正規化、リトライなどの操作を2回行っても、1回行ったのと同じ結果になる
- 等価性(Equivalence): 最適化したコードが、素朴だが正しいコードと同じ結果を出す
プロパティテストのライブラリは、元のコードを書いたエージェントと同じバイアスを持たないエッジケースを使えるため、エージェントを「正直に保つ」のに役立つと記事は述べています。仕様書が本番の挙動からずれてしまい、検証の拠り所として信頼できなくなった状態での書き直しにも特に有効だとしています。
本稿としては、エージェントが実装とテストを両方書く場合、同じ思い込みが両方に入り込む「共犯関係」が起きうる点に、この手法が効いてくるのだと受け止めています。
3. 差分テスト: 旧システムを「正解」として使う
差分テスト(Differential tests)は、機能が変わらないことが期待される大規模なマイグレーションで特に有効だとされています。同じ入力で旧システムと新システムの両方を動かし、結果に違いがあれば、修正すべきバグか破壊的変更があると判断します。
ポイントとして記事は次の点を挙げています。
- ランダムに生成した入力か、本番トラフィックのサンプルを使う
- 空白などの本質的でない差異は正規化しておく
- 新環境が旧環境と異なってよいケースについて、承認済みの変更リストを持っておく
タイトルにある「オラクル」とは、テストにおいて正しい出力を判定する基準のことです。仕様書を一から書き起こさなくても旧システムそのものが基準になるため、ドキュメントが十分に残っていないレガシー移行で特に扱いやすい手法だと考えられます。
Claude Codeチームの検証の考え方①: 変更を実際に動かす
ここからはClaude Codeチーム自身の運用です。同チームのレビュー体制についてはClaude Codeチームのコードレビューの仕組みとして以前の記事でも解説されていましたが、今回はより踏み込んで検証の方法が説明されています。
記事は、テストよりもアプリをエンドツーエンドで動かすことのほうが重要だと述べています。シミュレーターで試さずにiOSの変更を出荷しないのと同じで、Claudeにも同じことが求められるという考え方です。Claudeは人間やQAエンジニアと同じようにアプリ全体をテストできます。記事では、変更の種類ごとに次の手段を使うよう勧めています。
- Webの変更: Claude Chrome拡張機能を使う
- モバイル: iOSまたはAndroidのMCPを使う
- デスクトップ: computer useを使う
- バックエンド: サービスをローカルで起動する
シミュレーターの起動方法やアプリの実行方法は、「verify」という名前のスキルとして明文化します。具体的な手順は次のとおりです。
- リポジトリ内の
.claude/skills/フォルダにverifyスキルを置く。関連するコードにできるだけ近い場所に置き、必要な数だけ追加してよい - Claudeはコミット前にverifyスキルを使うことを理解している
- verifyスキルを高速かつ信頼できるものにするため、Claude自身に改善を繰り返させ、ストレステストを行わせる。これはスモークテスト(基本動作の簡易確認)のハーネスにあたるため、堅牢であることが重要
変更をエンドツーエンドでスモークテストする手段をClaudeに与えると結果が大きく改善し、人間と同じように反復しながら実際のミスを素早く見つけるようになると記事は述べています。Anthropicでは、ほぼすべての変更をこの方法でテストしているとのことです。
Claude Codeチームの検証の考え方②: 人の関与とチェックの設計
チームの運用ルールのうち、人の関与とチェックの作り方に関わるものは次のとおりです。
- 失敗したテストは人の注意を要する: すべての変更を人が読むことはできないため、失敗を「人が見るべきもの」を決める手段の一つとして使う。Claudeがチェックを実行し、失敗したものの修正を試み、3ラウンド後も失敗が続く場合はClaudeが作業を止めて人を呼ぶ
- コードオーナーが自分でチェックを書く: コードを所有する人がそのチェックを書き、オーナー自身が指摘するであろう点を指摘できるまで磨き込む。チェックがレビュアーを呼ぶときは、差分から読み解かなくて済むように理由を明示する
- 信頼性チェックは差分をきっかけに発動する: チームは39項目の信頼性チェックリストを保守しており、各項目には差分から読み取れる発動条件、チェック内容、その項目の元になったインシデントやPRが記録されている。例として「–resumeで古いトランスクリプトを読み込む」という項目があり、セッションの保存形式やメッセージ型が変わったときに、古いトランスクリプトには新しいフィールドがないため安全に読み込めるかを確認する。Claudeは差分を読み、発動条件に合う項目(通常3〜10件)だけをチェックするため、過去の障害を誰も暗記しておく必要がない
- レビュアーは1つ、ラウンドは複数: レビュアーを積み重ねて品質を上げようとはしない。主レビュアーの上に、より高価な2つ目のレビュアーを重ねるより、主レビュアーを調整するほうがよいことが多い。代わりに、そのコードで何に注意すべきかを記したREVIEW.mdを用意する。また各ラウンドは前のラウンドの文脈や過去の失敗を参照し、毎回ゼロから確認し直さないようにする。そのほうが安く、多くの問題を見つけられるという
39項目のチェックリストを「差分で発動する条件付きのルール」として持つやり方は、障害対応の教訓を属人的な記憶から仕組みへ移す方法として、人間中心のチームにも応用しやすいと思います。
Claude Codeチームの検証の考え方③: チェックを守り、段階的に導入する
チェックそのものの信頼性を保つためのルールも示されています。
- 変更は自分を判定するチェックを書き換えられない: 変更が自分を判定するチェックを書き換えられるなら、そのチェックは壊れている。Code ReviewはREVIEW.mdをプルリクエストの変更からではなく、ベースブランチまたはデフォルトブランチから読み込む。Claude Codeチームは、変更をゲートするルールを、その変更から書き換えられないブランチに置いている
- レビューはコミット単位で行う: レビュー中に誰かがプッシュすると、そのレビュー結果は役に立たなくなる。古いコミットに対する合格判定には意味がない
- 安いチェックから実行する: ローカルでテストする前にエージェントがプッシュすると、自分で見つけられたはずのバグのために共有のレビュー時間やCI時間を消費してしまう。チームではClaudeがプルリクエストを開く前にテスト・ビルド・リンターを実行する。これは、Claudeの作業終了時にテストを走らせるフックや、テストスイートの合格を目標とする/goalで強制できる
新しいゲートの導入方法についても具体的です。チームのリポジトリでは、各コミットにどのように検証されたかを示すスタンプを付けており、そこには「none」も含まれるため、検証されていないコミットを検索できます。さらに、セッション内で /code-review または /verify が実行されていない場合にコミットをブロックできるコミットゲートを作り、次の3つのモードを用意しています。
- off: ゲートを無効にする
- observe: ブロックされたはずのものをログに記録するだけにとどめ、誤検知を確認して誰にも影響が出ないことを確かめる
- enforce: コミットをブロックする。検証しなかった理由はコミットメッセージに書けば通せる。また同じセッションで2回ブロックされた場合、次のコミットは通過させ、Claudeが行き詰まらないようにしている(記事は「Claude Codeは完璧ではない」と率直に述べています)
本稿としては、いきなり強制せずobserveモードで誤検知を測ってから切り替える進め方が、開発体験を損なわずにゲートを増やすうえで現実的な手順だと考えています。
Claude Codeチームの検証の考え方④: チェックを評価し、見逃しをルールに変える
チームは「レビュアーをレビューする」ことも定期的に行っています。追跡している指標は次のとおりです。
- マージ後に差し戻された(revertされた)変更の数
- マージ前にメンテナーが却下した変更の数
- 問題が起きていない変更のうち、規模をそろえたサブセット
より正式な評価の例として、Code Reviewチームの取り組みも紹介されています。過去のインシデントやrevertをもとに評価セットを作り、事例ごとにレビュー時点の状態へリポジトリを再現し、バグの内容を1文で示した解答キーを用意します。問題のバグを正しく説明した指摘だけが得点になり、マージ済みで安定している変更を対照群にして過剰な指摘を防ぎます。調整用のデータセットは、システム評価に使う固定のテストセットとは分けています。
さらに、生の指摘、検証後、最終レビューの各段階で再現率(recall)を別々に評価しており、いったん見つけたバグを途中で失っていないかを確認できるようにしています。すべてを一つのE2Eスコアとして扱う評価では、この違いを捉えられないと記事は指摘しています。
正しさに加えて、変更の重要度も重視されています。Code Reviewは指摘にImportant、Nit、Pre-existingのタグを付け、Pre-existingは「もともと存在していたバグについて作者に責任を負わせない」ことを意味します。最後に、チームは再現率を、次の改善が実際のバグ検出ではなく評価セットへの過適合(オーバーフィッティング)になる手前まで調整するとしています。
見逃しをルールに変える方法は2つあります。
- 人間のレビューコメントとrevertからパターンを抽出する: 少なくとも2つのPRで発生し、差分から識別できるものがルール候補になる。3つのエージェントがそのルールの反証を試み、最終的に人がPRでレビュー・承認する
- 既知のインシデントに対応するPRで、3つのバグ検出器を再実行する: 少なくとも2つが見つければ「検出可能なバグ」とみなす。小さな差分なのに見逃した場合、REVIEW.mdのルールにする価値のあるギャップと判断する
flakyなテストも同じ扱いを受けます。Claudeはそれをスキップしたり、sleepを入れたり、通るまでリトライしたりすることはできず、根本原因が見つからなければテストを削除して理由を記録します。また、テストスイートや検証手順、.mdファイルは放っておくと増える一方なので、定期的に整理しているとのことです。
ルールを足すだけでなく削る運用まで明記している点は、CLAUDE.mdが肥大化しがちな現場にとって参考になる部分だと思います。
良いテストが良い結果を生む
記事は最後に、強いフィードバックループで作業を検証できる手段をエージェントに与えることが決定的な違いを生むとまとめています。検証層もほかのシステムと同様に扱い、判定対象の変更から手の届かない場所に置き、自分たちにとって重要だったバグで採点し、見逃したときは教訓を書き留めて二度と起きないようにし、その教訓が実行する価値を保つよう剪定する、というのが結論です。
まとめ
Claude Codeチームは3種類のテストに加え、verifyスキルや差分起点のチェックリスト、段階導入のコミットゲートで検証を仕組み化しています。手元で試したい方は、検証ループをスキル化する方法もあわせてご覧いただければと思います。