はじめに
NVIDIAデベロッパーブログは2026年4月2日、Googleが新たに公開したGemma 4シリーズについての解説記事を公開しました。Gemma 4は4つのモデルで構成され、データセンターからエッジデバイスまで幅広い環境での展開を想定した設計が特徴です。本稿ではその仕様とNVIDIAプラットフォームでの展開方法を紹介します。
参考記事
- タイトル: Bringing AI Closer to the Edge and On-Device with Gemma 4
- 著者: Anu Srivastava
- 発行元: NVIDIA Developer Blog
- 発行日: 2026年4月2日
- URL: https://developer.nvidia.com/blog/bringing-ai-closer-to-the-edge-and-on-device-with-gemma-4/
要点
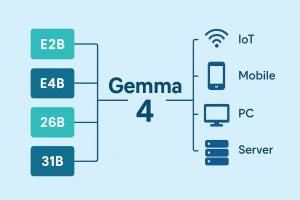
- Gemma 4は31B Dense、26B-A4B MoE、E4B、E2Bの4モデルで構成され、すべて単一のNVIDIA H100 GPUに収まる設計である
- Gemmaシリーズ初となるMoEアーキテクチャを採用した26B-A4Bが登場し、総パラメータ26Bに対してアクティブパラメータ3.8Bで効率的な推論を実現する
- E4B・E2Bはモバイル・エッジ向けの設計で、テキスト・音声・画像・動画を含むマルチモーダル入力に対応する
- DGX Spark・Jetson・RTX GPUの3プラットフォームで動作し、vLLM・Ollama・llama.cppによるローカル展開をサポートする
- NeMo FrameworkによるDay 0ファインチューニング(SFT・LoRA)と、NIMによる本番環境向け自己ホスト展開が可能である
詳細解説
Gemma 4モデルファミリーの概要
Gemma 4は4つのモデルで構成されています。最上位のGemma-4-31Bは310億パラメータのDense Transformerで、256Kトークンのコンテキスト長に対応します。Gemma-4-26B-A4BはGemmaシリーズ初のMoE(Mixture of Experts)アーキテクチャを採用しており、128個のエキスパートを持ちながら推論時のアクティブパラメータは3.8Bに抑えられています。MoEは入力に応じて一部のエキスパートだけを選択的に活性化する手法で、計算効率と性能を両立しやすい設計と考えられます。
モバイル・エッジ向けのGemma-4-E4BとGemma-4-E2Bは、Gemma 3nで初めて導入された設計を引き継いでいます。どちらもテキスト・音声・画像・動画のマルチモーダル入力に対応し、コンテキスト長は128Kトークンです。スライディングウィンドウによるメモリ効率化も備えており、電力制約のある組み込みシステムでの動作を考慮した構成になっています。4モデルはいずれも単一のNVIDIA H100 GPUに収まり、35言語以上に即座対応、140言語以上で事前学習済みという多言語サポートも特徴です。
全モデルはHugging Face上でBF16チェックポイントが公開されており、Gemma-4-31B向けのNVFP4量子化チェックポイントも近日対応予定とされています。ライセンスにはApache 2.0が採用されており、商用利用に適したオープンモデルとして位置づけられています。
NVIDIAプラットフォーム別の展開方法
NVIDIAはGemma 4の展開先として、DGX Spark・Jetson・RTX GPUの3プラットフォームを整備しています。
DGX SparkはGB10 Grace Blackwellスーパーチップと128GBの統合メモリを搭載しており、Gemma-4-31BをBF16の重みで動作させられる計算資源を備えています。vLLM・Ollama・llama.cppに対応しており、セキュアなオンデバイス実行を維持しながらエージェント型AIワークフローの開発・プロトタイピングが可能です。DGX Linux OSとNVIDIAソフトウェアスタックが標準搭載されているため、本番環境に近い開発環境を手元に構築しやすい構成と思います。
Jetsonプラットフォームはロボティクスや産業オートメーションなど、エッジでの物理AIエージェント向けに対応しています。Jetson Orin NanoではGemma-4-E2BおよびE4Bの動作が確認されており、電力制約のある小型組み込みシステムでのマルチモーダル推論が実現します。条件付きパラメータロードやレイヤーごとの埋め込みキャッシュなどのアーキテクチャ上の工夫によって、メモリ使用量の削減と低レイテンシーを両立しています。Jetson Thorまでの同一プラットフォームでスケーラブルに展開できるため、小規模デバイスから高性能エッジシステムへの段階的な移行がしやすい構成と考えられます。
RTX / RTX PRO GPUはデスクトップアプリケーション開発や、趣味・クリエイター用途のローカル推論向けに最適化されています。Ollama・llama.cppによるローカル推論が利用可能で、RTX Pro所有者はvLLMも使用できます。
ファインチューニングと本番展開
NVIDIAはGemma 4に対してDay 0、すなわちモデル公開当日からファインチューニングへの対応を実現しています。NVIDIA NeMo FrameworkのNeMo Automodelライブラリを使用することで、Hugging Faceからのチェックポイントを変換なしに読み込み、SFT(教師あり微調整)とLoRA(低ランク適応)による効率的なカスタマイズが可能です。LoRAはモデル全体を再学習するのではなく、低ランク行列を追加学習するメモリ効率的な手法で、限られたGPUリソースでのドメイン適応に適しています。
本番環境への展開にはNVIDIA NIM(NVIDIA Inference Microservices)が利用できます。NVIDIAのAPIカタログでGemma-4-31BのNIMをプロトタイピング目的で無償試用でき、本番環境向けにはNVIDIA Enterpriseライセンスのもとで安全な自己ホスト型デプロイが提供されています。
まとめ
Gemma 4は4モデル構成でデータセンターからエッジまでをカバーし、NVIDIAの各プラットフォームと緊密に統合されています。Apache 2.0ライセンスとDay 0ファインチューニング対応は、実運用を視野に入れた開発者にとって実用的な選択肢と思います。エッジAIの普及において注目すべき動向と言えます。