はじめに
Google Researchは2026年10月2日、外部から検証できるプライバシー保証を備えた新しい連合学習(Federated Learning)の仕組みを発表しました。信頼できる実行環境(TEE)を使い、学習をサーバー側で行う設計です。本稿では、その仕組みとGboardでの活用を整理します。
参考記事
- タイトル: Toward provably private learning from federated data
- 著者: Katharine Daly(Software Engineer)、Daniel Ramage(Research Director)
- 発行元: Google Research
- 発行日: 2026年10月2日
- URL: https://research.google/blog/toward-provably-private-learning-from-federated-data/
関連記事
要点
- Googleは、TEE(信頼できる実行環境)を使い、データの匿名化を外部から検証・監査できる次世代の連合学習システムを発表した
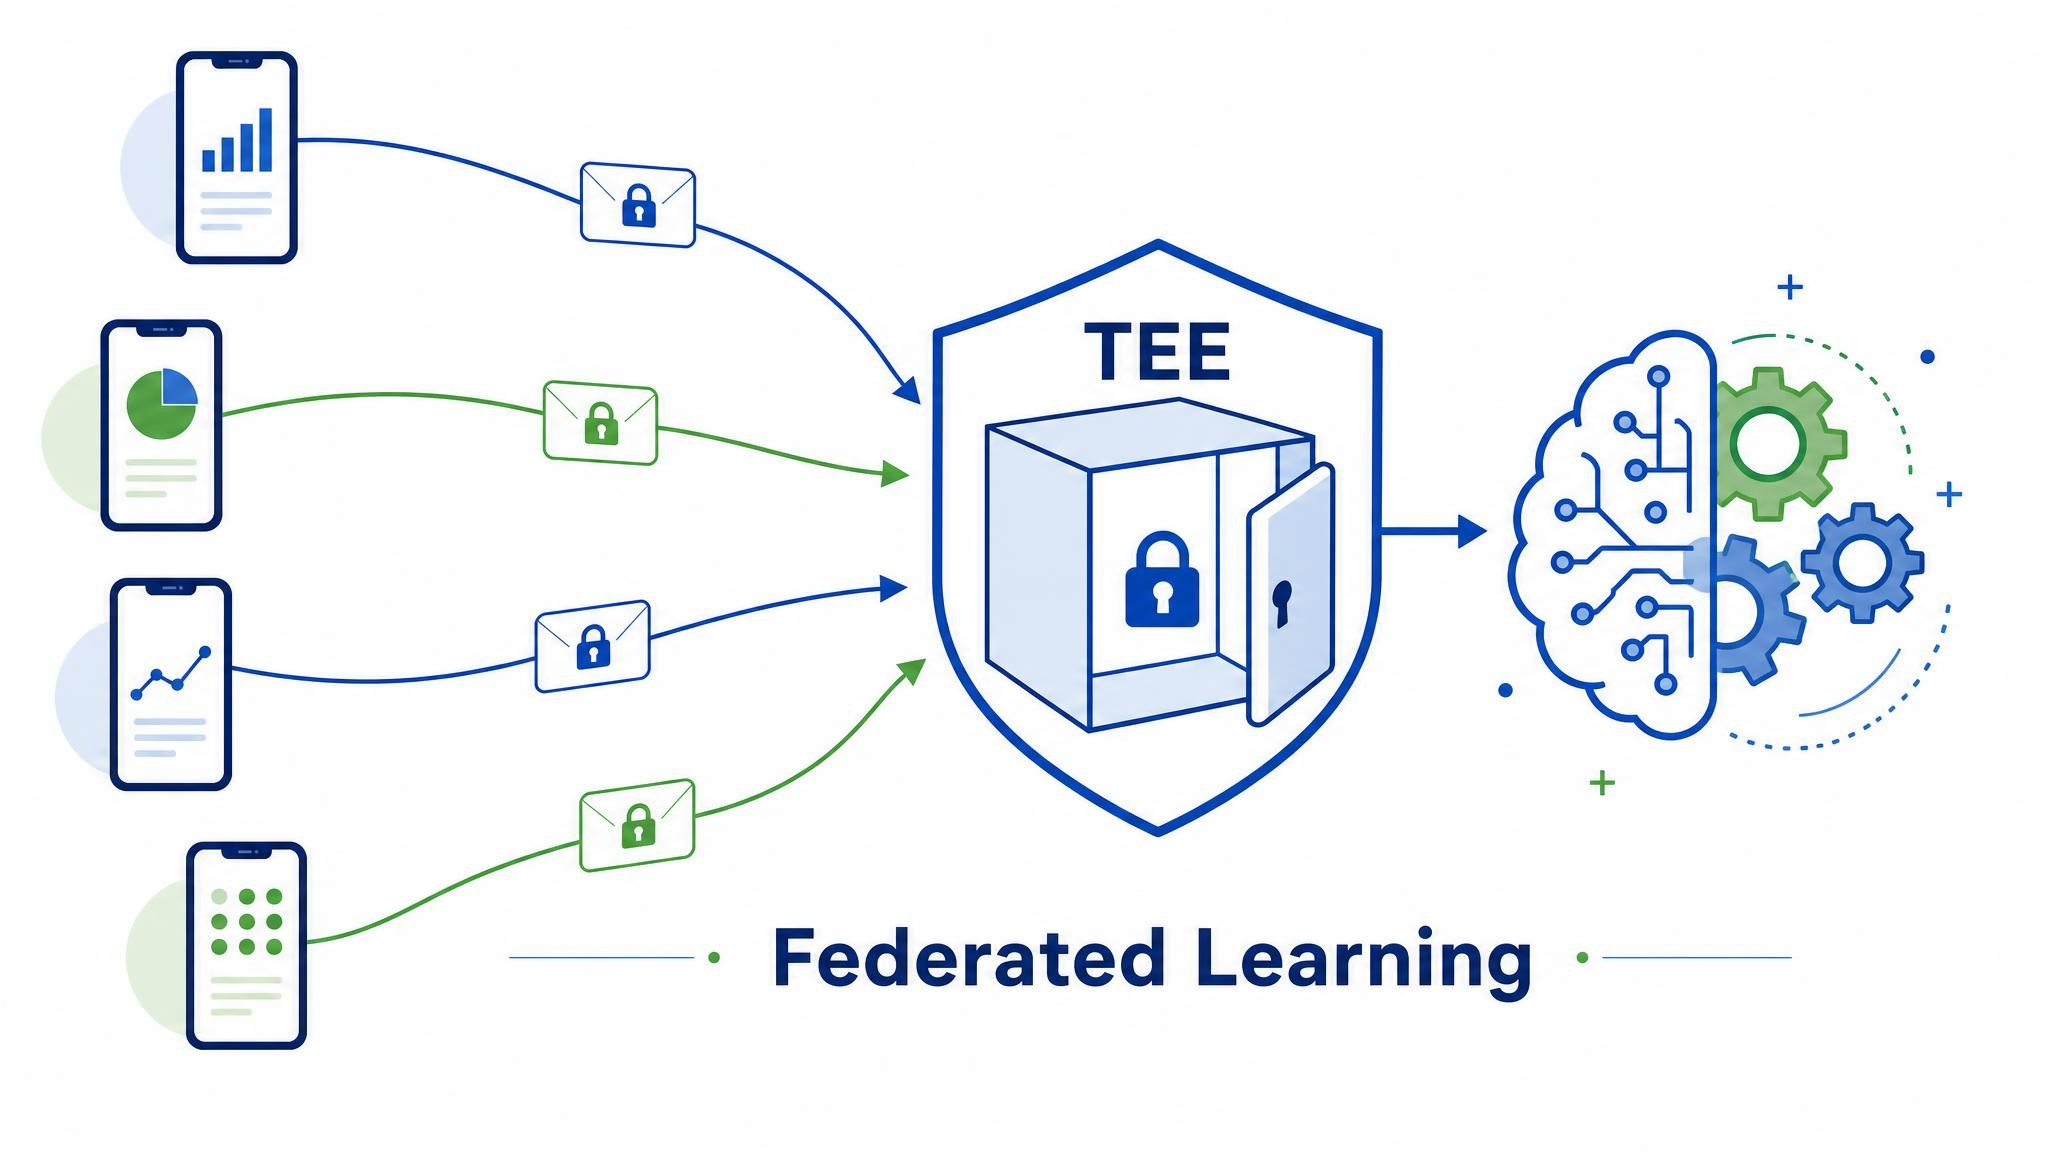
- 端末は学習データを暗号化してアップロードし、そのデータを処理できるTEE上の計算の一覧(アクセスポリシー)を公開の透明性ログで確認できる
- 運用者が見られるのは指標と差分プライバシーを適用したモデルの重みだけで、学習データはTEEの中でしか復号されない
- Gboardはこの仕組みで、英語と日本語の次の単語予測モデルを、より強いプライバシー保証と高い精度で公開した
- 従来1〜2か月かかっていた学習が、サーバー側での並列計算により大幅に速くなったとしている
詳細解説
連合学習のこれまで
連合学習は、データを1か所に集めずに、分散した端末上のプライベートなデータを使ってモデルを学習する機械学習の手法で、Googleが2017年に発表しました。Gboard(Googleのキーボードアプリ)の次の単語予測やスマート作成、Googleメッセージの返信候補、Androidのスマートテキスト選択など、日常的な機能に使われてきました。
Googleによれば、同社の連合学習システムの開発は、次の4つのプライバシー原則に沿って進められています。
- データの最小化
- データの匿名化
- 透明性と利用者による制御
- 検証可能性と監査可能性
匿名化については長年の研究から、MF-DP-FTRLと呼ばれるアルゴリズムや、分散型の差分プライバシーとセキュア集約(Secure Aggregation)の組み合わせによって、本番環境のモデルに強い差分プライバシーの保証を与えてきました。2025年には、これら4原則を中心に連合学習の定義を改め、「サービス提供者の調整のもとで複数の主体(クライアント)が協力して機械学習の問題を解く仕組みであり、クライアントは自らのデータ、そのデータにアクセスできる処理の範囲、それらの処理の匿名化の性質を完全に管理できるべきだ」という趣旨の定義を示しています。
差分プライバシーは、学習結果に適切な雑音(ノイズ)を加えることで、特定の個人のデータが含まれていたかどうかを結果から推測しにくくする手法で、その保護の強さを数学的に示せる点が特徴です。今回の発表は、この「強さを示せる」保護が、サーバー側で本当に正しく行われているかを外部から確かめられるようにする取り組みだと読めます。
TEEで外部から検証できる連合学習へ
今回の論文でGoogleは、TEE(Trusted Execution Environment:信頼できる実行環境)を活用し、データの匿名化を完全に検証・監査できる次世代の連合学習システムを発表しました。TEEの中で動く処理には、次の性質があります。
- リモート認証: 第三者が、実行されている処理の中身を検証できる
- 機密性: 内部の状態を外から観察できない
- 完全性: 処理を外部から妨害できない
ただし、これらは現世代のTEEの制約の範囲内での性質だと注記されています。新しいシステムは、TEEが1台のマシン単位で提供するこうした性質を組み合わせ、端から端まで検証可能な連合学習の仕組みを作り、より強いプライバシー保証と精度の向上を実現したとしています。Gboardはすでにこのシステムを採用し、従来の仕組みより大幅に速い計算時間の恩恵を受けているといいます。
TEEは、CPUなどのハードウェアの中に、OSや管理者からも中身を見られない隔離された領域を作る技術です。本稿としては、「データを預かる側を信頼してください」という約束を、「何が実行されているかを外部の誰でも確かめられる」仕組みに置き換えようとしている点が、この研究の核心だと受け止めています。
システムを構成する4つの要素
このシステムは、以前の「機密性のある連合分析」や「証明可能なプライバシーを伴う分析」の研究で開発された技術を土台にしており、次の4つの要素で動きます。
- データのアップロード: 端末は学習データを手元で暗号化してアップロードする。その際、そのデータを処理してよいTEE上の計算の一覧である「アクセスポリシー」を事前に承認しておく。これらの計算は匿名化された結果しか出力しない。端末は、アクセスポリシーが公開の透明性ログに掲載されていることを条件とする
- 鍵管理システム(KMS)とポリシーの検証: KMSは、RAFT(複数のサーバーで状態をそろえるための合意形成の手順)を実装したTEEのクラスターで構成され、アクセスポリシーに含まれる計算と一致するサーバー側のTEEにだけ復号の鍵を渡す
- 処理の実行: データ処理用のTEEが、学習ループを実装したPythonプログラムを実行する。この「ルート」のTEEは、並列化できる処理をワーカーのTEE群に割り振る。分散処理の記述には、従来の連合学習システムを支えたTensorFlow Federatedから派生した、オープンソースでフレームワークに依存しない記述言語「Federated Language」を使う。学習ループは、匿名化したモデルの重みを定期的にデータ分析者へ出力する
- 障害からの復旧: Pythonプログラムは各学習ラウンドの終わりに、KMSで暗号化した復旧用の状態を保存する。これにより、ルートやワーカーが途中で停止しても、プライバシー上の追加情報を漏らさずに復旧できる
設計の詳細は、ホワイトペーパー「Toward provably private learning from federated data」で公開されています。
鍵を渡す相手を「事前に公開された計算と一致するTEEだけ」に限っている点が、仕組み全体を支える要だと思います。データそのものは暗号化されたままサーバーに置かれていても、承認された処理以外はそれを開けられない、という構造になっていると読めます。
従来の仕組みとの違い
Googleによれば、初期の連合学習では、端末のデータはすぐに集計する目的でアップロードされていましたが、データが記録されたり中身を見られたりしていないことを外部から確かめる方法はありませんでした。その後、セキュア集約によってアップロードを暗号技術で保護できるようになりましたが、最先端の中央型の差分プライバシーの保証とは両立しませんでした。新しいTEEベースのシステムは、サーバーの運用者を信頼する必要を完全になくすという継続的な取り組みの、次の節目だと位置づけられています。
新しいシステムでは、処理の運用者に見えるのは指標と、差分プライバシーを適用したモデルの重みだけです。端末から集めた暗号化された学習データは、アクセスポリシーに示されたPythonの学習プログラムを動かすTEEの中でしか復号・処理できず、それもアップロード後の限られた期間に限られます。
公開の透明性ログと再現可能なビルド
新しいシステムに参加する端末は、アップロードするデータにアクセスしうるサーバー側の処理の全体を把握できます。将来の処理を表すアクセスポリシーは、公開の透明性ログ「Rekor」に掲載され、外部の監査者はこのログを見ることで、端末が参加しうるサーバー側の処理の全体を追跡できます。
また、KMSとデータ処理に使われるプログラムの実行ファイルは、GitHubの「Confidential Federated Compute」リポジトリで公開されたオープンソースのコードから再現可能な形でビルドできます。再現可能なビルドとは、同じソースコードから誰がビルドしても同じ実行ファイルができることを指し、公開されたコードと実際に動いているプログラムが同じであることを第三者が確かめられるようにする仕組みです。
動的な読み込みと検証可能な実行の両立
従来の連合学習システムでは、サーバー上で動く処理を端末も監査者も検証できなかったため、差分プライバシーのために勾配の合計に正しく乱数の雑音を加えていることについて、Googleを信頼してもらう必要がありました。
新しいシステムでは、Rekorに公開されるアクセスポリシーが、連合学習の学習処理を記述したPythonプログラムそのものを直接示します。一方で、独自のモデル構造やデータの前処理の内容は公開できない場合があります。そこでデータ処理用のTEEは、実行時にシリアライズした情報をPythonプログラムに読み込む(サイドロードする)機能に対応しています。プライバシーに関わる処理がすべてPythonプログラムに固定で書き込まれている限り、この仕組みにより、非公開にすべき処理をTEEの中で動かしつつ、外部から検証できる強いプライバシー保証を保てるとされています。
ただし、サイドチャネル(処理時間や消費電力などの副次的な情報から内部を推測する攻撃)への対策は、今後の研究課題として挙げられています。本稿としては、「プライバシーに関わる部分は公開して検証可能に、企業の競争力に関わる部分は非公開のまま」という切り分けは、実用化を考えるうえで現実的な設計だと考えています。
Gboardでの活用
Gboardはこのシステムを導入し、英語と日本語の次の単語予測モデルを、より強いプライバシー保証と高い精度で公開しました。Googleは、改善の要因として次の2点を挙げています。
1つ目は、時間帯による端末の参加状況の偏りの影響を抑えられることです。従来は、端末が充電中でWi-Fiにつながっているときなどに学習に参加するため、昼夜で参加できる端末の数が変わり、学習の進み方に影響していました。新しいシステムでは、サーバー側の学習を始める前に端末からのアップロードをすべて集めておくため、こうした変動を気にする必要がなくなります。実行時には、プログラムの中で最適な端末の参加スケジュールを動的に計算し、それを使って他の差分プライバシーのパラメータも調整できます。Googleは、英語の次の単語予測モデルを、6,500台ずつの端末グループで5,000ラウンド学習させて両システムを比較し、新しいシステムではより強いプライバシー保証や、より小さな雑音での学習が可能になることを示しています。
2つ目は学習の高速化です。従来、こうした連合学習のモデルの学習には1モデルあたり1〜2か月かかることがあり、端末の空き状況、端末上の計算能力、同じ端末群を取り合う複数の学習処理の競合によって進み方が制限されていました。新しいシステムではボトルネックがサーバー側に移り、多数のマシンで並列計算できるようになったため、学習時間を大幅に短縮できたとしています。現在の制約は、使えるTEEの資源の量だけだといいます。
日本語の予測変換は、日本のスマートフォン利用者にとって最も身近なAI機能の1つだと思います。入力の内容は極めて個人的なものであるため、その改善がこうした検証可能なプライバシー保護のもとで行われるようになった点は、国内の利用者にとっても意味のある変化だと受け止めています。
今後の展望
新しいシステムでは、クライアントの勾配の計算がサーバー側に移ったことで、従来の端末の計算資源による制約がなくなりました。Googleは、これが連合学習の手法でより大きなモデルを学習する道を開くとし、TEEとGPUなどのアクセラレーター(計算を高速化する専用ハードウェア)の統合が重要な役割を果たすとしています。
また、このシステムは連合学習の学習処理だけでなく、Pythonで書けるあらゆる処理を検証可能な形で実行できます。Googleは、合成データの生成などの処理をこの基盤で動かす実験を進めているほか、任意のPythonを実行するTEEと、LLMの推論などに特化した別のTEEを組み合わせる方向も探っています。
Googleは、この研究を、サーバー側の処理が個人のプライバシーを守っていることを厳密に証明するための一歩と位置づけています。外部の検証者がGoogleで実行されるコードを正確に確認できることで、データが説明どおりにサーバー側で処理されていることを強く保証できるとしています。今後のTEEのハードウェアと、サイドチャネル対策の研究が、動的に読み込まれる処理をサーバー側の悪意ある攻撃からより深く守ることを期待し、将来的には差分プライバシーのアルゴリズムやシステム部品のソフトウェア実装について、完全な正しさの証明を備えた仕組みも実現しうると見込んでいます。
AIの学習データをめぐっては、企業がどのようにデータを扱っているかを利用者が確かめにくいことが、不信感の一因になってきたと考えられます。本稿としては、「約束」から「検証」へという方向性は、医療や金融など機微なデータを扱う分野でのAI活用にも応用が期待される考え方だと思います。
まとめ
Googleは、TEEと公開の透明性ログを組み合わせ、連合学習のプライバシー保護を外部から検証できる仕組みへと進めました。日本語の予測変換でも実用化が始まっています。Googleのチャットボット分析の仕組み「Urania」もあわせてご覧ください。