はじめに
Edge0-AIが、35Bパラメータ規模のスパースMoE(Mixture of Experts)モデル「Edge0-35b-a3b」のプレビュー版と、推論フレームワーク「edge0」をHugging FaceおよびGitHubで公開しました。本稿では、その仕組みと実装方法を解説します。
参考記事
メイン記事:
- タイトル: Edge0-35b-a3b Preview(モデルカード)
- 著者: wanglamao(Edge0-AI)
- 発行元: Hugging Face
- 発行日: 2026年9月14日
- URL: https://huggingface.co/Edge0/Edge0-35B-A3B-preview
関連情報:
- タイトル: edge0(リポジトリREADME)
- 著者: Edge0-AI
- 発行元: GitHub
- 発行日: 2026年9月14日
- URL: https://github.com/Edge0-AI/edge0
関連記事
要点
- Edge0-35b-a3bは、35Bパラメータ規模のMoEモデルをアクティブメモリ3GiB未満で動作させるプレビュー版である。
- ストリーミング推論フレームワーク「edge0」は、SSDエキスパートオフロード・プレルーター・Recover-LoRAの3つの技術で構成される。
- ベンチマーク平均スコアはfp16版ベースモデル比で3.9ポイントの低下にとどまり、量子化後も精度がおおむね維持されている。
- Mac mini M4 Pro(24GB)上でデコード速度14.9〜17.7 tok/s、プリフィル最大140 tok/sを記録した。
- ライセンスはApache 2.0で、8Bパラメータ規模の「edge0-8b」とあわせて2つのモデルティアが公開されている。
詳細解説
edge0とは何か――3つの技術要素
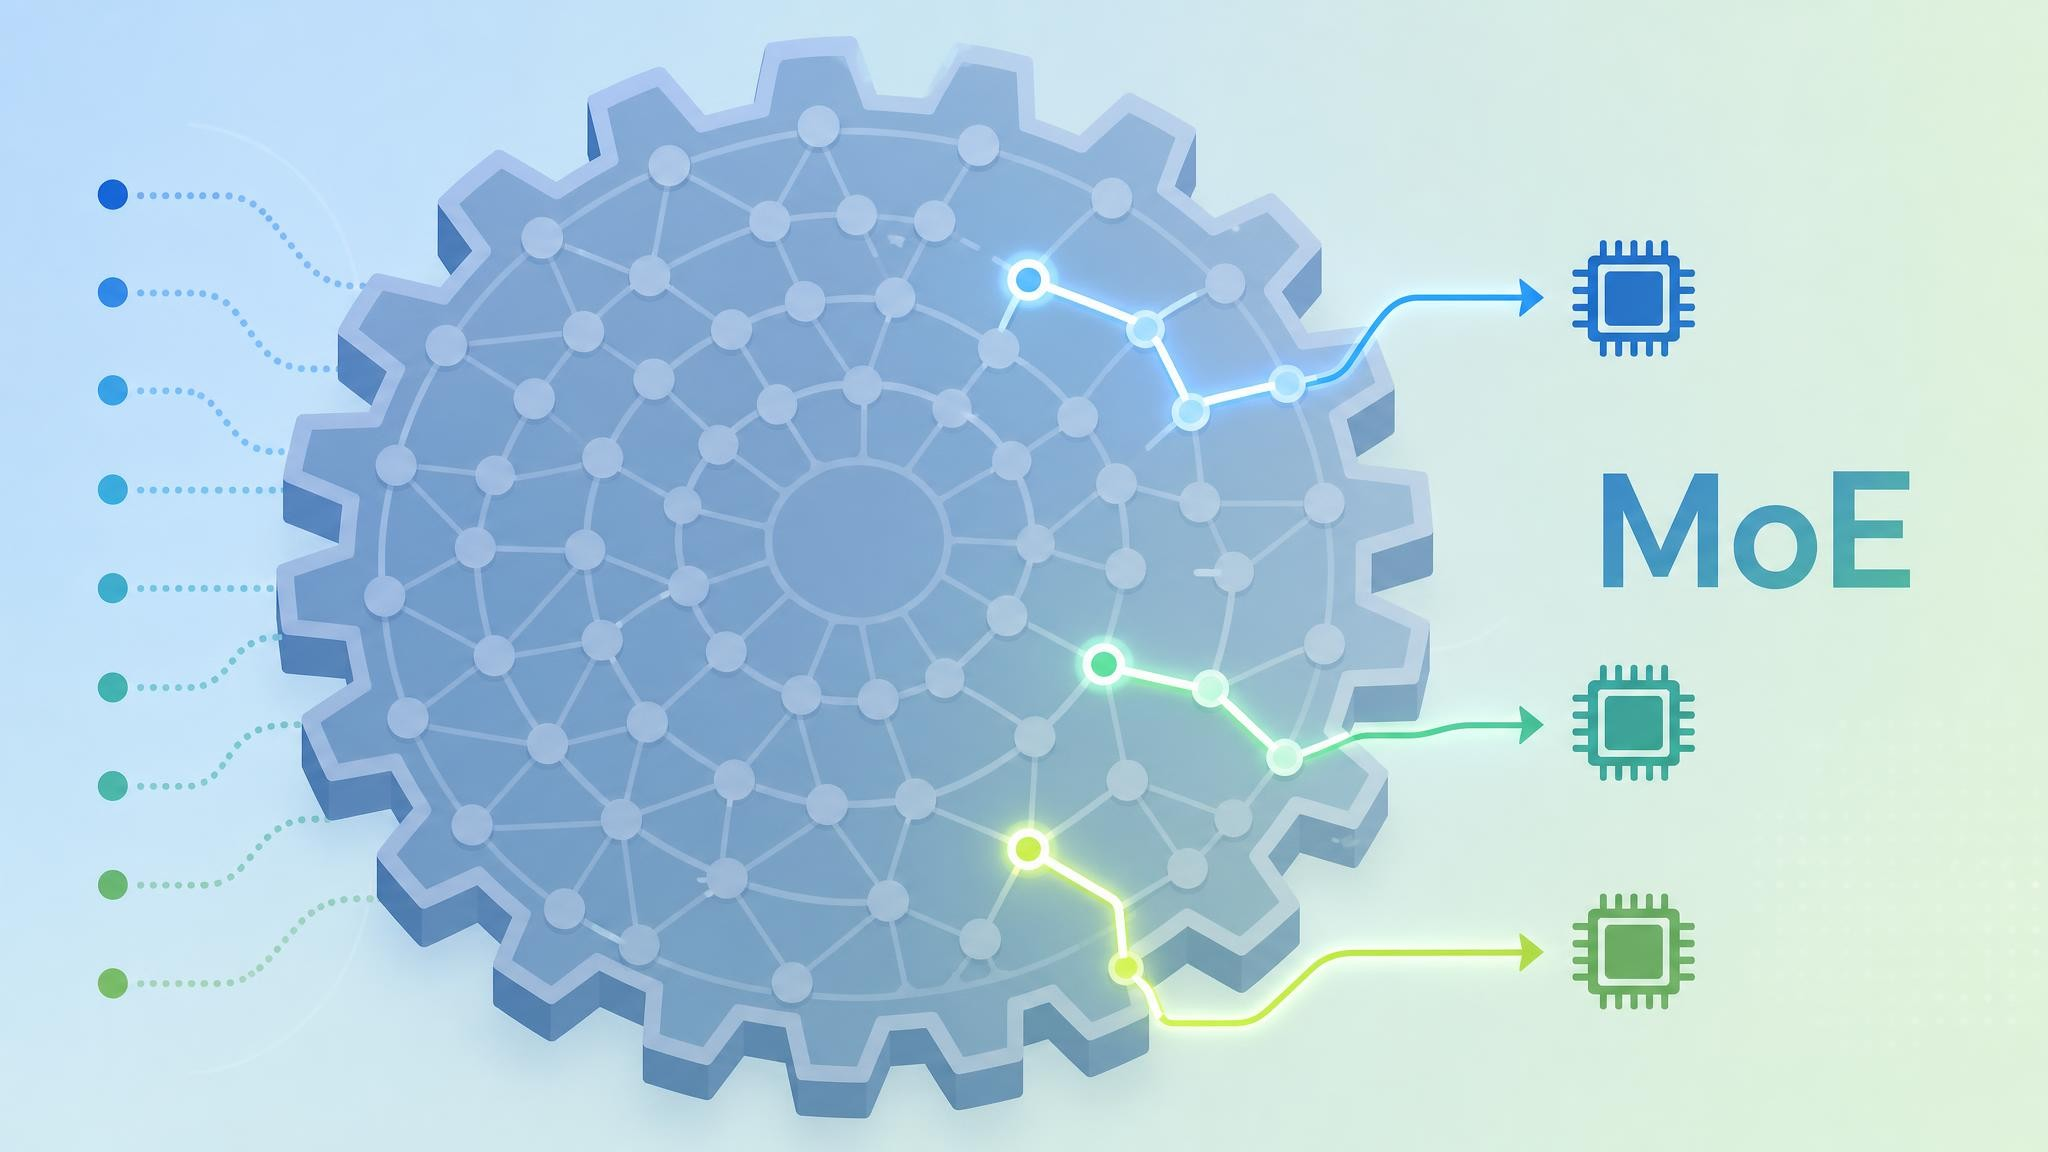
edge0は、GPUのVRAMが限られた環境でも大規模なMoEモデルを動かすためのオープンソース推論フレームワークです。MoEモデルはネットワーク全体を分割した多数の「エキスパート」を持ち、トークンごとにその一部だけを選んで計算するモデル構造ですが、通常は全エキスパートの重みを一度メモリに載せる必要があるため、パラメータ数の割にメモリ消費が大きくなりがちです。edge0はこの前提を変え、実際に使う分のエキスパートだけを都度読み込む方式を採ります。オンデバイスでのMoEモデル実行については、以前にLiquid AIの「LFM2.5-8B-A1B」も取り上げましたが、edge0はこの発想を35B規模のモデルにまで拡張する取り組みと言えます。
中核となるのは次の3つの技術です。
- SSDエキスパートオフロード: 4-bit量子化された重み一式はストレージに置いたままにし、ルーティングされたエキスパートだけをSSD(Solid State Drive)から都度ストリーミングで読み込みます。RAM上に保持するのはアクティブなエキスパートの分だけで、ピークメモリはパラメータ総数ではなくアクティブセットの大きさで決まります。
- プレルーター: どのエキスパートが次に使われるかを1ステップ先読みして予測する、専用に学習されたヘッドです。エキスパートの読み込みをフォワードパスの計算と並行して進められるため、読み込み待ちによる処理の停止を避けられます。Edge0-AIによれば、デコード速度が最大59%向上するとされ、ストレージの読み込み速度・モデルサイズ・ルーティング幅K(1トークンあたりに使うエキスパート数)が大きいほど効果が大きくなります。
- Recover-LoRA: 4-bit化したベースモデルの重みは固定したまま、fp16版モデル(教師モデル)からの蒸留(大きなモデルの出力を小さなモデルに学習させる手法)でLoRA(Low-Rank Adaptation、少量の追加パラメータだけでモデルを再学習する手法)アダプタを学習し、量子化による精度低下を補います。アダプタはベースモデルに統合(マージ)せず別ファイルのまま扱われるため、1つの読み取り専用ベースモデルを複数のアダプタセットで使い回せます。
なお、GitHubリポジトリの設計方針によれば、edge0はtransformers風のAPI(AutoModel / AutoConfig / AutoEngineでモデル名からティアを自動解決)を採用し、MLXバックエンド用のコードはedge0/backends/mlx/以下に隔離されています。コア部分はバックエンドの抽象化レイヤーにのみ依存する設計のため、今後CUDAなど他のバックエンドを追加する際もコア部分の変更は不要とされています。
モデル構成――2つのティア「edge0-35b」と「edge0-8b」
edge0では、パラメータ規模の異なる2つのモデルティアが公開されています。edge0-35bはQwen3.6-35B-A3Bをベースにした40層・256エキスパート構成(1トークンあたり4エキスパートを使用、K=4)で、公開チェックポイントは「Edge0-35B-A3B-preview」です。edge0-8bはLing 3.0 bailing hybridをベースにした24層・128エキスパート構成(K=8)で、チェックポイントは「Edge0-8B-A1B-preview」として公開されています。いずれもベースチェックポイント本体に加え、学習済みのLoRAアダプタとプレルーターヘッドが同じディレクトリに同梱されており、ダウンロードすればそのまま動作する状態になっています。
4-bit量子化後のディスク使用量は、edge0-35bが約23GB、edge0-8bが約4.2GBです。エキスパートの重みはメモリマップ(mmap、ファイルをメモリ空間に直接割り当てて読み込む仕組み)され必要な分だけ読み込まれるため、この容量がそのままRAM使用量になるわけではありません。
精度――量子化後の性能はどこまで維持されるか
Edge0-AIは、OpenCompass(オープンソースの評価ベンチマークツール)を使い、4-bit量子化したedge0モデルと元のfp16版ベースモデルを同一条件で比較したベンチマーク結果を公開しています。edge0-35b(int4)はAIME 2026で86.6点(fp16版のQwen3.6-35B-A3Bは92.7点)、HumanEvalで90.9点(同95.1点)、GPQA-Diamondで79.8点(同81.8点)、MMLU-Proで81.0点(同84.6点)、IFBenchで57.9点(同61.7点)を記録し、5項目平均は79.2点(同83.2点)でした。edge0-8b(int4)は同様に平均69.9点(fp16版のLing 3.0 tinyは72.7点)で、MMLU-Proに限ってはfp16版を上回っています。
平均スコアの低下幅はedge0-35bで3.9ポイント、edge0-8bで2.8ポイントです。一般的に4-bit量子化はモデルサイズを1/4程度に圧縮できる一方で一定の精度低下を伴いますが、この幅であればタスクによっては実用上大きな差にならない範囲だと考えられます。ただし前述の通りMMLU-Proのように差が縮む、あるいは逆転する項目もあり、用途に応じたベンチマークでの事前確認が望ましいと本稿としては考えています。
速度とメモリ――実機でのベンチマーク結果
性能測定はMac mini M4 Pro(メモリ24GB)上で実施されています。edge0-35bはデコード速度14.9〜17.7 tok/s、プリフィル(プロンプトの事前処理)スループットがコールド時113 tok/s・ウォーム時140 tok/s、ピークアクティブメモリは2.9GiBでした。edge0-8bはデコード速度23.9〜25.3 tok/s、プリフィルがコールド時500 tok/s・ウォーム時1428 tok/s、ピークアクティブメモリは1.0GiBです。ここでいう「コールド」はプロセス起動後の最初のリクエスト(エキスパートの重みがSSDから読み込まれる状態)、「ウォーム」は2回目以降のリクエスト(OSのページキャッシュに重みが乗っている状態)を指し、プリフィルの数値は約3,300トークンのプロンプトに対する処理速度です。
15 tok/s前後のデコード速度は、対話用途としては違和感なく読める速さの目安になる水準と本稿としては受け止めています。一方で長いコンテキストを扱うとKVキャッシュ(Key-Valueキャッシュ、Transformerモデルが過去のトークンの計算結果を保持しておく仕組み)が増大し、ピークメモリが3GiBから膨らむ点には注意が必要です。
動作要件・環境構築
edge0を利用する前に、以下の要件を確認しておく必要があります。
- OS・ハードウェア: 現時点のMLXバックエンドはApple Silicon(M1/M2/M3/M4)搭載のmacOS専用です。CUDAバックエンドは開発ロードマップに載っていますが、現時点では未対応です。
- Python: 3.10以上(3.12推奨)。
- MLX: mlx==0.30.6、mlx-metal==0.30.6、mlx-lm==0.31.0の組み合わせが指定されています。Apple A18 / A18 Proチップでは新しいバージョンのmlxだと出力が文字化けする不具合が報告されており、その場合はpip install ‘mlx==0.30.6’ ‘mlx-metal==0.30.6’のようにバージョンを固定する必要があります。
- メモリ: 短いコンテキストであればedge0-35bで約2.9GB、edge0-8bで約1.0GBのピークアクティブメモリです。OSやトークナイザ、長いコンテキストによるKVキャッシュ増加分の余裕も見込んでおく必要があります。
- ディスク: 4-bit版チェックポイントはedge0-35bが約23GB、edge0-8bが約4.2GBです。
注意: Apple Silicon以外の環境(Intel Mac、Windows、Linux)では現時点のMLXバックエンドは動作しません。
インストールとモデルのダウンロード
まず、現在インストールされているPythonのバージョンを確認します。
# インストール済みのPythonのバージョンを表示するコマンドです
python3 --version
3.10以上であることを確認できたら、仮想環境(venv、システム全体のPython環境を汚さずにパッケージを分離してインストールする仕組み)を作成し、そこにedge0をインストールします。仮想環境を使うのは、他のプロジェクトのパッケージと依存関係が衝突するのを避けるためです。
# 仮想環境を作成し、その中でedge0を依存パッケージ込みでインストールします
python3.12 -m venv .venv && .venv/bin/pip install -e '.[dev,fetch]'
次にモデル本体をダウンロードします。同梱のヘルパースクリプトを使う方法と、Hugging Face CLIを直接使う方法の2通りが用意されています。
# 同梱スクリプトでedge0-35bをダウンロードする場合
.venv/bin/python scripts/fetch_models.py --tier edge0-35b --target-dir models

# Hugging Face CLIで直接ダウンロードする場合(結果は同じです)
.venv/bin/huggingface-cli download Edge0/Edge0-35B-A3B-preview --local-dir models/edge0-35b
注意: edge0-35bのダウンロードには約23GBのディスク空き容量が必要です。ダウンロード先のストレージに十分な空き容量があるか事前に確認してください。
ダウンロードが完了すると、以下のようなディレクトリ構成になります。
models/edge0-35b/
├── config.json, model-*.safetensors, tokenizer files   # ベースチェックポイント本体
├── lora_edge0_35b.safetensors          # 学習済みLoRAアダプタ
└── prerouter_edge0_35b.safetensors     # 学習済みプレルーターヘッド
LoRAとプレルーターのアダプタファイルはベースモデルと同じディレクトリに置かれていれば自動的に読み込まれるため、追加の設定作業は不要です。
実行方法――チャット・API・Python
モデルの場所は環境変数で指定する方法と、ディレクトリを直接指定する方法の2通りがあります。
# 環境変数でモデルディレクトリを指定する場合
export EDGE0_35B_MODEL=$PWD/models/edge0-35b
# 環境変数を使わず、ディレクトリを直接指定して起動する場合
# (config.jsonの内容から自動でティアが判定されます)
edge0 demo models/edge0-35b準備ができたら、以下のコマンドで動作を確認できます。
# 簡易デモを実行し、対話的に動作を確認するコマンドです
edge0 demo edge0-35b
# OpenAI互換のHTTP APIサーバーとして起動するコマンドです
edge0 serve edge0-35b# サーバー起動後、curlでチャット補完エンドポイントを叩く例です
curl http://127.0.0.1:8000/v1/chat/completions \
-H 'Content-Type: application/json' \
-d '{"messages":[{"role":"user","content":"Hello!"}],"max_tokens":32}' なお、Hugging Face上のモデルカードではedge0 serve --name edge0-35b --port 8085のように--portオプションでポート番号を明示的に指定する例も示されています。ポート番号を変えたい場合はこのオプションを使います。
ワンショットでの応答生成にはedge0 chatが使えます。--max-newで生成トークン数の上限を、--show-thinkingでモデルの思考過程(reasoningブロック)の表示も指定できます。
# ワンショットでプロンプトへの応答を生成するコマンドです
edge0 chat edge0-35b --prompt "Explain streaming inference in one sentence."
Pythonから直接呼び出すこともできます。
from edge0 import AutoEngine
from edge0.server.chat import ChatMessage, ChatRequest, ChatSession

# モデルディレクトリからエンジンを読み込みます(ティアはconfig.jsonから自動判定されます)
engine = AutoEngine.from_pretrained("/path/to/model")

req = ChatRequest(
    model=engine.name,
    messages=[ChatMessage(role="user", content="Hello!")],
    max_tokens=64,
)
tokens, meta = ChatSession(engine, req).run()
print(engine._tok.decode(tokens))

# mmapしていたファイルとエキスパートキャッシュを解放します
engine.close()
注意: 参考記事のサンプルコードをもとにしていますが、本稿の環境で動作確認をしたものではありません。実行環境やライブラリのバージョンによっては挙動が変わる可能性があります。
想定用途と現時点での制限
Edge0-AIは、想定される利用シーンとして次を挙げています。
- GPUのVRAMが限られる一方でストレージが高速な環境(NVMeや内蔵フラッシュ)でのエッジ・オンデバイス推論
- 1台の一般的なマシン上でのバッチサービング。1つの読み取り専用ベースモデルを、再量子化なしに複数のLoRAアダプタセットで使い回せる
- 同梱のチャットテンプレートでthinkingモードを有効にした、多言語での対話・推論用途
一方で、次の制限も明記されています。
- プレビューリリースであり、対応範囲・品質は今後拡張される予定で、現状は主にベースモデルの対応言語向けにチューニングされている
- エージェント用途(ツール利用、複数ステップの計画、長時間にわたる自律動作)への最適化はまだ弱く、正式版でこの点を大きく強化する予定とされている
- MLXバックエンドは現状Apple Silicon向けのみで、他のバックエンドは開発ロードマップの段階
- 長いコンテキストはKVキャッシュを増大させるため、メモリを3GiB程度に保つには短めのコンテキストで使う必要がある
想定用途と現時点での制限
Edge0-AIは、想定される利用シーンとして次を挙げています。
- GPUのVRAMが限られる一方でストレージが高速な環境(NVMeや内蔵フラッシュ)でのエッジ・オンデバイス推論
- 1台の一般的なマシン上でのバッチサービング。1つの読み取り専用ベースモデルを、再量子化なしに複数のLoRAアダプタセットで使い回せる
- 同梱のチャットテンプレートでthinkingモードを有効にした、多言語での対話・推論用途
一方で、次の制限も明記されています。
- プレビューリリースであり、対応範囲・品質は今後拡張される予定で、現状は主にベースモデルの対応言語向けにチューニングされている
- エージェント用途(ツール利用、複数ステップの計画、長時間にわたる自律動作)への最適化はまだ弱く、正式版でこの点を大きく強化する予定とされている
- MLXバックエンドは現状Apple Silicon向けのみで、他のバックエンドは開発ロードマップの段階
- 長いコンテキストはKVキャッシュを増大させるため、メモリを3GiB程度に保つには短めのコンテキストで使う必要がある
まとめ
edge0は、SSDエキスパートオフロード・プレルーター・Recover-LoRAの3技術を組み合わせ、35B規模のMoEモデルを3GiB未満のメモリで動かすフレームワークです。量子化技術についてはBonsai 27Bの1bit/ternary量子化も解説していますので、あわせてご覧ください。