はじめに
NVIDIAが2026年10月30日、技術ブログでTensorRT Edge-LLMの入門チュートリアルを公開しました。64GB構成のDGX Spark上で、trtedge CLIを使ってNemotron-3.5 Lightningを動かす内容です。この記事では、導入手順と高速化の方法、性能を整理します。
参考記事
- タイトル: Run AI Models for Edge Application Development with Just a Few Commands
- 著者: Joe Halabi, Lin Chai, Maximilien Breughe, Michael Ferry, Charlotte Mallo
- 発行元: NVIDIA Technical Blog
- 発行日: 2026年10月30日
- URL: https://developer.nvidia.com/blog/run-ai-models-for-edge-application-development-with-just-a-few-commands/
要点
- TensorRT Edge-LLMは、DGX Sparkでの開発とJetson Thorなどへの展開で共通に使える軽量なC++推論ランタイムである
- trtedge CLIはモデル取得とTensorRTエンジン構築を担い、数コマンドでNemotron-3.5 Lightningとのチャットを始められる
- `trtedge serve` により、ローカルのOpenAI互換APIサーバーを立てられる
- NVIDIAの計測では、DSpark有効時にHumanEvalの平均生成速度が毎秒73.4から126.9トークンに向上した
- 同条件でのピークメモリ使用量は、OSを含めて27.9GBである
詳細解説
TensorRT Edge-LLMとDGX Spark 64GBの役割
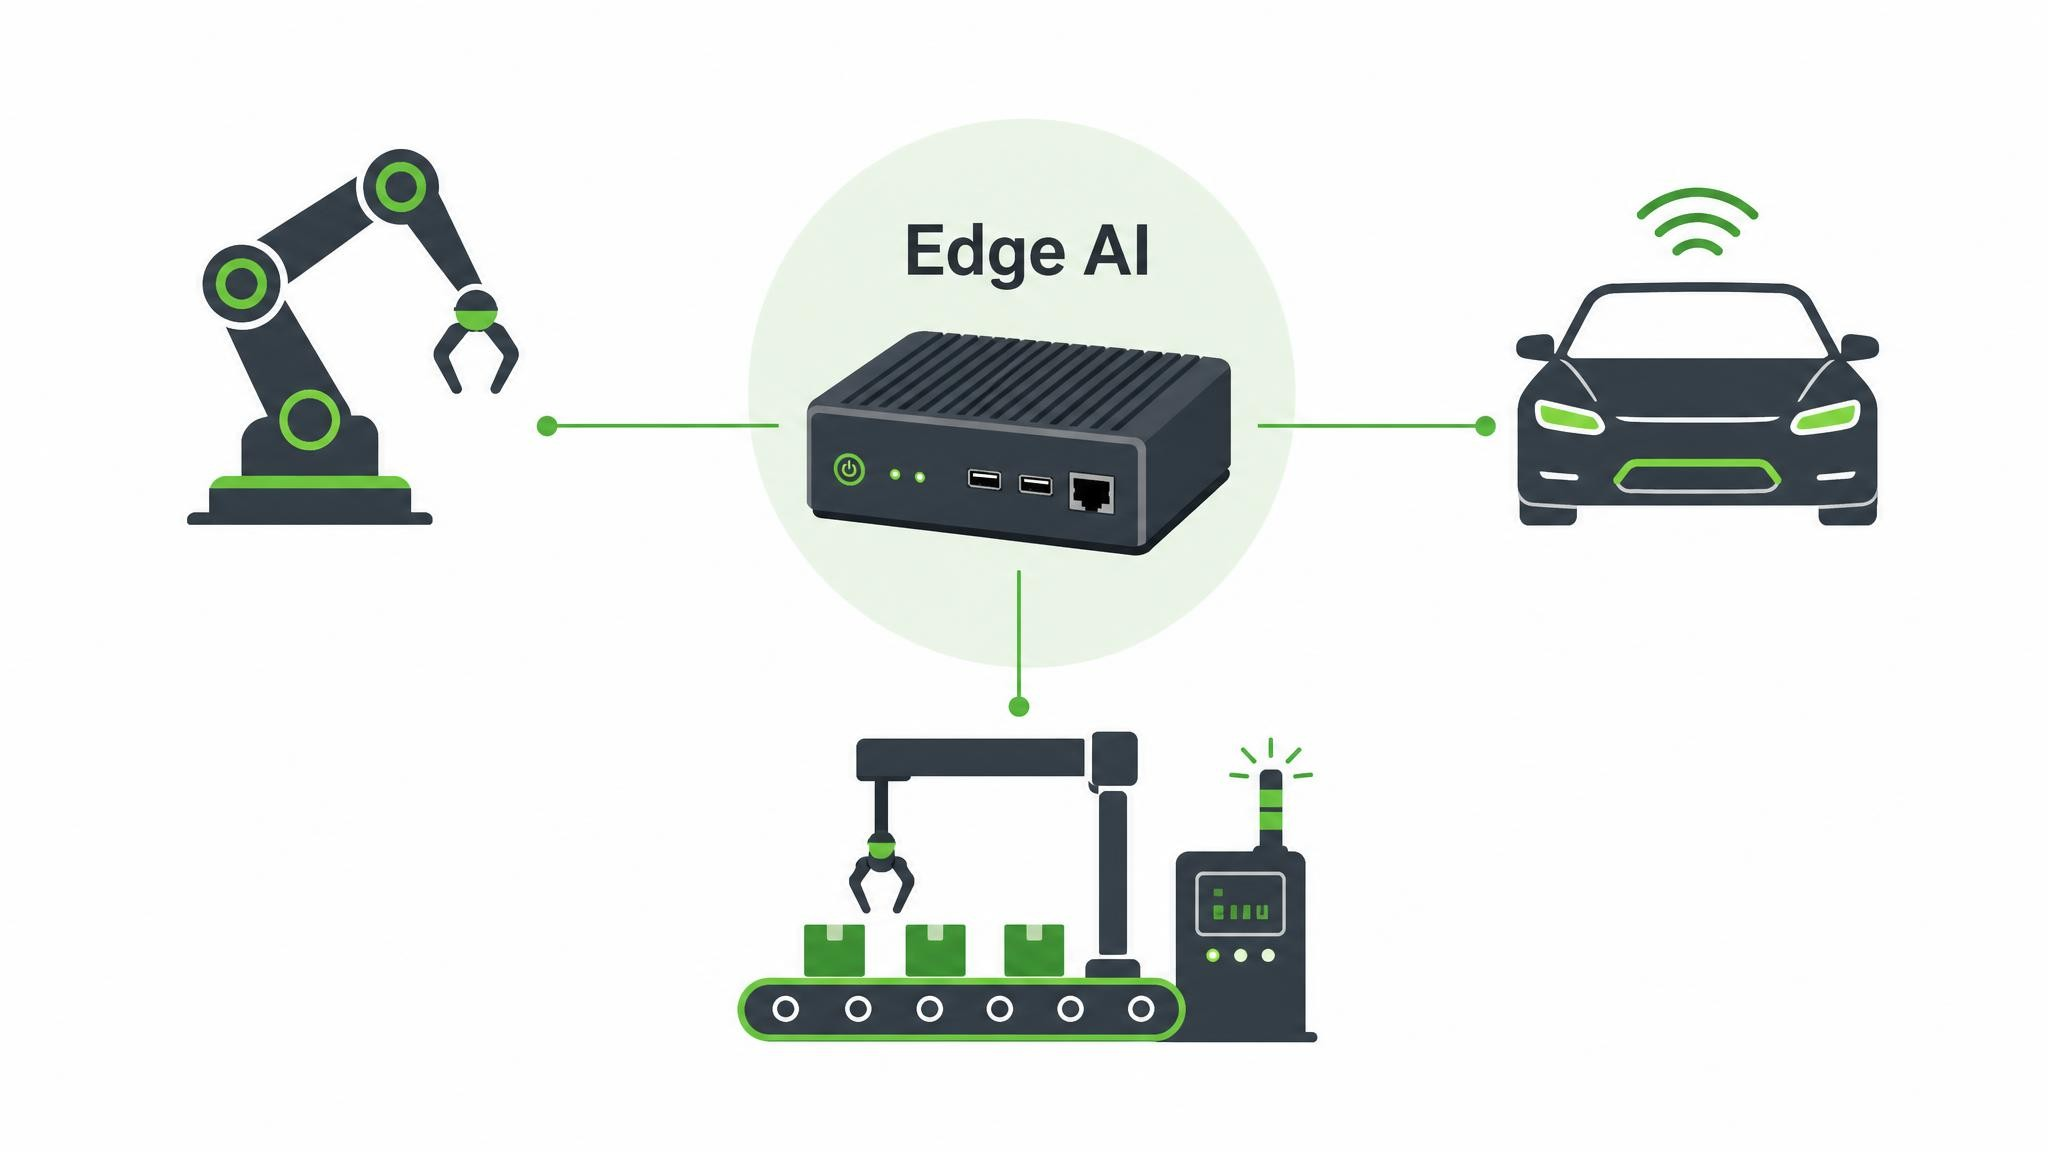
NVIDIAによると、AIの活用はデータセンターの外へ広がっています。具体例として挙げられているのは、次のようなエッジ(現場の機器側)で動くエージェントです。
- 車内でドライバーの注意状態や室内の状況を見守る
- ロボットが周囲を理解し、作業を計画する
- 生産ラインで複数の機械を連携させる
こうしたフィジカルAI(現実世界で知覚・判断・行動するAI)は、メモリ、電力、遅延の厳しい制約の中で動く必要があります。一方で、モデルを動く状態にするまでの準備には手間がかかります。
そこで示されたのが、64GB構成が加わったDGX Sparkと、TensorRT Edge-LLMの組み合わせです。DGX Sparkは、組み込み開発者がモデルやエージェントを試作・ファインチューニング・テストする場とされています。
TensorRT Edge-LLMは、組み込み向けに設計された軽量なC++推論ランタイムです。Sparkでの開発と、次のプラットフォームへの展開で同じ推論フレームワークを使えます。
- NVIDIA Jetson Thor
- NVIDIA DRIVE AGX Thor
- NVIDIA IGX Thor
TensorRTは、学習済みモデルをNVIDIA GPU向けに最適化して推論するSDKです。最適化済みのモデルは「エンジン」と呼ばれ、実行環境や設定に合わせて構築されます。開発機と展開先で同じランタイムを使えるため、Sparkは実機に載せる前の検証環境という位置づけです。
trtedge CLIで変わる始め方
入口となるのが、trtedgeというCLI(コマンドラインインターフェース)です。選んだモデルのダウンロードから、Spark向けに最適化したTensorRTエンジンの構築までを担います。
チュートリアルでは、テキスト専用モデルのNVIDIA Nemotron-3.5 Lightningを題材に、次の3つを試します。
- ターミナルでプロンプトを試すチャット(`trtedge chat`)
- アプリ試作用のOpenAI互換APIサーバー(`trtedge serve`)
- DSpark投機的デコーディングによる生成の高速化
使うモデルIDは `nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4` です。NVFP4はNVIDIAの4ビット浮動小数点形式で、重みを小さく保ってメモリ消費を抑えます。「30B-A3B」は、総パラメータ300億のうち約30億が推論時に働く構成を示す表記とみられます。
OpenAI互換APIは、OpenAIのAPIと同じリクエスト形式で呼び出せるAPIです。OpenAI向けに書いたクライアントやライブラリを、接続先を変えるだけで試せる点が利点です。
前提条件
NVIDIAが示す前提条件は次のとおりです。
- サポート対象のNVIDIAソフトウェアスタックを備えたDGX Spark
- NVIDIA CUDA 13
- TensorRT 10.16.1.11以降(10.x系の範囲内)
- Python 3.10〜3.12
手順は、TensorRT Edge-LLM 0.11.1とTensorRT 10.16.1.11の組み合わせでテストされています。TensorRTは10.x系に限られ、11系は対象外です。
インストールと動作確認
DGX Sparkでターミナルを開き、仮想環境を作ってからTensorRT Edge-LLMを入れます。以下はNVIDIAが示すコマンドで、各行の役割は次のとおりです。
- `python3 -m venv –system-site-packages .venv-edgellm` で仮想環境を作成します
- `source` で仮想環境を有効化します
- pipを最新版に更新します
- サーバー機能付きでTensorRT Edge-LLM 0.11.1をインストールします
python3 -m venv --system-site-packages .venv-edgellm
source .venv-edgellm /bin/activate
python -m pip install --upgrade pip
python -m pip install "tensorrt-edgellm[server]==0.11.1"
注意: 2行目はパスの途中に空白が入っています。作成した仮想環境を有効化する行なので、実行時は空白を詰めた `.venv-edgellm/bin/activate` になるとみられます。
`–system-site-packages` を付けた仮想環境では、新しく入れるパッケージを分けて管理できます。それでいて、TensorRTを含むシステムのPythonパッケージも参照できます。
`[server]` は、pipのextras(追加の依存関係グループ)を指定する書き方です。APIサーバー機能に必要なパッケージも一緒に入るとみられます。
次に、TensorRTのバージョンを確認し、TensorRT Edge-LLMのランタイムが読み込めるかを確かめます。10.16.1.11以上かつ11未満でなければエラーを出し、条件を満たせば `runtime.load()` を実行する1行のコマンドです。
python -c "import tensorrt as trt; v = tuple(map(int, trt.__version__.split('.'))); assert (10, 16, 1, 11) <= v < (11,), f'TensorRT >=10.16.1.11 and <11 required; found {trt.__version__}'; from tensorrt_edgellm import runtime; runtime.load()"注意: 互換性のあるシステムのTensorRTバインディングがない場合は、NVIDIAのTensorRT pipインストール手順に従います。有効化した仮想環境に10.x系の互換版を入れてから、確認コマンドを再実行してください。
ターミナルでチャットする
仮想環境を有効にしたまま、`trtedge chat` の後にモデルID(`nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4`)を指定して起動します。
初回は、約21GBのモデルのダウンロードとエンジン構築が終わるまで待ちます。ファイルは既定で `~/.cache/tensorrt-edgellm` に保存されるため、モデルとエンジンの両方を置ける空き容量が必要です。2回目以降は、条件が一致するキャッシュ済みエンジンが再利用されます。
プロンプトが表示されたら、例として「Convert 25°C to Fahrenheit. Answer in one sentence.」と入力します。摂氏25度を華氏に変換し、1文で答えるよう求める質問です。応答例は「25°C is equal to 77°F.」です。
そのまま追加の質問を続けられ、`/exit` と入力するとセッションを終了します。初回起動はエンジン構築を伴うため、検証の時間には余裕を持たせるのが良さそうです。
OpenAI互換APIとして公開する
アプリの開発やテストには、Spark上にローカルのOpenAI互換APIを立てます。仮想環境を有効にした状態で、次のコマンドでサーバーを起動します。
trtedge serve nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4 \
--host 127.0.0.1 \
--port 8000
サーバーは、この構成に対応するエンジンを構築するか、既存のものを再利用します。`127.0.0.1` は自分自身を指すアドレスなので、この設定では同じマシンからのみ接続できます。
起動が終わったら、DGX Sparkで2つ目のターミナルを開き、サーバーの準備ができたかを確認します。
curl -fsS http://127.0.0.1:8000/health/ready
応答に `”status”:”ready”` が含まれていれば準備完了です。最初のプロンプトは、チャット補完の `/v1/chat/completions` エンドポイントへ送ります。リクエスト本文の主な項目は次のとおりです。
- `model`: `nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4`
- `messages`: `role` が `user`、`content` がチャットと同じ温度変換の質問
- `stream`: `true`(応答を逐次受け取る)
- `temperature`: `0`(出力のばらつきを抑える)
- `max_tokens`: `128`(出力の上限トークン数)
応答はJSONイベントとしてストリーミングされます。サーバーは起動したまま追加のリクエストを受け付け、止めるときはサーバー側のターミナルでCtrl+Cを押します。curlコマンドの全文は元記事を参照してください。
別の端末から接続するには `–host` の変更が必要です。その場合は、APIに誰がアクセスできるかの管理にも気を配る必要があります。
DSpark投機的デコーディングで高速化する
投機的デコーディング(speculative decoding)は、生成を速くするための手法です。ドラフトモデルが複数のトークンを先に提案し、メインモデルが1回の処理でまとめて検証します。
ドラフトトークン3個で有効にするには、サーバーのターミナルでCtrl+Cを押して止めます。そのうえで、DSparkを有効にしてサーバーを再起動します。
trtedge serve nvidia /NVIDIA-Nemotron-3 .5-Lightning-30B-A3B-NVFP4 \
--host 127.0.0.1 \
--port 8000 \
--speculative-config '{
"method" : "dspark" ,
"model" : "nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4-DSpark" ,
"num_speculative_tokens" : 3
}'
注意: 1行目のモデルIDは途中に空白を含んでいます。正しいIDは前述の `nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4` なので、実行時は空白を詰める必要があるとみられます。
`–speculative-config` で渡すJSONの項目は次のとおりです。
- `method`: `dspark`(DSparkを使う指定)
- `model`: `nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4-DSpark`(ドラフトモデル)
- `num_speculative_tokens`: `3`(1回に提案させるトークン数)
サーバーの準備ができたら、同じエンドポイントへプロンプトを送ると、DSpark有効時の生成を試せます。`num_speculative_tokens` などの設定はワークロードに合わせて調整できます。詳しくはTensorRT Edge-LLMの投機的デコーディングのドキュメントにまとまっています。
提案トークンを増やすほど速くなるとは限りません。ドラフトの予測が外れると検証の手間が無駄になるため、用途ごとに値を比べるのが良さそうです。
DGX Spark 64GBでの性能
NVIDIAは、DGX Spark 64GB上のNemotron-3.5 Lightningについて、最初のトークンが返るまでの時間(TTFT)と生成速度を公表しています。生成速度は、TTFTを除いたリクエストあたりの平均トークン生成速度です。
DSparkなしの結果は次のとおりです。
- SpeedBench 1K: TTFT中央値201.0ms、平均生成速度は毎秒73.3トークン
- SpeedBench 2K: TTFT中央値329.5ms、平均生成速度は毎秒72.8トークン
- HumanEvalのプロンプト: TTFT中央値98.1ms、平均生成速度は毎秒73.4トークン
DSparkあり(ドラフトトークン3個)の結果は次のとおりです。
- SpeedBench 1K: TTFT中央値203.0ms、平均生成速度は毎秒108.5トークン
- SpeedBench 2K: TTFT中央値331.6ms、平均生成速度は毎秒105.3トークン
- HumanEvalのプロンプト: TTFT中央値98.7ms、平均生成速度は毎秒126.9トークン
DSpark有効時の推論中のピークメモリ使用量は、OSを含むシステム全体で27.9GBでした。計測条件は次のとおりです。
- DGX OS 7.6.0(Ubuntu 24.04.4 LTS)
- NVFP4を使用し、思考(thinking)を有効化
- バッチサイズ1、同時ストリーミングリクエスト1件
- 出力上限128トークン
- 平均入力長はSpeedBench 1Kが1,153トークン、SpeedBench 2Kが2,247トークン、HumanEvalが139トークン
数値を割り算すると、DSparkによる生成速度の向上はSpeedBenchで約1.4〜1.5倍、HumanEvalで約1.7倍です。TTFTはほぼ変わらないため、改善するのは書き出し後の生成の速さです。
HumanEvalで伸びが大きいのは、コードのように続きを予測しやすい出力でドラフトが当たりやすいためとみられます。
ただし、計測は1リクエストずつ、出力128トークンという条件です。複数人での同時利用や長い出力では、同じ数値になるとは限りません。27.9GBというメモリ使用量も、この条件での値です。
導入時の注意点
ここまでの手順を試す前に、次の点を押さえておくと手戻りを減らせます。
- ストレージ: 初回に約21GBのモデルを取得し、エンジンも `~/.cache/tensorrt-edgellm` に保存される
- バージョン: TensorRTは10.16.1.11以上かつ11未満、Pythonは3.10〜3.12、CUDAは13が前提
- コマンドの空白: 仮想環境の有効化とDSpark起動のコマンドは、パスやモデルIDの空白を詰めて実行する
- 接続範囲: `127.0.0.1` での起動は同じマシンからの利用に限られる
- 展開先: Thor系でのモデル別ワークフローや要件は、プラットフォームごとにドキュメントで確認する
DGX Spark 64GB構成の提供開始は、NVIDIAの別の発表で案内されています。購入や導入を検討する場合は、提供条件をそちらで確認してください。
次に試せること
NVIDIAは、次のステップとして以下を挙げています。
- 対応モデル一覧から別のモデルを試し、Spark上でアプリ開発を続ける。画像や動画を解釈する視覚言語モデル、音声認識、音声合成のモデルも選択肢に含まれる
- TensorRT Edge-LLMのドキュメントで、展開先の組み込みプラットフォームごとのワークフローと要件を確認する
- Nemotron開発者ページの資料を使い、Hugging Face上のオープンなNemotronモデルとデータセット、build.nvidia.comのBlueprintsを活用する
テキストモデルで流れをつかんだ後は、画像や音声のモデルへ広げると、車載やロボット向けの試作に近づけられます。
まとめ
TensorRT Edge-LLMは、DGX Spark 64GB上でエッジ向けLLMを数コマンドで動かせる推論ランタイムです。チャット、OpenAI互換API、DSparkによる高速化まで、同じ流れで試せます。開発機とThor系の展開先で同じ推論基盤を使えるため、試作から実機への移行がしやすくなると言えます。今後は対応モデルの広がりが注目点です。