はじめに
OpenAIが2026年10月30日、ウェブサイトのコンテンツを生成AIの基盤学習に使ってよいかどうかを、robots.txtの共通シグナルで一括して伝えられる仕組みに対応すると発表しました。本稿では、この発表とIETFで公開された仕様案をもとに、シグナルの仕組みと既存の制御との関係を解説します。
参考記事
メイン記事:
- タイトル: Making it easier for websites to express AI training preferences
- 著者: OpenAI
- 発行元: OpenAI
- 発行日: 2026年10月30日
- URL: https://openai.com/index/helping-websites-express-ai-training-preferences
関連情報:
- タイトル: draft-kelley-aipref-training-preference-signal(Internet-Draft 第00版)
- 著者: Kevin Kelley
- 発行元: IETF Datatracker
- 発行日: 2026年10月30日
- URL: https://datatracker.ietf.org/doc/draft-kelley-aipref-training-preference-signal/
関連記事
要点
- OpenAIは、robots.txtでAI学習への利用可否を示す共通シグナルを尊重すると表明した。
- 共通シグナルにより、サイト運営者は複数のAI事業者へ同じ意思を一度に伝えられる。
- 実装は今後数か月以内の予定であり、既存のクローラー制御も引き続き有効である。
- この取り組みはIETFのAI Preferencesワーキンググループの議論に基づいている。
詳細解説
robots.txtで「AI学習の可否」を伝える共通シグナル
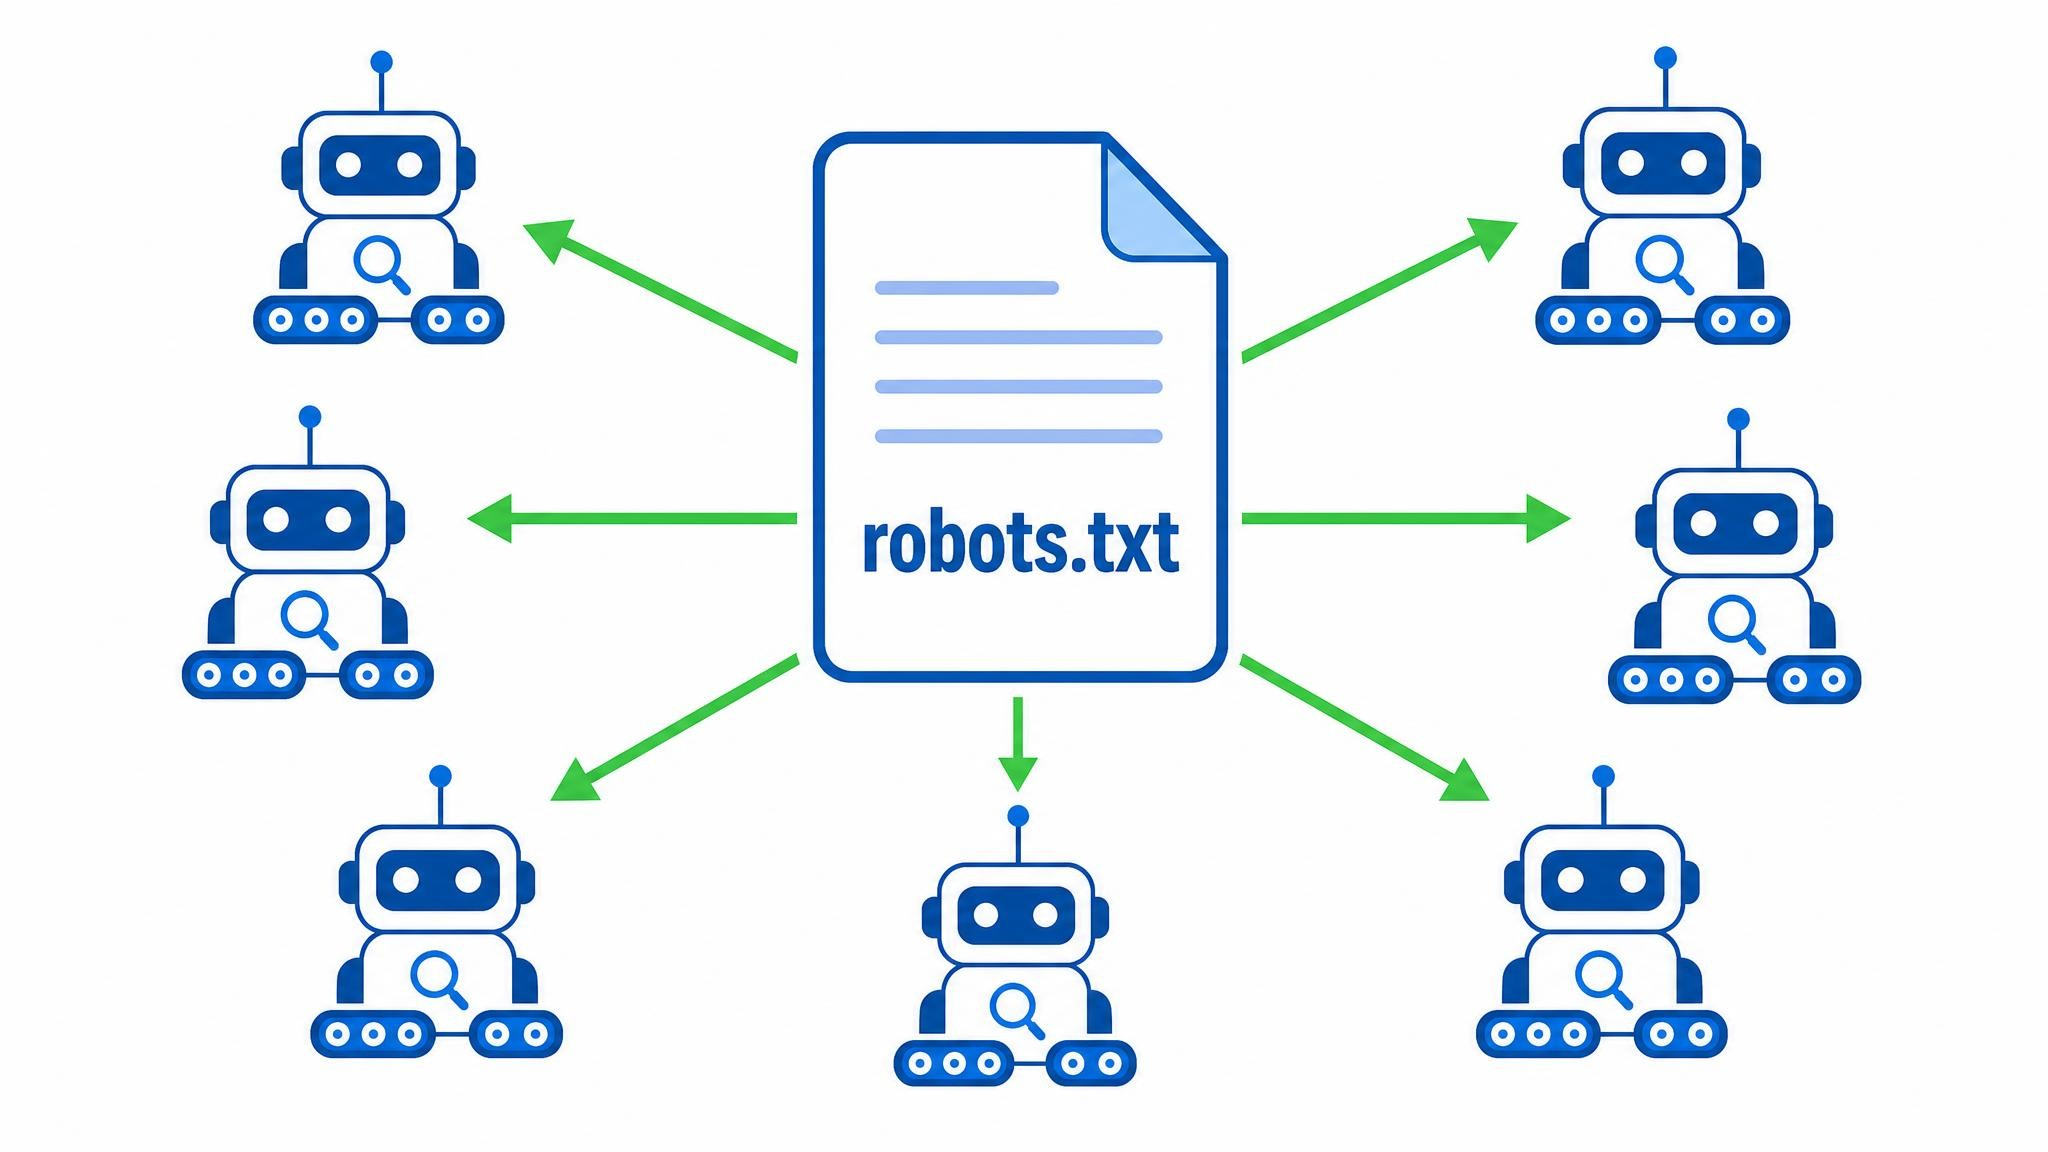
OpenAIによれば、今回対応するのは、robots.txtに記述する共通のシグナルです。robots.txtは、ウェブサイトがクローラー(自動でページを巡回・収集するプログラム)に対して、どのページを取得してよいかを伝えるためのテキストファイルです。今回のシグナルは、そのrobots.txtの中で「自サイトのコンテンツを生成AIの基盤学習(foundational generative AI training)に使ってよいか」という意向を表明するための仕組みです。OpenAIはこれを任意参加(voluntary)の取り組みと位置づけており、参加する複数の事業者に対して同じ意向をまとめて伝えられる点が特徴です。
IETFで公開された仕様案では、__usage_ai-training という専用の識別子を、robots.txtのUser-Agent行に書く形式が示されています。仕様案に掲載されている記述例は次のとおりです。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
この例は「サイト全体はAI学習に使ってほしくないが、/press-kit/ 以下は使ってよい」という意向を表します。仕様案によれば、Disallowとしたパスは学習利用に否定的な意向、Allowとしたパスは肯定的な意向を示し、この識別子を含むグループがなければ意向は表明されていない扱いになります。また、User-Agent: * のワイルドカード指定はこの識別子に一致しないものとして扱うと定められています。既存のrobots.txtの書き方をそのまま流用できるため、運営者にとって新しい記法を覚える負担は小さいと考えられます。
これまでの課題: 事業者ごとの個別ルール
OpenAIは、これまでサイト運営者が個々のクローラーを特定し、事業者ごとに別々のルールを管理する必要があったと説明しています。共通シグナルを複数の事業者が尊重すれば、この作業を減らせるというのが今回の狙いです。
例えばOpenAIのGPTBotのように、AI事業者はそれぞれ独自の名前のクローラーを運用しており、運営者は新しいAIサービスが登場するたびにrobots.txtを更新する必要がありました。中小規模のサイトや個人ブログにとって、この追従は負担が大きかったと思います。Cloudflareがクロールへの課金という形で運営者側の選択肢を広げようとしてきたことも含め、「運営者がどう意思を示すか」は数年来の論点であり、本稿としては、今回の共通シグナルはその負担を下げる方向の一歩と受け止めています。
導入時期と既存のクローラー制御との関係
OpenAIは、今後数か月以内にこのシグナルを実装し、実装時には詳細を改めて公表するとしています。また、新しいシグナルは既存のrobots.txtによる制御を置き換えるものではなく、OpenAIがすでに提供しているクローラー制御も引き続き適用・尊重されると明言しています。
IETFの仕様案でも、コンテンツの「利用」に関する意向と、クローラーの「アクセス」に関するルールは別物として扱われています。つまり、ページの取得自体は許可しつつ学習利用には否定的な意向を示す、といった使い分けができると読めます。一方で、実装時期が「今後数か月」とされている点や、各社がどの範囲を「基盤学習」とみなすかについては、実装の詳細が公表されるまで見極めが必要だと思います。
IETFでの標準化議論との関係
OpenAIによれば、今回の取り組みはIETF(インターネット技術の標準化を担う団体)のAI Preferencesワーキンググループで進む議論に基づいています。OpenAIはワーキンググループの他の参加者とともに今回の共通シグナルを発表したとし、これがIETFでの標準化議論への継続的な参加を強めるものだと述べています。今後も議論や状況の変化に応じて、適切な制御と公平性の観点から自社の運用を調整していく方針です。
IETF Datatrackerによれば、今回の仕様案は個人提出のInternet-Draft(第00版)で、IETFとして正式に承認された標準ではありません。仕様案の著者はAnthropic所属の人物で、謝辞にはGoogle、Microsoft、OpenAI、Cloudflareなどに所属する貢献者が名を連ねています。複数の事業者が関わる形で始まっている点は、特定企業の独自仕様にとどまらない可能性を示していると考えられます。
「オープンなウェブ」に向けて
OpenAIは今回の取り組みを、人々が情報を公開・発見できるオープンなウェブと、運営者が自分のコンテンツの使われ方をより明確かつ簡単に伝えられる環境に向けた、実践的な一歩だと位置づけています。そのうえで、他のAI事業者にもこのシグナルを尊重するよう呼びかけています。
ただし、このシグナルはあくまで「意向の表明」であり、従うかどうかは各事業者の自主的な対応に委ねられています。技術的な強制力を持たない仕組みがどこまで実効性を持つかは、参加する事業者の広がりと、実装内容の透明性にかかっていると思います。ウェブを公共的な情報基盤として保ちつつ、作り手の意思も尊重するという両立の試みとして、今後の動向を見守りたいところです。
まとめ
OpenAIは、robots.txtの共通シグナルを通じてAI学習への利用可否を一括で伝えられる仕組みに対応すると表明しました。実装はこれからですが、運営者の負担軽減と標準化の両面で注目されます。AI学習データをめぐる議論については、ブリタニカによるOpenAIの提訴をめぐる解説もあわせてご覧ください。