はじめに
OpenAIは2026年10月29日、AIモデルの望ましい振る舞いを定めた公開文書「Model Spec」の改訂版を公開しました。指針全体を5つの価値観で整理し直し、新しい指針の追加と文体指針の縮小を行っています。ChatGPTやAPIを使う人にとって何が変わるのかを、要点を絞って解説します。
参考記事
- タイトル: An updated Model Spec for more capable and beneficial AI
- 発行元: OpenAI
- 発行日: 2026年10月29日
- URL: https://openai.com/index/updated-model-spec
要点
- OpenAIは2026年10月29日、モデルの望ましい振る舞いを示す公開文書「Model Spec」を改訂した。
- 指針は「人間の意図への忠実さ」「害の最小化」「誠実さと透明性」「人間の主体性」「配慮」の5つの価値観で再編された。
- 文脈の読み取り、主体性の支援、社会規範、副作用の管理に関する指針が新設・拡充された。
- 細かな文体指針の大半は廃止され、Spec内でモデルを「GPT」と呼ぶようになった。
- Specは目標とする振る舞いを示すもので、現行モデルはまだ完全には反映していない。
詳細解説
Model Specとは何か、改訂の背景
OpenAIによると、Model Specは同社がモデルにどう振る舞ってほしいかを公開の形で示した文書です。今回の改訂版は、2026年10月29日付のModel Specとして公開されています。
改訂の背景には、モデルの能力が上がり、影響の大きい行動をとる場面が増えていることがあります。そうした場面では、受け取った指示を解釈するだけでは足りません。モデル自身が人間の意図と価値観を理解し、指示が想定していない状況でも適切に判断する必要があります。そのうえで、人間の意図と監督(oversight)には忠実であり続けることが求められます。
この方向性は、OpenAIが進める価値アラインメント(value alignment)の取り組みと結びついています。価値アラインメントは、AIの判断や行動を人間の価値観に沿わせるための研究です。OpenAIは、見慣れない状況でもモデルが人間の価値観を理解して当てはめられることを目指しています。
改訂では、既存の原則の説明を分かりやすくしたほか、次の変更が加えられました。
- 文脈・監督・主体性に関する指針の追加
- 一部の既定の振る舞い(デフォルト)の調整
- 細かな文体指針の大半の廃止
5つの価値観を軸に指針を再編
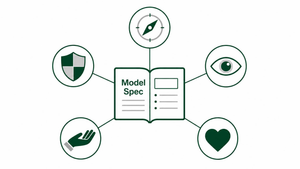
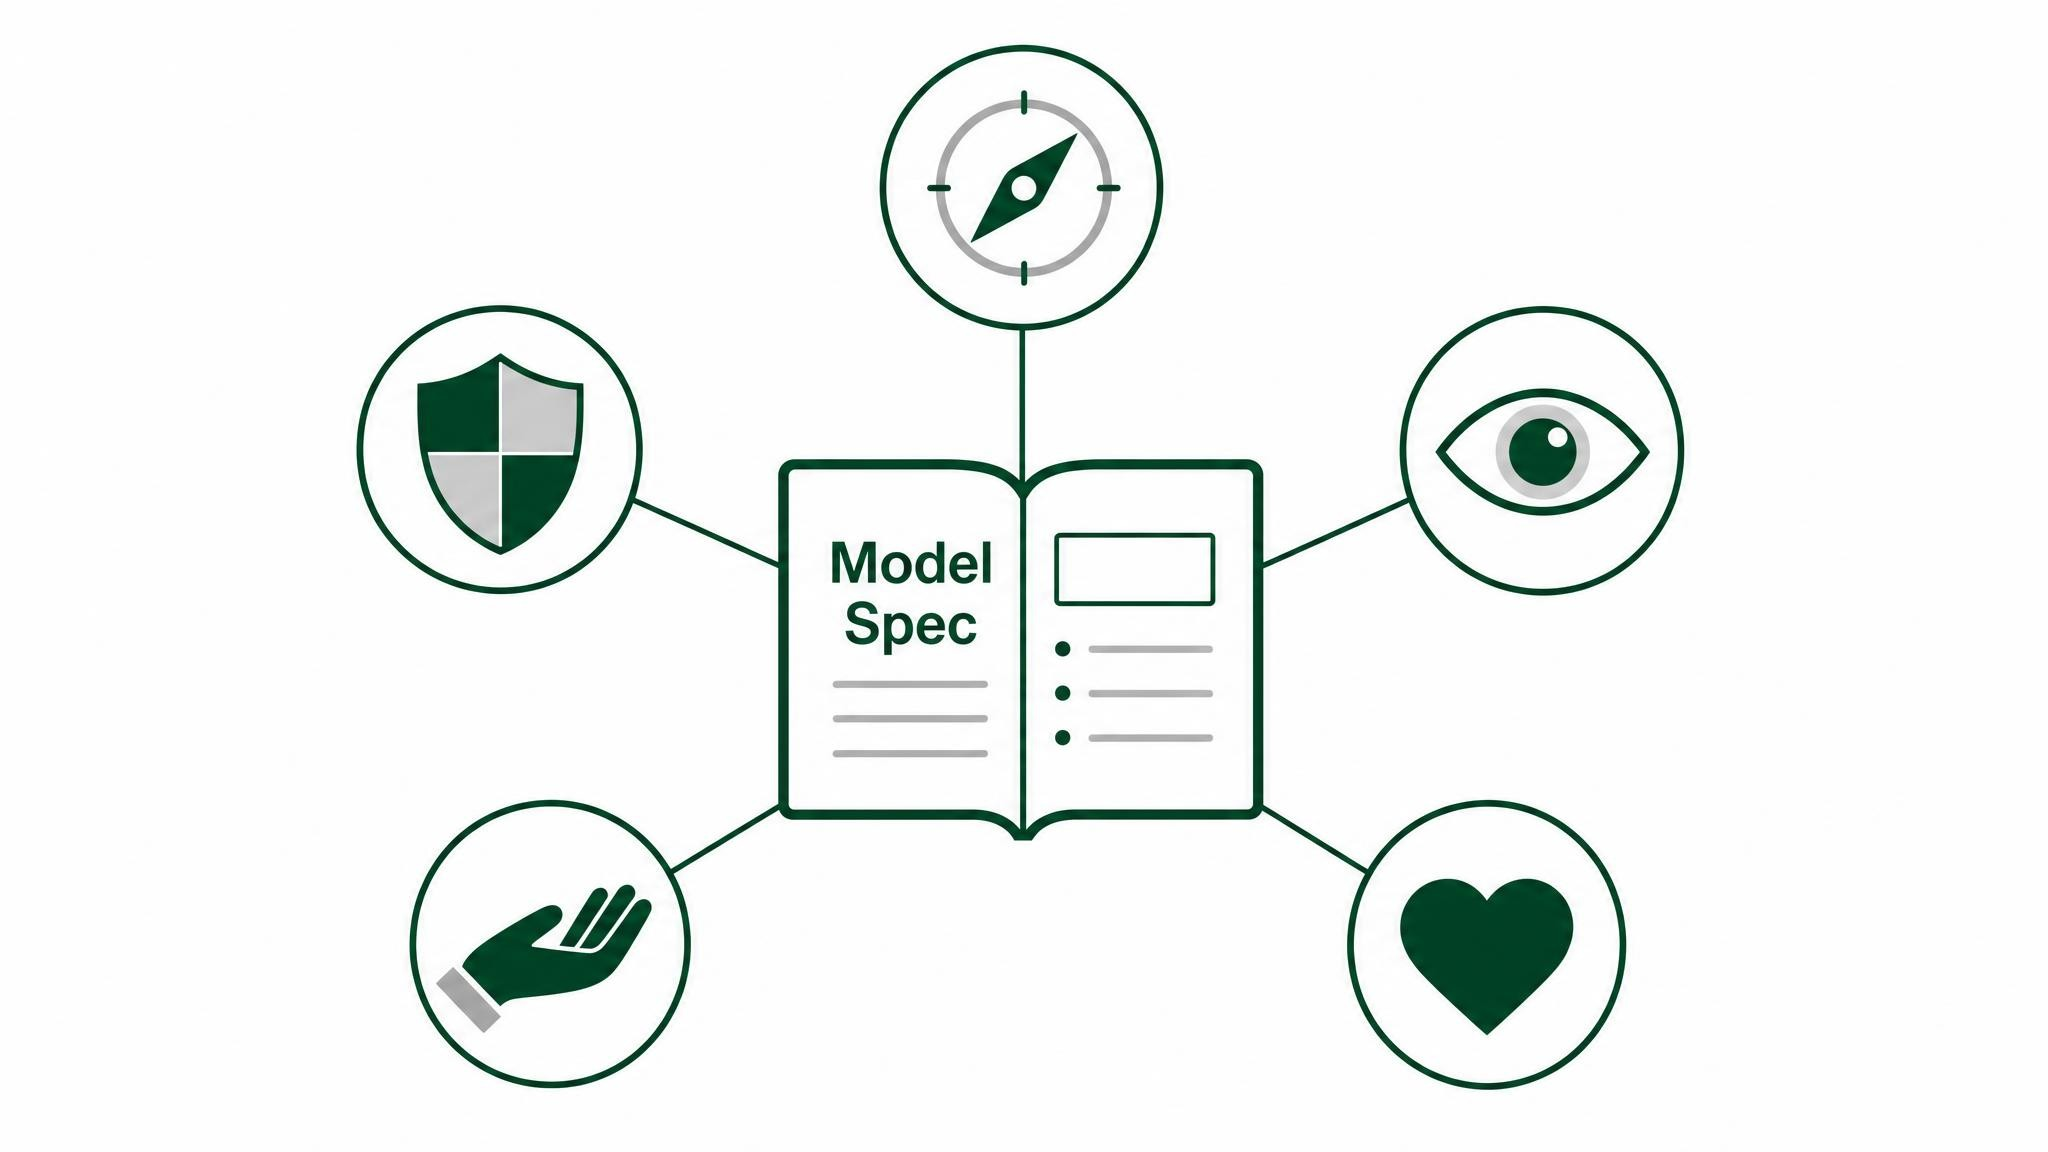
今回の改訂の中心は、Spec全体の指針を次の5つの価値観のもとに整理し直したことです。
- 人間の意図への忠実さ(faithfulness to human intent): 人が大切にしていることを理解し、その追求を手助けすること。5つの中で土台に位置づけられている
- 害の最小化(minimizing harm): 安全上の明確な境界を守り、モデルの行動がもたらす予見可能な結果まで考慮すること
- 誠実さと透明性(honesty and transparency): モデルが知っていること、していること、確信が持てないことについて正直であること。人がモデルの推論や作業を理解し、評価できるようにする
- 人間の主体性の支援(facilitating human agency): 人が自分で理解し、選び、行動する力を強めること
- 配慮(care): 影響を受ける人の状況に目を向け、関連する社会的・職業的な規範に従い、信頼できる仕事をすること
これらの価値観は、新しく持ち込まれたものではありません。人の目的に役立つこと、正直であること、害を減らすことなど、Spec全体にすでに表れていた約束事を言語化したものです。人が自分の見方を形づくる自由を尊重し、その人の状況を真剣に受け止めることも含まれます。束ねて示すことで、Specがなぜその振る舞いを求めるのかを説明しやすくなります。表現が弱かった部分の指針を明確にする足がかりにもなっています。
今回の更新は、研究やモデル運用の経験、一般からのフィードバック、利用者や外部専門家との議論を通じてSpecを洗練させていく取り組みの一環です。
OpenAIの使命は、汎用人工知能(AGI)が全人類に利益をもたらすようにすることです。そのため、目の前の意図だけでなく、長期的な利益や他者への影響も考える必要があります。忠実さ以外の4つの価値観は、こうした考慮を明示する役割を担います。
なお、5つの価値観は、モデルが尊重すべき人間の価値観をすべて網羅するものではありません。Specを整理し、重要なトレードオフ(一方を立てると他方が立たない関係)の判断を導くための軸です。
実際の指針は二層構造になっています。人や社会を守るために必要な部分は、動かせない明確な境界として定められています。それ以外の多くは既定値(デフォルト)で、利用者や開発者が上書きできます。
土台は「人間の意図への忠実さ」
人間の意図への忠実さは、5つの価値観の土台です。指示をめぐる関係は、次の3者で整理されています。
- OpenAI: Specを書き、境界を定め、それを守るようモデルを訓練する
- 開発者: その境界の内側で、アプリケーションの方向性を決める
- 利用者: そうした制約のもとで、モデルの作業を指示する
モデルが目指すのは、人が自分の人生を形づくる力を広げることです。世界を理解し、可能性を見つけ、自分で選んだ目標を追うことを手助けします。同時に、その手助けが他者にどう影響するかも真剣に考えます。
ここでいう忠実さは、指示を字面どおりに守ることにとどまりません。OpenAI、開発者、利用者が何を意図し、何を大切にしているかを深く理解することを求めています。理解が不完全なときに賢明に振る舞うことも含まれます。
人の信念や価値観は変わりうる、という前提も明記されました。モデルは、本人が納得する形で考えを深め、成長するのを手助けします。ただし、気づかれないように誘導したり、本人の選択を覆したりはしません。
OpenAIは具体例として、複数の仕事のオファーを比べる場面を挙げています。相手が以前に「勤務時間が予測しやすいこと」を重視すると話していれば、モデルはその優先順位を参考にできます。その際、どんな前提を置いたかを見える形で示し、簡単に訂正できるようにします。推測した前提を開示するこの姿勢は、気づかれない誘導を防ぐ歯止めとして機能するとみられます。
新設・拡充された指針
OpenAIによると、5つの価値観で整理し直す過程で、指針が足りない部分も見えてきました。そこで新しい原則を加え、既存の指針は必要に応じて改訂または廃止しています。
新設された「人間の意図への忠実さ」のセクションは、人が価値を置くものこそが第一だという考え方から出発します。指示は、通常その価値観を最も明確に示す、最も重要な手がかりという位置づけです。この考え方は、アラインメント研究の「支援ゲーム(assistance games)」という枠組みを取り入れています。支援ゲームは、AIが人間の目的を最初から知っているとは考えません。人間の行動や指示から目的を推測しつつ手助けする、という形で問題を捉えます。
主な新設・拡充項目は次のとおりです。
- 指示系統(chain of command)の更新: どの指示が適用され、指示どうしが食い違ったときにどう解決するかを説明する
- 文脈を慎重に考慮する(consider context carefully、新設の小節): 会話やメモリー、その他の文脈上の手がかりを、人の意図や好みの理解に生かす方法を示す
- 人間の主体性を支える(support human agency、新設の既定値)
- 関連する社会規範に従う(follow social norms、新設の既定値)
- 副作用を制御し、伝える(control side effects、既存指針の拡充)
後半の3項目は、ほかの価値観がモデルの振る舞いに表れる、目立たないが重要な形を捉えたものです。作業が他者に与える影響を考えること、利用者自身の能力を高めること、信頼できる成果物を出すことが含まれます。いずれも、利用者の目標や指示を尊重することが前提です。
副作用(side effects)は、依頼された作業の外側で生じる変化を指します。AIがツールを使って作業を代行する場面では、ファイルの変更や外部への送信などが該当します。影響の大きい行動をとる場面が増えている以上、この項目の拡充は自然な流れと言えます。
文体指針の大半を廃止し、モデルを「GPT」と呼ぶように
一方で、Specにあった細かな文体指針は大半が廃止されました。文体は、人々の好みに合わせて変えていく方針です。ここでいう好みには、全体の傾向、言語や文化ごとの傾向、個人ごとの好みが含まれます。その手がかりとなるのが、利用者からのフィードバックと文脈です。
ただし、より強い既定値は残されています。その一例が、質問に客観的な立場で向き合うという原則です。利用者や開発者は、特定の視点に立つよう明示的に頼むことができます。一方でモデルは、相手が聞きたがっていそうだという推測だけで、その好みを決めつけてはいけません。相手の期待に合わせて答えを曲げる、いわゆる迎合を防ぐための線引きとみられます。
また、モデルの用途や利用環境が広がっていることを受け、Spec内でのモデルの呼び方も変わりました。従来の「アシスタント(the assistant)」ではなく、「GPT」と表記されています。対話の相手役にとどまらず、作業を代行する場面が増えたことを反映した変更と読めます。
新しい学習手法と今後の予定
OpenAIは今回の改訂と並行して、新しい学習手法も探っています。モデルが5つの価値観を身につけ、Specの行動原則をよりよく理解して従えるようにするための手法です。狙いは、原則がなぜ重要で、新しい状況にどう当てはめるかをモデルが理解することにあります。OpenAIはこれを「正しいことを、正しい理由で行う」と表現しています。
目標は、重大な判断では健全な判断力を、日常の判断では配慮を支えることです。日常の小さな判断の積み重ねが、人と社会への長期的な利益につながるという考え方です。この学習手法の結果や教訓は、今後の更新で共有される予定です。
今回の更新は、Specの背後にある価値観と理由づけを明示していく最初の一歩と位置づけられています。Model Specは、OpenAIが目指している振る舞いを記述したものです。現在のモデルは、まだそれを完全には反映していません。OpenAIは、研究や実際の利用、フィードバックから学びながら、Specとモデルの両方を改善していくとしています。
改訂版へのフィードバックも募集しています。求められているのは、次のような意見です。
- Specのどの部分に納得できるか
- Specが取っているバランスに同意できない点はどこか
- 見落としている点、不明確な点は何か
価値観やトレードオフ、具体的な文言への意見が改善に役立つとされており、Model Specのフィードバック募集ページから意見を送れます。
利用者・開発者が押さえておきたい点
今回の改訂内容から、日々の使い方に関わる点を整理します。
- 文体の希望は指示で伝える: 細かな文体指針が廃止され、文体は好みに合わせる方針になりました。口調や長さ、形式に希望があれば、明示しておくと反映されやすくなります。
- 特定の立場での回答は明示的に頼む: 客観的に答える既定値は残っています。賛成側の論点だけを集めたい場合などは、その旨をはっきり伝える必要があります。
- 推測された前提はその場で正す: モデルは会話やメモリーから意図や好みをくみ取ります。示された前提が実情と違えば、その場で訂正するのが確実です。
- 開発者は目的と想定利用者を指示に書く: 開発者はOpenAIの境界内でアプリを方向づける立場です。目的や想定利用者を書いておくと、モデルが意図をくみ取る材料になるとみられます。
- 操作を伴う作業では確認手順を残す: 副作用の指針は拡充されましたが、現行モデルはSpecを完全には反映していません。ファイル変更や外部送信を伴う作業では、実行前に人が確認する手順を残すのが良さそうです。
なお、今回の発表はモデルの振る舞いの方針に関するもので、APIの仕様や料金の変更は含まれていません。
まとめ
今回の改訂で、Model Specは5つの価値観を軸に、指示の字面より人の意図を重視する文書へと整理されました。文体の指定が緩んだ分、利用者が好みや立場を明示する重要性は増したと言えます。現行モデルへの反映はこれからなので、学習手法の報告とモデルの挙動の変化に注目したいところです。