はじめに
NVIDIA Blogは 2026年8月6日 、120以上の組織が参加するOpen Secure AI Allianceの取り組みを公開しました。中心は、AIエージェントの事故やニアミスを共同防御へ変えるSAFEガイドライン案です。本稿では、RFCの位置づけと、IDから復旧までの具体的な貢献を整理します。
参考記事
メイン記事:
- タイトル: AI のリーダーたちがサイバーセキュリティの透明性向上に向けた SAFE ガイドラインを提案
- 著者: Justin Boitano
- 発行元: NVIDIA Blog
- 発行日: 2026年8月6日
- URL: https://blogs.nvidia.co.jp/blog/open-secure-ai-alliance-contributions/
関連記事
要点
- 120以上の組織が参加するOpen Secure AI Allianceは、AIインシデントとニアミスを再利用可能な防御へ変えるSAFEのRFCを開始した。
- SAFEは意見募集段階の提案であり最終標準ではないが、機密収集、原因分析、関係者通知、証拠に基づく推奨公開の流れを定義する。
- AIエージェントをモデル単体ではなく、ID、ハーネス、ガードレール、ログ、評価、可用性まで含むシステムとして防御する。
- NVIDIAのOpenShellや検証済みスキルに加え、Amazon、Microsoft、Cisco、Uberなどが権限、評価、専用モデル、可観測性の部品を提供する。
- Uber ADRは3万台のエンドポイントで1日20万件超のセッションを支援し、LangChainとVeeamは中断や障害からの復旧層を補う。
詳細解説
SAFEは事故報告を運用改善へ変える
Open Secure AI Allianceは、AIの安全性とセキュリティをオープンな協力で改善する団体です。NVIDIA、Cisco、CrowdStrike、Hugging Face、Red HatなどがLinux Foundationと協力し、Shared AI Findings Exchange、略してSAFEの初期案を作りました。
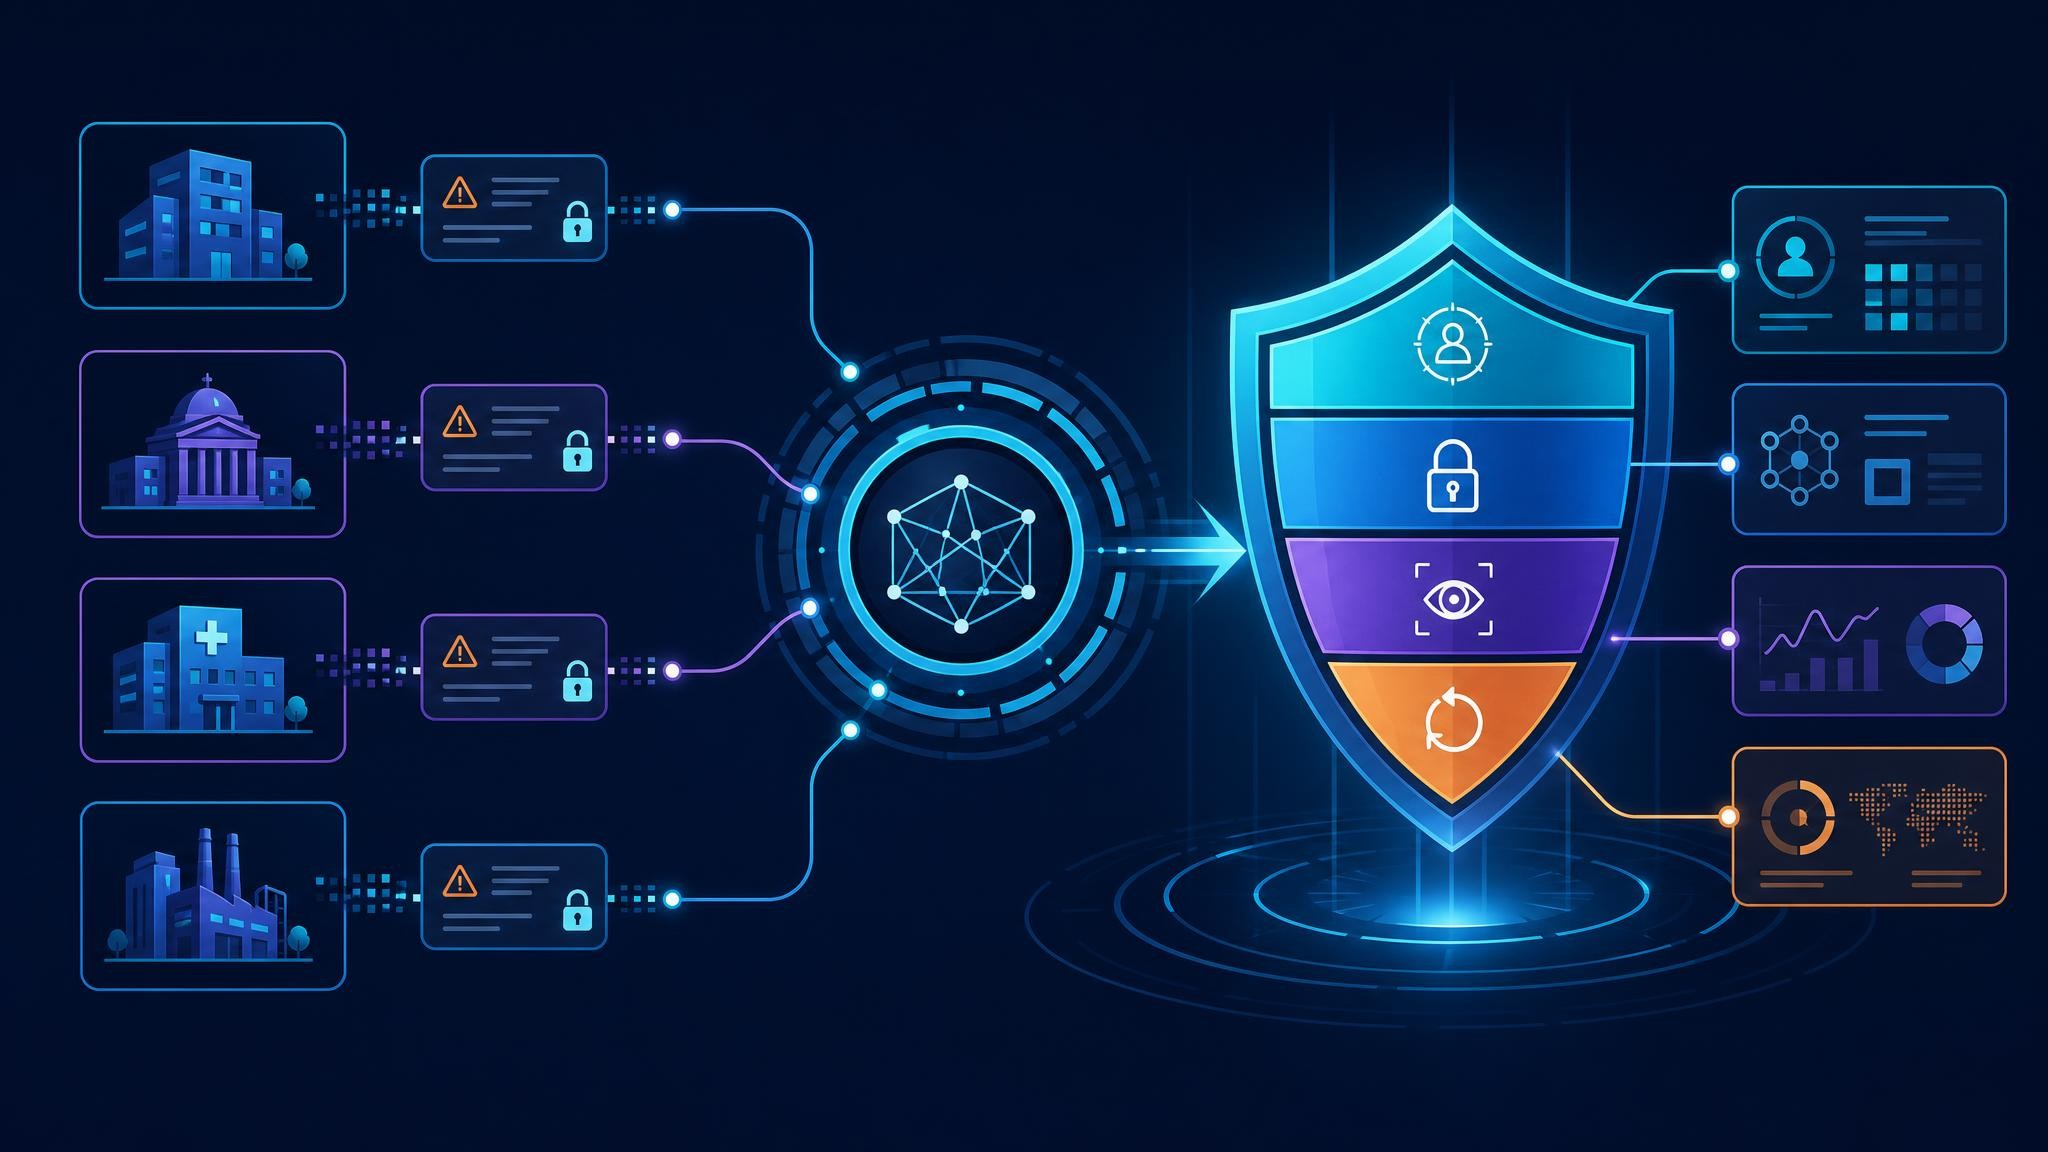
狙いは、AIインシデントとニアミスを機密を保ちながら収集し、単独の組織内で終わらせないことです。影響を受けた関係者へ情報を伝え、繰り返す制御不備を横断的に特定し、証拠に基づく運用推奨として公開します。航空や医療の事故・ヒヤリハット共有に近い発想を、エージェント型AIのサイバーセキュリティへ持ち込みます。
ただし、SAFEは完成した標準や認証ではありません。Linux Foundationが開始したRFC、つまり意見募集段階です。参加組織の合意、機密情報の扱い、責任分界、公開範囲、再現可能性を今後詰める必要があります。現時点では「準拠」を名乗るより、提案された報告と改善の流れを自社運用へどう取り込めるかを見る段階です。
モデルだけを検査してもエージェントは守れない
元記事が繰り返す前提は、AIエージェントは単なるモデルではないという点です。実際のシステムは、ID、ハーネス、ガードレール、ログ、評価、ツール、ランタイム、データ、復旧機構から成ります。モデルへの脆弱性スキャンだけでは、過剰な権限、ツールの改ざん、監査不能、障害時の状態損失を捉えられません。
防御の問いも層ごとに変わります。ID層では「誰がアクションを実行できるか」、ハーネスでは「何をどの順序で行えるか」、モデルでは「どの脅威を理解・分類できるか」、可観測性では「なぜその行動が起きたか」、レジリエンスでは「どこまで局所化し安全に戻せるか」を確認します。SAFEは、これらのどこで制御が破れたかを共有可能な形へ揃える役割を目指します。
NVIDIAはハーネスからモデル検査までを提供
NVIDIA Labs Object-Oriented Agent(NOOA)は、研究用エージェントハーネスとして、動作のテスト、追跡、監査、ガバナンスを支援します。モデルの回答だけでなく、ツール呼び出しと状態遷移を含むエージェント全体を観察するための層です。
NVIDIA OpenShellは、エージェントが見られるもの、触れられるもの、実行できることをランタイムで制限します。モデルが拒否することを期待するだけでなく、アクセスすべきでない資源へ到達できない境界を外側へ置きます。エージェント型のNemotron、フィジカルAIのCosmos、ロボティクスのIsaac GR00T、生命科学のBioNeMo、自動運転のAlpamayoなど、分野別のモデルやデータ、学習手法も同じオープンスタックの一部として挙げられています。
検証済みエージェントスキルは、ポータブルな命令セットをカタログ化し、プロンプトインジェクションとツールポイズニングをスキャンします。暗号署名とスキルカードを付け、出自、動作、公開後の改ざん有無を確認できるようにします。スキルが便利な命令ファイルであるだけでなく、配布物としてのサプライチェーン管理対象になることを示しています。
周辺にはNeMo Guardrails、NeMo Anonymizer、NeMo Safe Synthesizer、Garakがあります。安全ポリシー、機密データの匿名化、プライバシーに配慮した合成データ、データ漏洩やジェイルブレイクの検査をそれぞれ担当し、単一の万能ツールへ依存しません。
IDと権限を実行時の境界へ落とす
OktaはオープンプロトコルCross App Access(XAA)とOpenShellを使い、サンドボックス内のAIエージェントが企業アプリへ安全に接続する参照実装を開発しています。Palo Alto NetworksはAgent GuardとAgent Watchを提供し、シークレットの安全な取得やIDセキュリティの実装を支援します。
Red Hatのasagoは、NIST、OWASP、EU AI法などで示される組織要件を、ランタイムで許されるエージェント行動へ対応付けます。ポリシー文書と実際の制御を別々に管理せず、条項から許可・拒否までを一つの監査証跡で追える設計です。規制名を設定へ写すだけでは足りず、自社の資産、役割、例外へ具体化する必要があります。
ハーネスとツールで行動を検証可能にする
AmazonはオープンソースのStrands Agentsと認可言語Cedarを提供します。Strands Agentsは各層の挙動を見えるようにし、Cedarは承認されたアクションだけが企業資源へ届く決定論的な境界を作ります。自然言語の指示と、機械的に検証できる認可を分ける考え方です。
MicrosoftはPyRIT、RAMPART、Clarity、Assertを公開しています。PyRITは自動レッドチーム、RAMPARTは発見事項や実インシデントを再現可能なテストへ変換、Clarityは設計上の前提を実装前に検証、Assertは自然言語の安全要件を実行可能な評価へ変換します。事故を共有しても再現テストへ落とせなければ再発防止が難しいため、SAFEと補完関係にあります。
Capital One、Cloudflare、Wiz、Visaも、コードやパッケージを対象とする脆弱性発見・検証エージェントやハーネスを提供します。製品名は異なっても、発見、原因分析、修正、再検証を記録可能な経路へする点が共通しています。
専用モデルと可観測性を組み合わせる
CiscoはOpenShell上で動くガバナンス層DefenseClaw、脆弱性位置を特定する小型モデルAntares、AIコーディングへ安全な既定値を組み込むProject CodeGuardを公開しています。すべてを汎用大規模モデルへ任せず、狭い防御業務に特化したモデルを組み合わせます。
CrowdStrikeはNemotron Nanoをサイバー防御向けに調整し、Falcon LogScaleの調査クエリ生成で96%の精度を報告しました。SOCの検知トリアージでは、より大規模なモデルを上回る事例も紹介しています。これは社内評価であり、他のログ形式や脅威分布でも同じ精度になる保証ではありません。
Mistralは、マルチモーダルな安全分類モデルShieldstralをApache 2.0のオープンウェイトとして公開しました。専用モデルを監査・調整しやすくする一方、ライセンスがオープンであることと、個別環境で安全性が検証済みであることは分けて考える必要があります。
3万台・1日20万件超の活動を因果で追う
可観測性は、最終操作だけでなく、なぜそこへ至ったかを再構成する層です。PerplexityのNumbatはmacOS、Linux、Windowsのクライアント上でエージェント活動を検知・調査・防止し、実行記録を残します。Akamaiは実環境の脅威知見を共有し、Cognitionはオープンソース由来モデルの信頼性評価を公開しています。
Uber ADRは、プロンプト、推論、ツール呼び出し、最終結果をつなぐ因果連鎖を再構成します。3万台のエンドポイントで1日20万件超のエージェントセッションを支援し、効率的な検知と確度の高い脅威の詳細調査を二段階で行います。件数が多い環境では、全件を同じ深さで調べず、絞り込みと詳細分析を分ける必要があるためです。
障害後に安全な状態へ戻せるか
防御は侵入や誤操作の防止だけでは終わりません。LangChainは、処理の再試行、安全な復旧、保存状態からの再開、主モデル障害時の代替モデルへのフォールバックを、Deep Agents、LangGraph、LangChainへ強化しています。
VeeamはKanisterなどを使い、AIワークロードやベクトルDBを含むデータと基盤を保護し、検証済みの正常状態へ復旧させます。エージェントが長い処理を持つほど、単純な再起動では同じ操作の重複や状態不整合が起きます。再実行可能性、チェックポイント、ロールバック範囲を事前に決める必要があります。
導入時にSAFEから取り込めること
第一に、事故だけでなくニアミスを記録します。モデル、プロンプト、権限、ツール、データ、検知、復旧のどの層で止まったかを残すと、成功した防御も再利用できます。個人情報や脆弱性情報は、そのまま共有せず匿名化と公開範囲を定義します。
第二に、報告を再現テストへ変換します。RAMPARTやAssertのように、発見事項を継続的な評価へ落とし、モデルやツールを更新するたび実行します。署名済みスキル、Cedarの認可、OpenShellの境界は、報告から具体的な制御へ進む例です。
第三に、RFCと実装済み製品を混同しません。SAFEの手順、加盟企業が公開したOSS、商用サービス、社内評価値は成熟度も保証も異なります。採用時はライセンス、保守主体、監査可能性、対応OS、誤検知、復旧試験を個別に確認します。
まとめ
SAFE案は、AIエージェントの事故とニアミスを機密下で集め、再現可能な防御へ変える枠組みです。価値は単独ツールではなく、ID、認可、評価、監視、復旧をつなぐ点にあります。まだRFCであるため、各組織は公開された緩和策を検証、適応、改善し、自社の責任分界へ落とす必要があります。