はじめに
NVIDIA Blogは 2026年9月10日 、IFA 2026で発表したローカルAI基盤を紹介しました。複数PCへ推論を分散するPAIR、エージェントの簡単設定、推論最適化、RTX Spark搭載PCが柱です。本稿では、提供状況、性能条件、対応環境、データ経路まで整理します。
参考記事
メイン記事:
- タイトル: 高まる期待:NVIDIA が IFA 2026 においてローカル AI を加速
- 著者: Gerardo Delgado
- 発行元: NVIDIA Blog
- 発行日: 2026年9月10日
- URL: https://blogs.nvidia.co.jp/blog/local-ai-ifa-next-gen-agents-nv-pair-rtx-spark/
関連記事

要点
- NVIDIA PAIRは無料のオープンソースPersonal AI Routerで、ローカルネットワークの互換PCを自動検出し、独立した推論要求を空き端末へ振り分ける。
- PAIRベータ版はWindows、macOS、Linuxで利用でき、GeForce RTX 20以降、RTX PRO Turing以降、DGX Spark、Apple M4以降を支援する。
- Hermes Agent、OpenClaw、Perplexity Portable Computerはローカルモデルの設定を簡素化し、必要時だけクラウドへ委譲する構成も取れる。
- 推論高速化は見出し上で最大9倍だが、詳細値はllama.cppの最大1.9倍、vLLMの最大1.4倍、FastH3の性能7倍など対象が異なる。
- RTX Spark搭載Windows PCは2026年10月発売予定で、1ペタフロップスのGPU、最大128GB統合メモリ、20コアCPUを掲げる。
詳細解説
IFA 2026の発表は4つの層に分かれる
NVIDIAの発表は、単一の製品更新ではありません。第一はHermes Agent、OpenClaw、Perplexity Portable Computerのローカル設定簡素化、第二はllama.cppとvLLMの推論高速化、第三は複数PCを束ねるNVIDIA PAIR、第四はRTX Spark搭載Windows PCとクリエイティブアプリです。
「ローカルAI」は、モデルをPCへ置くだけでは成立しません。モデルの選択、量子化、推論サーバー、GPU互換性、更新、エージェントのツール、複数端末への配分までが必要です。今回の発表は、それぞれをアプリ、ランタイム、ルーター、ハードウェアの層で減らす構成になっています。
見出しではローカル推論が最大9倍高速になるとしています。ただし、記事内の個別値は異なる対象と比較条件に基づきます。1.9倍、1.4倍、7倍を足したり、すべてのモデルが9倍になるとは言えません。導入候補と同じモデル、量子化、入力長、同時実行数で再測定する必要があります。
ローカルモデルの選択肢が広がる
Nemotron 3.5 Lightningは300億パラメーターで、RTX PC、RTX PRO Workstation、DGX Spark、Jetsonに対応します。エージェント用途に加え、端末規模の異なるNVIDIA環境へ同じモデル系列を配置できる点が特徴です。
記事はQwen、LTX、MiniMax、Meta、DeepSeekの新モデルや最適化もまとめています。QwenはマルチモーダルMoEと270億パラメーターのコーディング・エージェント向けモデル、LTX 2.5はNVFP4やFastVideo、ComfyUIを使う動画生成、Muse Glimmerは30Bのコーディング・エージェントモデルとして紹介されました。
MiniMax-H3は音声同期のオープンウェイト動画生成モデルです。FastVideoが改良したFastH3は4ステップ蒸留で性能7倍とされ、RTX GPUとDGX Spark向けレシピも予定されています。DeepSeek v4 Flashは総2840億、アクティブ130億パラメーターのMoEで、2台のDGX SparkクラスターまたはDGX Stationでの実行を想定します。
モデル名とパラメーター数だけでは、端末に収まるかを判断できません。量子化形式、コンテキスト長、KVキャッシュ、画像・動画の解像度、同時処理数がメモリを左右します。
Portable Computerはローカル優先、必要時だけクラウド
Perplexity Portable Computerは、モデル、オーケストレーション、ツールを一つのアプリへまとめます。Linuxで24GB以上のVRAMを持つNVIDIA RTX GPUに対応し、Windows対応は近日予定です。ローカル処理ではクレジットを消費せず、追加調査や深い推論が必要な部分だけ15種類以上のクラウドモデルへエスカレートできます。
クラウドへ内容を送る前に許可を求めるため、機密データを端末に残しやすい設計です。ただし、エスカレーションを許可すれば対象データは外部へ送られます。ローカル優先と完全オフラインは同義ではありません。送信対象、委譲先、ログ、保持期間を確認する必要があります。
元記事はエンジニアリング、財務、スタートアップの3例を示します。GitHubの未処理PRと文書同期を点検する、証券・税務文書をファイルとページ付きで分析する、利用ファネルの離脱点を探してSlackへ投稿する例です。最後の例のように外部サービスへ送る処理では、ローカル分析でも出力経路の承認が必要です。
HermesとOpenClawはセットアップを短くする
Hermes Agentは、Windows上のRTXまたはDGX環境でGPU自動検出を行い、適切なモデルと構成を選び、NVIDIA最適化済みllama.cppで実行します。モデルの手動ダウンロードやチューニングを減らすワンクリック設定で、Linux対応も近日予定です。
実行後はツール利用、タスク間の文脈維持、セッション間記憶と再利用可能なスキルの構築を行います。データをPC上へ保ちながら継続利用できますが、常時稼働と記憶は別の安全課題を生みます。保存場所、消去、スキルの出自、ツール権限を初期設定と合わせて確認します。
OpenClawはGitHubで38万以上のスターを持つ大規模なオープンAIプロジェクトです。NVIDIA、Microsoft、OpenClawはWindows向けの導入簡素化を進め、Windowsアプリは24GB以上のVRAMを持つRTX GPUで最適化済みローカルモデルのセットアップを支援します。記事時点では予定として書かれているため、利用前に提供版と要件を確認する必要があります。
llama.cppとvLLMの高速化は条件が違う
llama.cppはGeForce RTX 5090で、カーネル最適化、投機的デコード、高速なprefillにより最大1.9倍のスループット向上を報告しています。個人PCで使われることの多い推論系を直接改善する取り組みです。
vLLMはRTX PRO 6000 Blackwell Workstation Editionで1.2倍、DGX Sparkクラスターで最大1.4倍です。FlashInferのXQA attention kernelとバックエンド最適化が寄与します。LM StudioとOllamaからもこれらの改善を利用できます。
スループットは単位時間当たりの処理量で、最初のトークンが返るまでの待ち時間とは異なります。単一利用者の対話、複数エージェントの並列処理、長文prefillでは重要な指標が変わります。自社用途ではtokens/s、time to first token、同時セッション数、消費電力を分けて測ります。
PAIRが空いているPCへ推論を振り分ける
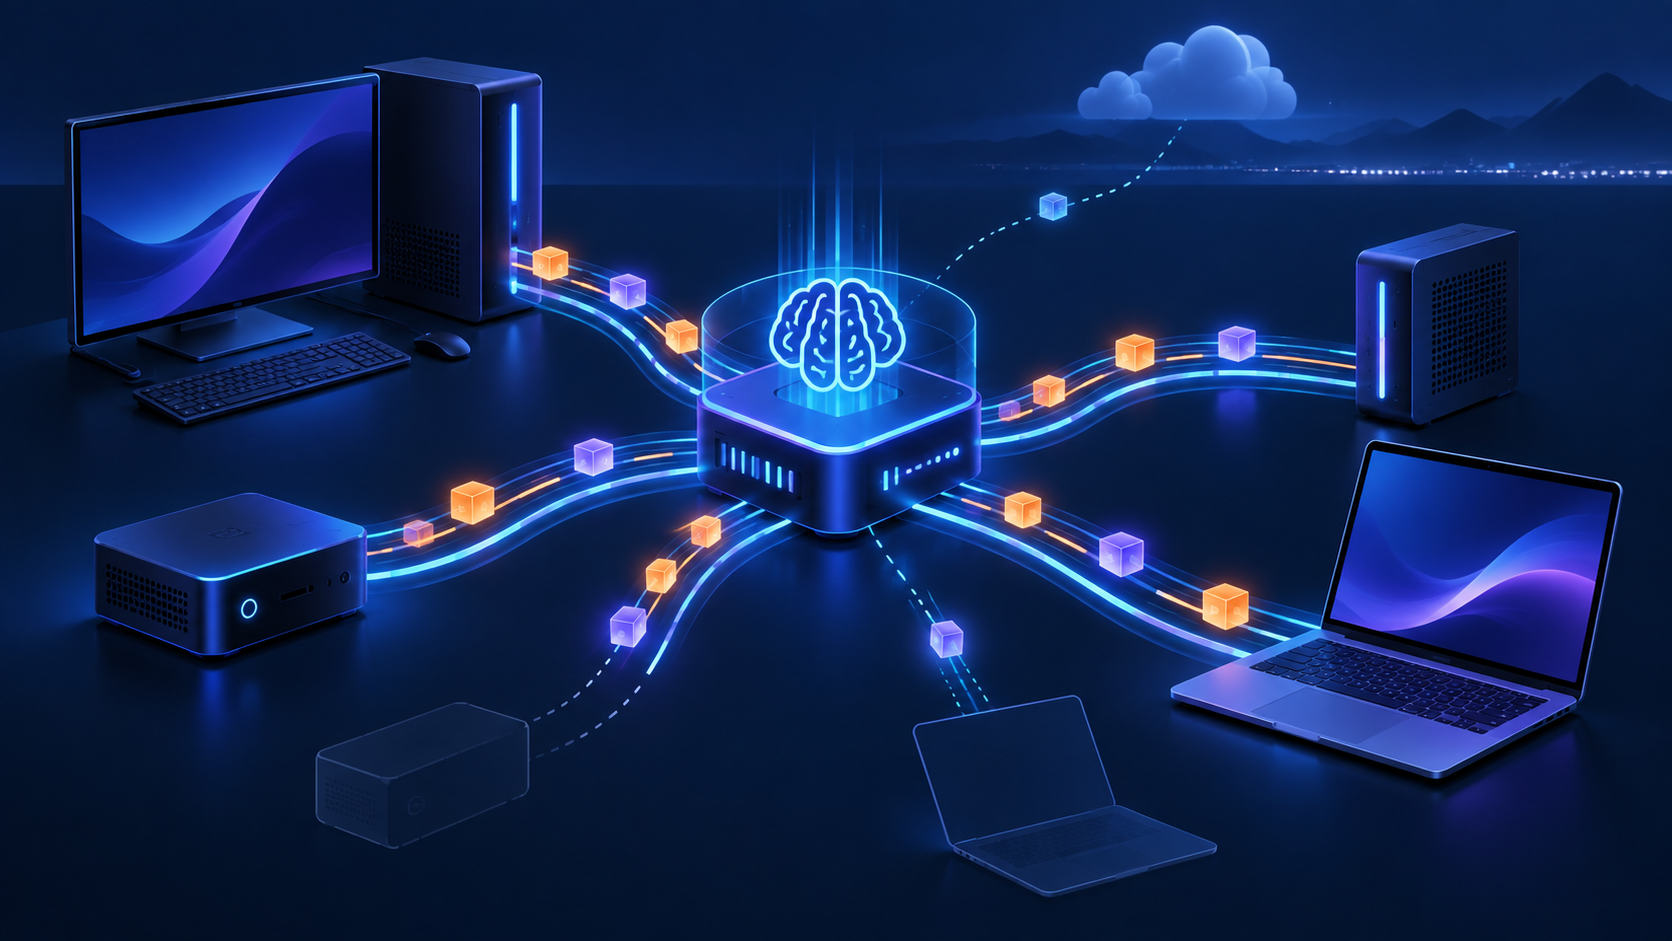
NVIDIA PAIRは、無料のオープンソースPersonal AI Routerです。ローカルネットワーク上の互換PCを自動検出し、独立した推論要求を処理能力に余裕がある端末へルーティングします。OllamaとLM Studioで動作し、端末がネットワークへ参加したり離脱したりしても構成を調整します。
エージェントが作業を複数サブタスクへ分けても、一つのGPUだけへ集中すれば待ち行列が生じます。PAIRは、メール分類などの独立ジョブを複数端末へ配り、メインPCをゲームや制作へ使う間はAI処理を別PCへ移せます。単一の大きなモデルを複数GPUへ分割する技術ではなく、独立した推論要求の配分として説明されています。
ベータ版はGUIとターミナルの両方を備え、Windows、macOS、Linuxで利用できます。対応はGeForce RTX 20シリーズ以降、Turing世代以降のRTX PRO、DGX Spark、Apple M4以降です。異なるOSやGPUを一つのネットワークへ加えられます。
複数PC化では、速度だけでなく運用も増えます。モデルと量子化の互換性、端末ごとのメモリ、接続切断時の再試行、重複実行、ネットワーク暗号化、ログの場所を確認します。PAIRが無料のOSSでも、電力、端末管理、モデル保存領域は別途必要です。
写真編集もローカルとクラウドを選択
CyberLink PhotoDirector AI PC Modeは、生成編集、高画質化、不要物除去、背景削除・置換、写真補正をアプリへ組み込みます。タスクに応じてローカルとクラウドを選べ、NVIDIA GPUではTensorRT-RTXとFP8で高速化します。
ローカル生成はトークン課金を気にせず試行でき、素材を端末に残しやすい利点があります。一方、モデルのダウンロード容量、VRAM、処理時間、クラウドへ切り替わる条件を確認する必要があります。AI PC ModeはRTX Sparkに合わせた提供予定で、記事公開時点のPhotoDirector 365すべてに同じ機能があるという意味ではありません。
RTX Spark PCは10月発売予定
RTX Spark搭載Windows PCは2026年10月発売予定です。既存OEM 6社の設計に加え、Acerは小型デスクトップのコンセプト、LenovoはYoga Pro 9nとYoga 9n 2-in-1を発表しました。記事公開時点では将来予定で、実機の価格や地域別構成は別途確認が必要です。
RTX Sparkは1ペタフロップスのRTX Blackwell GPU、最大128GBの統合メモリ、20コアGrace CPUを掲げます。薄型ノートの高性能処理と、小型デスクトップでの常時稼働エージェントを想定しています。Windows Agentフレームワークと組み合わせ、エージェントをOS制御下でバックグラウンド実行する構想です。
ゲーム、制作、AIエージェントを一台で扱う場合、最大仕様だけでなく持続性能、冷却、バッテリー、メモリ帯域、対応モデルを見る必要があります。常時稼働では、OS権限、スリープ、アップデート、ネットワーク切断後の復帰も評価対象です。
提供状態とデータ経路を表にして判断する
今回の発表には、提供済み、ベータ、近日対応、発売予定が混在します。PAIRはベータ、HermesのWindows設定は提供済みでLinuxは近日、Portable ComputerはLinux対応でWindowsは近日、RTX Spark PCは10月予定です。一つの「発表済み」でまとめると、導入計画を誤ります。
また、ローカルAIでもデータ経路は一つではありません。PAIRは家庭や社内ネットワーク内で要求を別端末へ送り、Portable Computerは許可後にクラウドへ委譲し、エージェントはSlackやGitHubへ結果を送る場合があります。保存場所と送信先を、モデル実行場所とは別に記録することが重要です。
評価は、代表タスクの品質、初回応答、スループット、同時実行、VRAM、消費電力、外部送信回数、復旧時間を同時に測ります。公開ベンチマークは候補を絞る材料であり、異なる倍率を一つの性能値へまとめず、実際の端末構成で確認します。
まとめ
NVIDIAのIFA 2026発表は、ローカルAIをモデル実行から運用基盤へ広げました。PAIRは複数PCへ独立推論を分散し、各アプリは設定を簡素化、RTX Sparkは新しい端末層を担います。導入時は倍率や最大仕様だけでなく、提供状態、互換性、データ送信、総電力を同じ表で比較することが重要です。