はじめに
NVIDIAが2026年5月22日、Nous Researchが開発した自己進化型AIエージェント「Hermes Agent」と、NVIDIA製ハードウェアとの組み合わせについて公式ブログで解説しました。本稿では、Hermesの4つの特長と、Alibaba製モデル「Qwen 3.6」がローカル環境にもたらす性能向上について紹介します。
参考記事
- タイトル: Hermes が NVIDIA RTX PC と DGX Spark を活用した自己改善型 AI エージェントを実現
- 著者: Abhishek Gore
- 発行元: NVIDIA 日本語公式ブログ
- 発行日: 2026年5月22日
- URL: https://blogs.nvidia.co.jp/blog/rtx-ai-garage-hermes-agent-dgx-spark/
関連記事
要点
- Nous Researchが開発したオープンソースのAIエージェント「Hermes Agent」は、公開から3か月足らずでGitHubスター数が14万を超え、OpenRouterが集計する世界で最も利用されているエージェントになっている
- Hermesは「自己進化型スキル」「独立したサブエージェント」「設計段階からの信頼性確保」「同モデルでより優れた結果」の4つの特長を持ち、デバイス上に常駐するエージェントを前提に設計されている
- AlibabのQwen 3.6 35Bモデルは約20GBのメモリで動作し、70GB以上を必要とする120Bパラメータモデルを凌駕する性能を発揮する
- NVIDIA DGX Sparkは128GBの統合メモリと1ペタフロップスのAI性能を備え、120Bパラメータ規模のモデルを24時間365日稼働させられる常時稼働型プラットフォームである
詳細解説
Hermesとは——世界最多利用のオープンソースエージェント
Nous Researchが開発したHermes Agentは、オープンソースのエージェント型AIフレームワークです。NVIDIAによれば、公開から3か月足らずでGitHubのスター数が14万を超え、先週時点のOpenRouterのデータで世界で最も利用されているエージェントになっています。OpenClawの成功に続く次世代オープンソースエージェントとして注目を集めており、この分野におけるコミュニティの動きが加速していると言えます。
Hermesの基本機能は、メッセージングアプリとの連携、ローカルファイルやアプリケーションへのアクセス、24時間365日の継続稼働です。他のエージェントとの大きな違いは、単なる薄いラッパーではなく「能動的なオーケストレーション層」として設計されている点で、リクエストへの都度応答ではなくデバイス上に常駐するエージェントを実現しています。
4つの特長——他フレームワークとの違い
NVIDIAの解説によると、Hermesには以下の4つの特長があります。
1点目は 自己進化型スキル です。複雑なタスクに遭遇したときやフィードバックを受けるたびに、学習内容をスキルとして保存します。使い続けるほど適応能力が高まり、自己改善を繰り返す仕組みです。
2点目は 独立したサブエージェント の活用です。サブタスクごとに、限定されたコンテキストとツールを持つ短命な独立ワーカーを生成します。これによりタスク構成が整理され、コンテキストウィンドウの肥大化によるエージェントの混乱を最小限に抑えます。ローカルモデルのように比較的小さいコンテキストウィンドウしか持たない環境でも動作しやすい設計だと思います。
3点目は 設計段階からの信頼性確保 です。Nous Researchは同梱されるすべてのスキル、ツール、プラグインを厳選してストレステストを実施しており、300億パラメータ規模のローカルモデルであっても、他の多くのフレームワークで必要とされるような絶え間ないデバッグ作業なしに動作するとしています。
4点目は 同モデルでより優れた結果 という点です。開発者による比較では、同一モデルを使った場合でもHermesは他のフレームワークより一貫して優れた結果を示しているとのことで、フレームワーク自体の設計品質がエージェント性能に直結することが示されています。
Qwen 3.6——ローカル環境での性能の飛躍
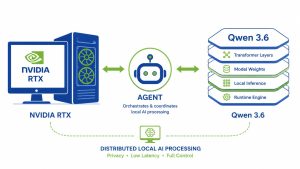
HermesをローカルAIとして動かす際に推奨されるのが、Alibabaが開発した Qwen 3.6 シリーズです。NVIDIAによれば、Qwen 3.6 35Bモデルは約20GBのメモリで動作しながら、70GB以上を必要とする120Bパラメータモデルを凌駕する性能を発揮します。また、Qwen 3.6 27Bは、Qwen 3.5の400Bクラスモデルと同等の精度を持ちながら、サイズはわずか16分の1に抑えられているとしています。
一般的に、大規模なパラメータ数はモデルの精度に直結しますが、その分だけメモリや計算リソースの要求も跳ね上がります。Qwen 3.6はMixture-of-Experts(MoE)アーキテクチャ(複数の専門モジュールを状況に応じて使い分ける構造)を採用することで、このトレードオフを大幅に改善したモデルと考えられます。NVIDIA Tensorコアを搭載したGPU上で動作することで、Hermesの複数ステップのタスク処理やスキル改良が「数分ではなく数秒」で実行可能になるとNVIDIAは説明しています。
NVIDIA DGX Spark——常時稼働型エージェントの基盤として
Hermesのような常時稼働型エージェントには、継続的な稼働に耐えるハードウェアが必要です。NVIDIAが推奨するのが、コンパクトなスタンドアロン型AIコンピューター「NVIDIA DGX Spark」です。
128GBの統合メモリと1ペタフロップスのAI性能を備えたDGX Sparkは、120Bパラメータ規模のMixture-of-Expertsモデルを終日稼働させることができます。Qwen 3.6 35Bは占有メモリが少ないため、従来モデルより高速に動作するだけでなく、並行してワークロードを走らせる余裕も生まれます。HermesとQwen 3.6、DGX Sparkの組み合わせにより、「AIがバックグラウンドで常に動き続ける」という形のパーソナルエージェント環境が現実的なものになってきたと言えます。
なお、DGX Spark上でHermesを利用する際の詳細手順は、NVIDIAが公開している「DGX Spark Playbook」(build.nvidia.com/spark)に整理されています。Hermesの実行自体は、GitHubリポジトリから入手し、LM StudioまたはOllamaと組み合わせることで開始できます。両ツールのサポートはHermesに標準で組み込まれています。
まとめ
Hermes Agentは、自己進化型スキルと独立サブエージェントの仕組みにより、ローカル常時稼働型エージェントの信頼性と実用性を大きく引き上げています。Qwen 3.6との組み合わせにより、NVIDIA RTXクラスのハードウェアでもデータセンター級の推論が現実的になりつつあります。Qwen 3.6の詳細なモデル仕様や能力については、以前の記事でも整理していますので、あわせてご覧いただければと思います。