はじめに
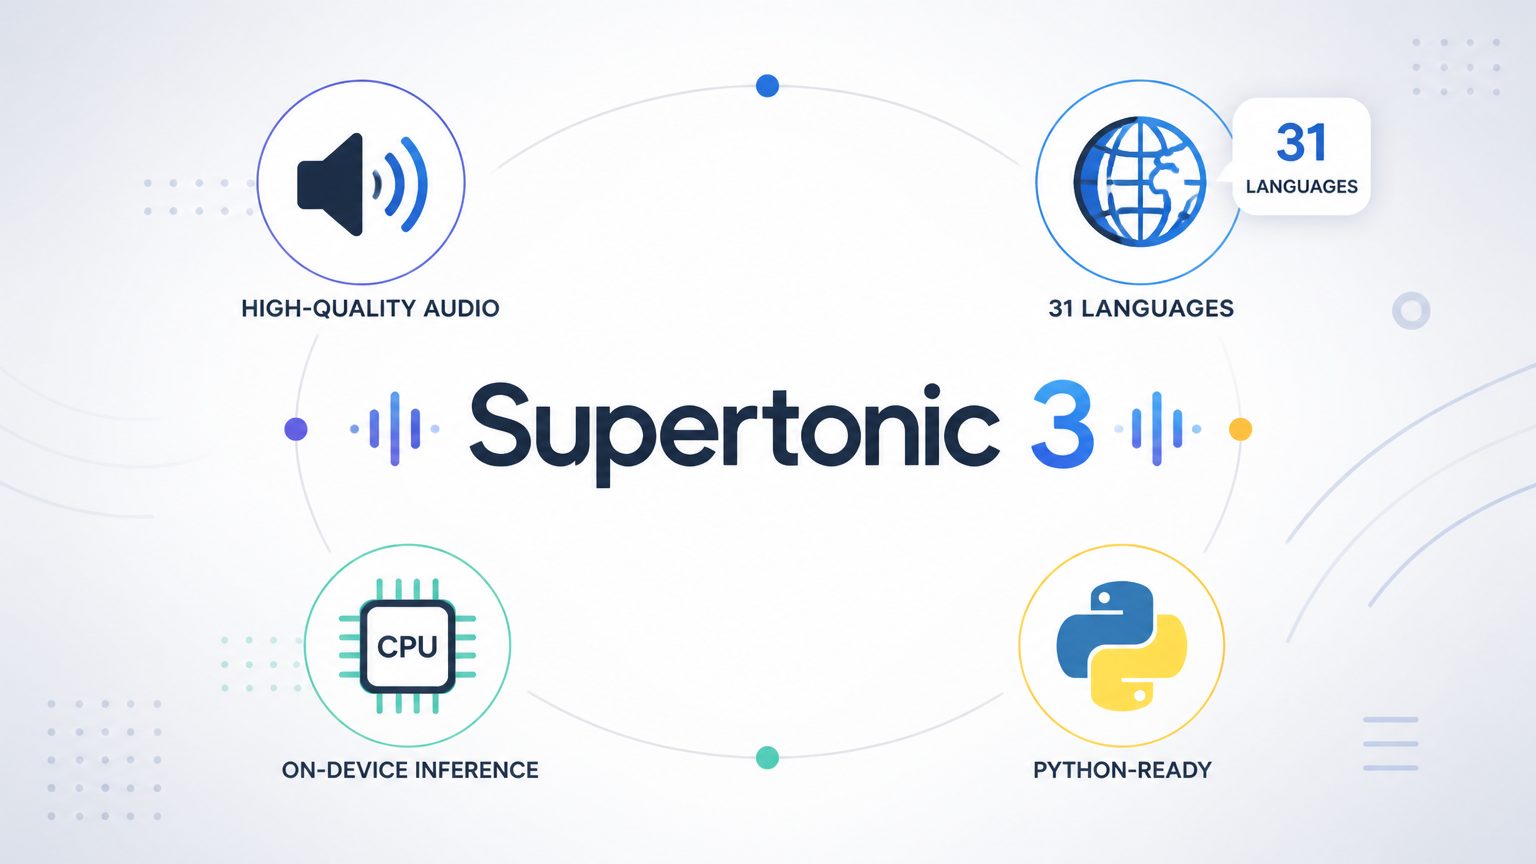
Supertone社が開発するオープンソースTTSシステム「Supertonic 3」が、2026年4月29日に公開されました。約9900万パラメータという軽量設計ながら31言語に対応し、クラウドへの接続なしにデバイス上で完結する音声合成を実現しています。本稿では、GitHubリポジトリとHugging Faceの公開情報をもとに、インストールから実装まで解説します。
参考記事
メイン記事:
- タイトル: Supertonic — Lightning Fast, On-Device, Accurate TTS
- 著者: Supertone Inc.
- 発行元: GitHub(supertone-inc/supertonic)
- 発行日: 2026年4月29日(Supertonic 3リリース日)
- URL: https://github.com/supertone-inc/supertonic
関連情報:
- タイトル: Supertonic 3 | Lightning Fast, On-Device, Accurate TTS
- 発行元: Hugging Face(Supertone/supertonic-3)
- 発行日: 2026年4月29日
- URL: https://huggingface.co/Supertone/supertonic-3
関連記事
要点
- Supertonic 3はONNX Runtimeをベースとした約9900万パラメータの軽量TTSモデルであり、クラウドAPIへの依存なしにデバイス上で完全動作する
- 31言語に対応し、言語コードを指定しない言語非依存モード(lang=”na”)も利用可能である
- Python、Node.js、ブラウザ(WebGPU)、Java、C++、C#、Go、Swift、iOS、Rust、Flutterなど11のランタイムSDKが提供されている
- 複数の読み上げ精度ベンチマーク(Minimax-MLS-test)では、0.7B〜2Bクラスの大規模モデルと競合する読み上げ精度(WER/CER)を記録した
- 10種類のエクスプレッションタグ(<laugh>、<breath> など)により、音声に自然な表情を付加できる
詳細解説
Supertonic 3 の概要
Supertonic 3は、韓国のAudio AIスタートアップ「Supertone」が開発するオープンソースのTTS(Text-to-Speech:テキスト音声合成)システムです。2026年4月29日のリリースにより、前バージョンの5言語対応から大幅に拡張し、31言語をサポートするようになりました。
本モデルの最大の特徴は、ONNX Runtime(オープンソースの機械学習推論エンジン)をベースとし、クラウドAPIへの接続を一切必要としない完全ローカル動作にあります。デスクトップ、ブラウザ、モバイル、Raspberry PiやEリーダーといったリソース制約の強いエッジデバイスでも動作するよう設計されており、GPUなしのCPUのみで推論可能です。モデルサイズは約9900万パラメータと、0.7B〜2Bクラスの大規模オープンTTSシステムと比較して大幅に軽量です。
Gemini TTSやOpenAI TTS-1はクラウドAPIベースの高性能モデルですが、Supertonicはこれらとは異なる「プライバシー優先・完全オフライン」という設計思想が特徴です。クラウドベースのTTS選択肢については GoogleのGemini 3.1 Flash TTSの解説でも整理していますので、比較参考としてご覧いただければと思います。
前提条件・環境構成
PythonのSDKを使ったシンプルなインストールに必要な環境は以下のとおりです。
- Python 3.8以上(推奨:Python 3.10以上)
- pip(Pythonのパッケージ管理ツール)
まず現在のPythonバージョンを確認します。
# Pythonのバージョンを確認するコマンドです
python --version
# または
注意: python コマンドが見つからない場合は python3 を試してください。macOS / Linuxでは python3 が標準の場合があります。
GitHubリポジトリから直接動かす場合は、Git LFS(Git Large File Storage:大容量ファイルを管理するGitの拡張機能)のインストールが必要です。モデルの重みファイルが大容量のため、通常の git clone だけではダウンロードできません。
# macOSの場合(Homebrewを使ったインストール)
brew install git-lfs && git lfs install
# その他のOSは https://git-lfs.com からインストーラーを入手してください
インストール・セットアップ
最もシンプルな方法は、PyPI(Pythonの公式パッケージ配布サービス)からPython SDKをインストールするものです。
ステップ1:パッケージのインストール
# supertonic パッケージをPyPIからインストールします
pip install supertonic
初回実行時、モデルデータがHugging Face(機械学習モデルの公開・共有プラットフォーム)から自動ダウンロードされます。モデルファイルはローカルにキャッシュされるため、2回目以降はすぐに起動します。
注意: 初回のモデルダウンロードにはインターネット接続が必要です。ダウンロード完了後はオフライン動作が可能になります。
ステップ2(オプション):リポジトリのクローン(全言語サンプルを試す場合)
# GitHubからリポジトリをクローンします
git clone https://github.com/supertone-inc/supertonic.git

# ディレクトリに移動します
cd supertonic

# Git LFSを初期化します(モデルの重みファイルをダウンロードするために必須)
git lfs install

# Hugging Face から Supertonic 3 のモデルファイルを assets ディレクトリにクローンします
git clone https://huggingface.co/Supertone/supertonic-3 assets
基本的な使い方(Python サンプル)
以下は、参考記事のリポジトリに掲載されているPythonでの基本的な音声合成コードです。
# supertonic ライブラリから TTS クラスをインポートします
from supertonic import TTS

# TTS インスタンスを作成します
# auto_download=True を指定すると、初回実行時にモデルを自動ダウンロードします
tts = TTS(auto_download=True)

# 使用するボイススタイルを取得します("M1" は男性ボイスのプリセット)
style = tts.get_voice_style(voice_name="M1")

# 読み上げるテキストを定義します
text = "Supertonic is a lightning fast, on-device TTS system."

# 音声を合成します
wav, duration = tts.synthesize(
    text=text,
    lang="en",          # 言語コード("en"=英語, "ja"=日本語, "ko"=韓国語など)
                        # 言語が不明な場合は lang="na" を指定すると自動処理されます
    voice_style=style,  # 上で取得したボイススタイルオブジェクト
    total_steps=8,      # 音質:5(低品質・高速)〜12(高品質・低速)、デフォルトは 8
    speed=1.05,         # 読み上げ速度:0.7(遅い)〜2.0(速い)
)
# wav: 形状 (1, サンプル数) の numpy 配列、サンプリングレート 44100Hz
# duration: 生成された音声の長さ(秒)を含む配列

# 音声ファイルとして保存します
tts.save_audio(wav, "output.wav")

print(f"Generated {duration[0]:.2f}s of audio")
上記コードは参考記事のサンプルをもとにしています。voice_name には “M1″〜”M5″(男性)、”F1″〜”F5″(女性)などのプリセットが使用できます。total_steps の値を上げると音質は向上しますが、生成時間も長くなります。
エクスプレッションタグの活用
Supertonic 3では、テキスト中に10種類の表情タグ(Expression Tags)を挿入することで、笑い声や息遣いなどの人間らしい表現を加えることができます。プロンプトエンジニアリングや参照音声の提供は不要です。
# エクスプレッションタグを使ったテキスト例(参考記事のサンプルに基づいています)
text_with_expression = “面白いことを言うね。<laugh> それなら、一緒に試してみましょうか。<breath>”
利用可能なタグは <laugh>(笑い)、<breath>(息遣い)、<sigh>(溜め息)など計10種類です。
ローカル HTTP サーバーとして利用する
2026年5月18日に追加された機能として、Python SDKをローカルHTTPサーバーとして起動し、HTTPリクエストで音声合成を呼び出せるようになりました。ローカルエージェント、ブラウザ拡張、Electronアプリなどとの連携に便利な機能です。OpenAIの音声APIと互換性のあるエンドポイントも提供されるため、既存のOpenAI TTS連携ツールをそのまま転用できる可能性があります。
インストール(serve機能つき)
# サーバー機能を含む追加パッケージをインストールします([serve] がオプション指定)

pip install 'supertonic[serve]'
サーバーの起動
# ローカル HTTP サーバーを 127.0.0.1 のポート 7788 で起動します
supertonic serve --host 127.0.0.1 --port 7788起動後、以下のエンドポイントが利用可能になります。
- POST /v1/tts — Supertonic 独自のネイティブエンドポイント
- POST /v1/audio/speech — OpenAI 互換エンドポイント
- http://127.0.0.1:7788/docs — インタラクティブなOpenAPIドキュメント(ブラウザで確認可能)
注意: サーバー起動中はターミナルウィンドウが占有されます。バックグラウンド実行が必要な場合は nohup コマンドや screen の利用を検討してください。
多言語対応と性能ベンチマーク
Supertonic 3はSupertonic 2の5言語から大幅に拡張し、日本語・英語・韓国語・アラビア語・ヒンディー語など31言語に対応しています。言語コードがわからない場合は lang=”na” を指定すると、モデルが言語を自動判別します。
読み上げ精度のベンチマークとして、Minimax-MLS-testを用いた評価結果がリポジトリで公開されています。精度はWER(Word Error Rate:単語誤り率)またはCER(Character Error Rate:文字誤り率)で測定し、数値が低いほど正確です。英語ではWER 2.06%を記録しており、VoxCPM2(2.11%)、OmniVoice(2.02%)、Qwen3-TTS(2.25%)と同等の水準です。99Mパラメータという軽量さでこの精度を実現している点は実用的だと思います。
また、テキスト正規化(数値・記号を自然な読み方へ変換する処理)の評価では、「$5.2M」「(212) 555-0142 ext. 402」「30kph」といった金融表現・電話番号・技術単位の読み上げで、ElevenLabs Flash v2.5、OpenAI TTS-1、Gemini 2.5 Flash TTS、VibeVoiceをすべて上回る結果がリポジトリ内のサンプルとともに報告されています。
多プラットフォームへの展開
Supertonic 3はPythonだけでなく、Node.js、ブラウザ(WebGPU)、Java、C++、C#、Go、Swift、iOS、Rust、Flutterの計11のランタイムSDKが提供されています。各環境の起動コマンドは以下のとおりです(参考記事リポジトリに掲載のサンプルコマンドをもとにしています)。
Node.js
# nodejs ディレクトリに移動して依存関係をインストールし、実行します

cd nodejs

npm install

npm start
ブラウザ(WebGPU/WASM)
# web ディレクトリで開発サーバーを起動します

cd web

npm install

npm run devGo(ONNX Runtime Cライブラリの事前インストールが必要)
# Goの依存関係をダウンロードして実行します

cd go

go mod download

go run example_onnx.go helper.go
注意: GoはONNX Runtime Cライブラリが必要です。macOSであれば brew install onnxruntime でインストールできます。JavaはJRE(実行環境)だけでなく JDK(開発キット)が必要です。C#は .NET 9以上が必要です。
ボイスクローニング(カスタムボイス)
このオープンウェイトリポジトリ自体にはボイスクローニング機能は含まれていませんが、Supertone社が提供する「Voice Builder」サービスを利用すると、短い参照録音から独自のボイスプロファイルを作成し、Supertonic 3用のJSONファイルとしてダウンロードできます。作成したJSONファイルをローカルのSupertonicに読み込むことで、自分の声でのTTSが実現します。なお、Voice Builderはダウンロード可能な形式としてSupertonic 2とSupertonic 3の両バージョンに対応しています。
まとめ
Supertonic 3は、約9900万パラメータという軽量さで31言語に対応し、クラウドなしでデバイス上で完結するオープンソースTTSシステムです。pip install supertonic の1行で始められる手軽さに加え、OpenAI互換のローカルHTTPサーバー機能も備えており、既存ワークフローへの組み込みやすさも高いと思います。クラウドAPIとの比較・補完の選択肢として、プライバシー優先の音声アプリ開発において検討する価値があるモデルだと思います。クラウドベースのTTS APIも含めた選択肢については、xAI Grok音声APIの解説もあわせてご覧いただければと思います。