はじめに
ZyphraがHugging Faceで公開した小型MoEモデル「ZAYA1-8B」は、活性パラメータ760M・総パラメータ8.4Bという小さなフットプリントながら、数学・コーディング・推論ベンチマークで119Bクラスのモデルと肩を並べる性能を示しています。本稿では、モデルの概要とベンチマーク結果、vLLMを使ったデプロイ手順を解説します。
参考記事
- タイトル: ZAYA1-8B(Hugging Face Model Card)
- 著者: Zyphra
- 発行元: Hugging Face / Zyphra
- 発行日: 2026年5月
- URL: https://huggingface.co/Zyphra/ZAYA1-8B
関連記事
要点
- ZAYA1-8Bは活性パラメータ760M・総パラメータ8.4BのMoEモデルであり、独自アーキテクチャと事前学習・後処理の革新によってパラメータ効率を高めている
- 数学ベンチマーク AIME’26 で89.1、コーディングベンチマーク LiveCodeBench-v6 で65.8を記録し、同規模の競合モデルを上回る性能を示した
- 総パラメータ数が小さいため、ローカルLLMアプリケーションへのオンデバイスデプロイが可能である
- ZyphraのvLLMフォークをインストールすることでデプロイでき、OpenAI互換APIとしてcurlやPythonから呼び出せる
詳細解説
ZAYA1-8Bの概要とアーキテクチャ
ZAYA1-8Bは、米国のAI企業Zyphraが開発・公開した小型のMoE(Mixture of Experts:複数の専門モジュールを動的に切り替えるニューラルネットワーク構造)言語モデルです。総パラメータ数は8.4Bですが、推論時に実際に使用される 活性パラメータは760M にとどまります。MoEアーキテクチャでは、入力に応じて使用する「エキスパート」を切り替えるため、全パラメータを常に稼働させる密なモデル(Dense model)と比べて推論コストを大幅に抑えられます。
Zyphraによれば、独自のアーキテクチャ設計に加えて、事前学習(プレトレーニング)と後処理(ポストトレーニング)の両段階で新たな工夫を施すことで、パラメータ数に対する知能効率を高めたとされています。今回公開されたのは推論強化版(Reasoning version)であり、ベースモデルは別途Hugging Faceで公開されています。
MoEを採用した大型モデルとしては DeepSeek-V4(1.6Tパラメータ) が知られていますが、ZAYA1-8Bはその対極に位置する超小型MoEという点でユニークです。総パラメータ数が小さいことから、クラウドサーバーだけでなくエッジデバイスやローカルマシンへのデプロイにも適していると考えられます。
ベンチマーク性能
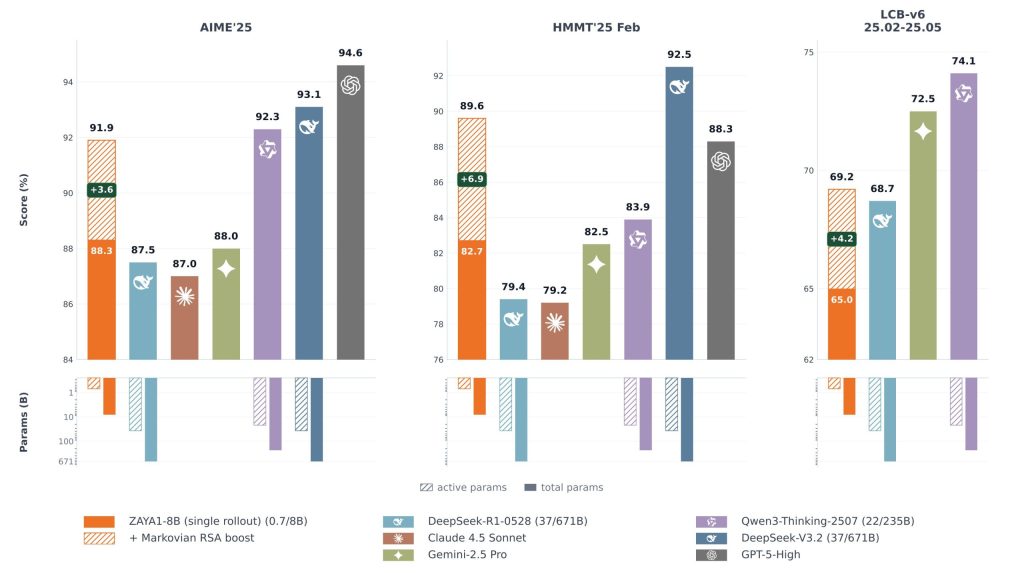
ZyphraはZAYA1-8Bを複数のベンチマークで評価しており、同規模モデルや大型モデルとの比較結果を公開しています(数値はすべてZyphraの評価ハーネスによるもの)。
同規模モデルとの比較(活性パラメータ約4B以下のオープンソース推論モデル):
| ベンチマーク | ZAYA1-8B | Qwen3-4B-Think | Qwen3.5-4B | Gemma-4-E4B |
| AIME’26(数学) | 89.1 | 77.5 | 84.5 | 50.3 |
| HMMT Feb.’26(数学) | 71.6 | 60.8 | 63.6 | 32.1 |
| IMO-AnswerBench(数学) | 59.3 | 50.9 | 48.7 | 27.3 |
| LiveCodeBench-v6(コーディング) | 65.8 | 54.2 | — | 54.2 |
| GPQA-Diamond(知識) | 71.0 | 66.5 | 76.2 | 57.4 |
| MMLU-Pro(知識) | 74.2 | 74.3 | 79.1 | 70.2 |
特に数学・コーディング領域での優位性が顕著です。一方、知識ベンチマーク(GPQA-Diamond・MMLU-Pro)ではQwen3.5-4Bが上回る結果も示されており、万能ではない点に留意が必要です。
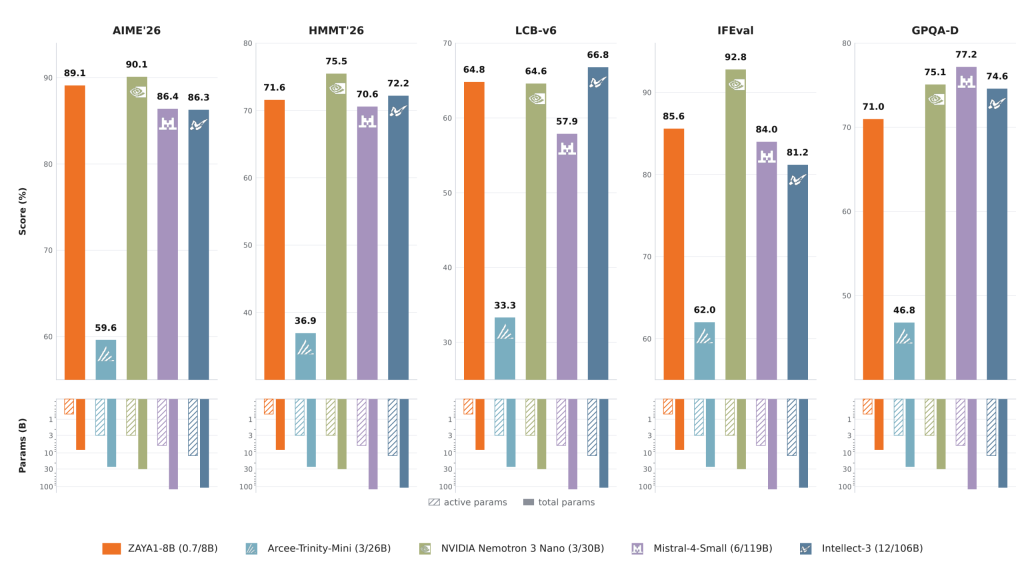
大型モデルとのスケール比較:
| モデル | 活性 | 総計 | AIME’26 | HMMT’26 | LCB-v6 |
| ZAYA1-8B | 0.7B | 8B | 89.1 | 71.6 | 63.8 |
| OLMo-3.1-32B-Think | 32B | 32B | 78.9 | 50.6 | 58.3 |
| Mistral-Small-4-119B | 6B | 119B | 86.4 | 70.6 | 57.9 |
ZAYA1-8B(総8B)は、OLMo-3.1-32BやMistral-Small-4-119Bと比較しても数学・コーディングスコアで同等以上の結果を示しています。ただし、これらの数値はZyphraの独自評価ハーネスによるものであり、第三者による独立した再現検証はまだ限られていることに留意が必要です。
前提条件・環境構成
ZAYA1-8Bを動作させるには、以下の環境が推奨されています。
必要な環境:
- Python 3.12(推奨; python –versionで確認)
- pip(Pythonパッケージ管理ツール; pip –versionで確認)
- CUDA対応GPU(VRAMの要件はモデルのサイズと量子化設定に依存)
- インターネット接続(GitHubからソースビルドするため)
# Pythonのバージョンを確認します(3.12以上が推奨)
python –version
# pipのバージョンを確認します
pip –version
注意: ZAYA1-8BはZyphraが独自にフォークした vLLM ライブラリを必要とします。PyPI公式の vLLM ではなく、GitHub上のZyphra製フォーク(zaya1-prブランチ)をインストールする必要がある点が通常の導入と大きく異なります。
インストール・セットアップ
Zyphraは新しいPython仮想環境(venv)での作業を推奨しています。仮想環境を使うことで、ほかのプロジェクトの依存関係と衝突するリスクを防げます。
1. 仮想環境の作成と有効化(推奨)
# 仮想環境を作成します(venvはPython標準の仮想環境ツールです)

python -m venv zaya_env

# 仮想環境を有効化します(Mac / Linuxの場合)

source zaya_env/bin/activate

# Windowsの場合は以下のコマンドを使用します

# zaya_env\Scripts\activate
2. ZyphraフォークのvLLMをインストール
以下のコマンドで、GitHub上のZyphra製vLLMフォーク(zaya1-prブランチ)を直接インストールします。ソースからのフルビルドが走るため、完了まで数分〜十数分かかる場合があります。
# Zyphra製vLLMをGitHubから直接ビルド・インストールします
# "@ git+..." はGitHubリポジトリから直接インストールする構文です
# "@zaya1-pr" がブランチ名を指定しています

pip install "vllm @ git+https://github.com/Zyphra/vllm.git@zaya1-pr"
注意: ビルドエラーが発生する場合は、GCCなどのCコンパイラ(Linux: build-essential、macOS: Xcode Command Line Tools)が正しくインストールされているか確認してください。
3. ZyphraフォークのTransformersをインストール(vLLM以外で実行する場合のみ)
HuggingFaceの transformers ライブラリ(テキスト生成や実験用途のPythonライブラリ)でZAYA1-8Bを動かしたい場合は、以下を追加でインストールします。
# Zyphra製transformersをGitHubから直接インストールします

# "@zaya1" がブランチ名です

pip install "transformers @ git+https://github.com/Zyphra/transformers.git@zaya1"
vLLMサーバーの起動
インストール完了後、以下のコマンドでvLLMサーバーを起動します。サーバーが立ち上がると、OpenAI互換のREST APIエンドポイントが利用できるようになります。
# vLLMサーバーをポート8010で起動します
# Zyphra/ZAYA1-8B ── HuggingFace上のモデル識別子
# --port 8010       ── サーバーのポート番号(任意の空きポートを指定できます)
# --mamba-cache-dtype float32 ── Mambaキャッシュの数値精度(安定性のためfloat32推奨)
# --dtype bfloat16  ── モデルの重みの数値精度(GPUメモリ節約と精度のバランス)
# --reasoning-parser qwen3 ── 思考プロセス(Chain-of-Thought)のパーサー設定
# --enable-auto-tool-choice ── 自動ツール選択を有効化
# --tool-call-parser zaya_xml ── ツール呼び出しの形式をZAYA1独自のXML形式に設定

vllm serve Zyphra/ZAYA1-8B --port 8010 \
   --mamba-cache-dtype float32 --dtype bfloat16 \
--reasoning-parser qwen3 --enable-auto-tool-choice --tool-call-parser zaya_xml並列デプロイの場合(8GPU環境の例):
TP(テンソル並列)は現在のブランチでCCAとの組み合わせがサポートされていないため、DP(データ並列)とEP(エキスパート並列)の組み合わせが推奨されています。8GPUで実行する場合は以下のフラグを追加します。
# 8GPU環境でDP=EP=8として並列起動する場合
# -dp 8 ── データ並列数を8に設定
# -ep   ── エキスパート並列を有効化

vllm serve Zyphra/ZAYA1-8B --port 8010 \
   --mamba-cache-dtype float32 --dtype bfloat16 \
   --reasoning-parser qwen3 --enable-auto-tool-choice --tool-call-parser zaya_xml \
-dp 8 -ep推奨サンプリングパラメータ(Zyphraの評価設定より):
- 汎用・評価用途: temperature=1.0, top_p=0.95, top_k=-1
- エージェント・コード用途: top_p=0.6
APIの呼び出し
サーバーが起動したら、curlやPythonからOpenAI互換APIとして呼び出せます。
# ローカルのvLLMサーバーにHTTPリクエストを送信します
# -H "Content-Type: application/json" ── データ形式をJSONに指定
# -d '...' ── リクエストボディ(モデル名と会話履歴をJSON形式で指定)

curl http://localhost:8010/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "Zyphra/ZAYA1-8B",
        "messages": [
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": "Hello. How is it going?"}
        ]
    }'
このAPIはOpenAI互換形式です。既存のOpenAI SDK対応コードのベースURLを http://localhost:8010/v1 に変更するだけで、ZAYA1-8Bへの切り替えが可能です。
注意: 上記のコードは参考記事のサンプルをもとにしています。実際の動作にはZyphraフォークのビルド完了と、十分なVRAMを持つGPU環境が整っている必要があります。うまく起動しない場合は、Zyphra GitHubリポジトリのIssueや pip show vllm でインストール済みパッケージのバージョンを確認してみてください。
まとめ
ZAYA1-8BはMoEアーキテクチャを活用し、活性パラメータ760Mという小さなフットプリントを保ちながら数学・コーディングで大型モデルに匹敵する性能を示した点が注目されます。オンデバイスデプロイの可能性もあり、エッジ推論への応用も期待されます。ただし評価はZyphra独自のハーネスによるものであり、今後の第三者検証が待たれます。小型オープンウェイトモデルの動向に関心がある方は、Qwen3.6-35B-A3Bの解説もあわせてご覧いただければと思います。