はじめに
Liquid AIが2026年、オンデバイス向けハイブリッドモデル「LFM2.5-8B-A1B」をHugging Face上で公開しました。総パラメータ数は8.3Bですが、推論時に使われるのは1.5Bのみというスパース設計が特徴です。本稿では、モデルの仕様・性能・各推論フレームワークでの動かし方を解説します。
参考記事
- タイトル: LFM2.5-8B-A1B
- 発行元: Liquid AI(Hugging Face モデルカード)
- URL: https://huggingface.co/LiquidAI/LFM2.5-8B-A1B
- タイトル: LFM2.5-8B-A1B(公式ドキュメント)
- 発行元: Liquid AI(docs.liquid.ai)
- URL: https://docs.liquid.ai/lfm/models/lfm25-8b-a1b
関連記事
要点
- LFM2.5-8B-A1Bは総パラメータ8.3B・活性パラメータ1.5BのMoEアーキテクチャを採用し、推論コストを大幅に抑えつつ高い性能を実現したモデルである
- 前世代モデルLFM2-8B-A1Bと比較してIFEvalが79.44→91.84(+12.40ポイント)、AIME25が20.00→42.53(+22.53ポイント)と広範なベンチマークで大幅な向上を記録している
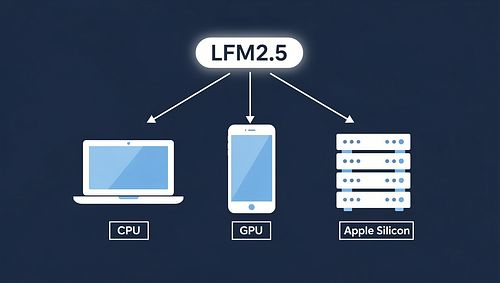
- Transformers・vLLM・llama.cpp・MLX・SGLangに初日から対応しており、CPU・GPU・Apple Siliconを問わずローカル環境で動かせる
- 128,000トークンのコンテキストウィンドウ、英語・日本語・中国語を含む9言語対応、ネイティブな関数呼び出し機能を備えており、エージェントワークフローへの組み込みに適している
詳細解説
モデルの概要とアーキテクチャ
LFM2.5-8B-A1Bは、Liquid AIが開発したオンデバイス向けハイブリッドモデルです。「ハイブリッド」とは、従来のトランスフォーマーアーキテクチャに加えて、Liquid Neural Network由来の畳み込み層(LIV conv)を組み合わせた構造を指します。全24層のうち18層が ダブルゲート LIV conv 、6層が GQA(Grouped Query Attention) という構成です。
このモデルの最大の特徴は MoE(Mixture of Experts:専門家の混合) 設計にあります。MoEとは、多数の「専門家」となるサブネットワークを持ちながら、各推論ステップでは一部だけを活性化する仕組みです。LFM2.5-8B-A1Bの場合、総パラメータは8.3Bあるものの、実際に演算に使われるのは1.5Bのみ。8B相当の表現力を持ちながら、1.5B相当の計算コストで推論できるという点が、オンデバイス展開における強みです。
主なスペックをまとめると以下のとおりです:総パラメータ8.3B / 活性パラメータ1.5B / コンテキスト長128,000トークン / 語彙サイズ128,000 / 対応言語:英語・アラビア語・中国語・フランス語・ドイツ語・日本語・韓国語・ポルトガル語・スペイン語。
前世代との性能比較
Liquid AIの発表によれば、LFM2.5-8B-A1BはLFM2-8B-A1Bと比較して、すべてのベンチマークで大幅に改善しています。特に注目される項目を以下に挙げます。
| ベンチマーク | LFM2-8B-A1B | LFM2.5-8B-A1B | 差分 |
|---|---|---|---|
| IFEval(命令追従) | 79.44 | 91.84 | +12.40 |
| IFBench | 26.00 | 56.47 | +30.47 |
| MATH500 | 74.80 | 88.76 | +13.96 |
| AIME25(数学競技) | 20.00 | 42.53 | +22.53 |
| BFCLv3(関数呼び出し) | 45.07 | 64.36 | +19.29 |
| Tau² Telecom(エージェント) | 13.60 | 88.07 | +74.47 |
IFEval は命令追従能力、AIME25 は数学オリンピック相当の推論力、BFCLv3 は関数呼び出し(ツールユース)の正確さを測るベンチマークです。特にエージェントタスクの指標である Tau² Telecom で13.60→88.07と約75ポイントの改善は顕著だと思います。
同規模帯の他モデルとの比較では、IFEvalにおいてQwen3-30B-A3B-Thinking(90.82)とほぼ同等の91.84を記録しており、実際の活性パラメータ数では3倍以上の差があることを考えると、効率面では優れていると言えます。
推奨されるユースケースと制約
Liquid AIは、このモデルを エージェントワークフロー・ツール呼び出し・構造化出力・多言語アシスタント・オンデバイスパーソナルアシスタント に適していると説明しています。一方、「重いプログラミングタスクや、検索なしのナレッジ集約型QAには最適ではない」とも明記されています。事前にユースケースを確認した上で採用を検討するのが安全だと思います。
前提条件・環境確認
実際にモデルを動かす前に、以下を確認してください。
# Pythonのバージョンを確認します(3.10以上を推奨)
python --version

# GPUが使える場合、CUDAのバージョンも確認します
nvidia-smi
注意: GPU(NVIDIA製)環境では device_map="auto" で自動的にGPUが使われます。GPU非搭載のCPU環境でも動作しますが、推論速度は大幅に低下します。
Transformersによるセットアップと実装
Transformers は、Hugging Faceが提供するPythonライブラリで、多様なAIモデルを共通のAPIで扱えます。最もシンプルな方法です。
1. 必要パッケージのインストール
# transformers(5.2.0以上)・PyTorch・accelerateをインストールします
# accelerate はモデルを複数GPUやCPUに自動分散するためのライブラリです
pip install "transformers>=5.2.0" torch accelerate
2. 基本的な推論コード
以下は、モデルをダウンロードしてテキストを生成する最小構成のコードです(参考記事のサンプルコードをもとにしています)。
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer

# モデルのIDを指定します(Hugging Face上の公開モデルです)
model_id = "LiquidAI/LFM2.5-8B-A1B"

# モデルをロードします。device_map="auto" でGPU/CPUを自動選択します
# dtype="bfloat16" はメモリ使用量を半精度に抑えるための設定です
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype="bfloat16",
    # attn_implementation="flash_attention_2"  # 対応GPUがある場合はコメント解除で高速化できます
)

# トークナイザーをロードします(テキストをモデルが扱える数値列に変換します)
tokenizer = AutoTokenizer.from_pretrained(model_id)

# 生成テキストをリアルタイムで表示するストリーマーを設定します
streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

# ユーザーの質問を定義します
prompt = "C. elegansとは何ですか?"

# チャットテンプレートを適用してトークン化します
# apply_chat_template でモデル固有のフォーマットを自動付与します
input_ids = tokenizer.apply_chat_template(
    [{"role": "user", "content": prompt}],
    add_generation_prompt=True,  # モデルの応答開始トークンを追加します
    return_tensors="pt",         # PyTorchテンソル形式で返します
    tokenize=True,
).to(model.device)

# テキストを生成します
output = model.generate(
    input_ids,
    do_sample=True,          # サンプリングを有効にします
    temperature=0.2,         # 値が低いほど出力が安定します(推奨値)
    top_k=80,                # 上位80件のトークンから選択します(推奨値)
    repetition_penalty=1.05, # 同じフレーズの繰り返しを抑制します
    max_new_tokens=8192,     # 最大生成トークン数です
    streamer=streamer,
)
注意: dtype="bfloat16" はNVIDIAのAmpere世代以降(RTX 30xx系など)またはApple Siliconで推奨されます。古いGPUでは float16 を指定してください。
llama.cppによるCPU・エッジ推論
llama.cpp は、CPUだけでLLMを動かすためのC++実装です。GPU非搭載の環境や、量子化(モデルを圧縮して軽量化する手法)による省メモリ推論に適しています。GGUF形式のモデルが必要です。
# llama.cppをHomebrewでインストールします(Mac/Linuxの場合)
brew install llama.cpp

# GGUFモデルをHugging Faceから直接ダウンロードして実行します
# -hf フラグ でHugging Faceから自動ダウンロードします
# -c 4096 でコンテキスト長を4096トークンに設定します
# --temp・--top-k・--repeat-penalty は推奨のサンプリングパラメータです
llama-cli -hf LiquidAI/LFM2.5-8B-A1B-GGUF -c 4096 --color -i \
    --temp 0.1 --top-k 50 --repeat-penalty 1.05
注意: Linuxでは brew の代わりに公式リポジトリからビルドする必要があります(cmake が必要)。Windowsでは winget install llama.cpp または公式バイナリを利用してください。
vLLMによる高スループット推論(GPU向け)
vLLM は、NVIDIAのGPUを使った高スループット推論に特化したライブラリです。複数のリクエストを同時処理するプロダクション用途向けです。
# vLLM 0.14をインストールします
pip install vllm==0.14
from vllm import LLM, SamplingParams

# モデルをvLLMでロードします
llm = LLM(model="LiquidAI/LFM2.5-8B-A1B")

# サンプリングパラメータを設定します
sampling_params = SamplingParams(
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.05,
    max_tokens=512  # 最大生成トークン数です
)

# 推論を実行します
output = llm.chat("機械学習とは何ですか?", sampling_params)
print(output[0].outputs[0].text)
Liquid AIの発表によれば、H100(NVIDIAの高性能GPU)1枚で1秒あたり最大18,500トークン(1日あたり16億トークン超)の出力が可能とのことです。
SGLangによるサーバー構築(OpenAI互換API)
SGLang は、OpenAI互換のAPIサーバーを立てるためのフレームワークです。既存のOpenAI SDKを使ったコードをそのままローカルモデルに向けられる点が便利です。
# SGLang 0.5.10以上をインストールします(uv はpipの高速代替ツールです)
uv pip install "sglang>=0.5.10"

# APIサーバーを起動します
# --tool-call-parser lfm2 でLFM2.5のツール呼び出し形式を有効にします
sglang serve \
    --model-path LiquidAI/LFM2.5-8B-A1B \
    --host 0.0.0.0 \
    --port 30000 \
    --tool-call-parser lfm2
サーバー起動後、OpenAI SDKからアクセスできます。
from openai import OpenAI

# ローカルサーバーをエンドポイントとして指定します
client = OpenAI(base_url="http://localhost:30000/v1", api_key="None")

response = client.chat.completions.create(
    model="LiquidAI/LFM2.5-8B-A1B",
    messages=[{"role": "user", "content": "機械学習とは何ですか?"}],
    temperature=0.3,
)

print(response.choices[0].message.content)
ツール呼び出し(Function Calling)の使い方
LFM2.5は ネイティブな関数呼び出し に対応しています。関数呼び出しとは、モデルが自分でAPIやツールを実行することを指し、エージェント構築の基本機能です。Liquid AIの仕様では、ツール定義をシステムプロンプトにJSON形式で渡す方法と、tokenizer.apply_chat_template() の tools= 引数で渡す方法の2つが提供されています。
デフォルトでは、モデルは <|tool_call_start|> と <|tool_call_end|> という特殊トークンに囲まれたPython関数呼び出し形式で出力します。JSON形式での出力が必要な場合は、システムプロンプトで明示的に指示することも可能です。
ツール呼び出しの流れは次の4ステップです:①ツール定義の提供 → ②モデルが関数呼び出しを出力 → ③コードで実行して結果を返す → ④モデルが結果をもとに最終回答を生成。
Apple Silicon(Mac)での実行
MLX形式を使うとApple Siliconに最適化された推論が可能です。LiquidAI/LFM2.5-8B-A1B-MLX-8bit が公開されており、Macで効率よく動かすことができます。
また、LM Studio(GUIアプリ)を使えばコードを書かずにGGUFモデルをMac上で動かすことも可能です。GUIアプリとして操作できるため、開発環境を整えていない方にも試しやすい選択肢です。
ファインチューニング
Liquid AIは、UnslothとTRLを使ったファインチューニング方法を公式ドキュメントで提供しています。対応している手法は、継続事前学習(CPT)・教師あり微調整(SFT)・直接選好最適化(DPO)・GRPOです。いずれもLoRA(低ランク適応)を使ったパラメータ効率的な手法が採用されており、フルファインチューニングと比べてGPUメモリを大幅に削減できます。
まとめ
LFM2.5-8B-A1Bは、8B相当の性能を1.5Bの推論コストで実現するMoEモデルです。llama.cpp・vLLM・MLXへの初日対応と128Kコンテキスト・多言語サポートにより、オンデバイスからサーバーまで幅広い環境で活用できます。エージェントやツール呼び出し用途には検討の価値があると思います。同規模のMoEモデルに関心がある方は、ZyphraのZAYA1-8Bを取り上げた記事もあわせてご覧いただければ幸いです。