はじめに
OpenAIのエンジニアリングチームが2026年4月22日、Responses APIにWebSocket接続モードを追加し、Codexなどのエージェントワークフローをエンドツーエンドで最大40%高速化したことを発表しました。本稿では、なぜAPIがボトルネックになったのか、WebSocketによる解決策の設計思想、そして実際の成果について解説します。
参考記事
- タイトル: Speeding up agentic workflows with WebSockets in the Responses API
- 著者: Brian Yu, Ashwin Nathan
- 発行元: OpenAI
- 発行日: 2026年4月22日
- URL: https://openai.com/index/speeding-up-agentic-workflows-with-websockets/
関連記事
要点
- Codexエージェントループでは、APIへの同期リクエストが積み重なることで、推論速度の向上が相殺されていた
- GPT-5.3-Codex-SparkはCerebrasの推論特化ハードウェアで1,000 TPS超を目標としており、API側のオーバーヘッド削減が必須となった
- WebSocket持続接続により、previous_response_idを通じて会話状態をインメモリキャッシュから再利用できるようになった
- トークン化・安全性分類・ルーティングなどの再処理を削減し、エンドツーエンドで最大40%の高速化を実現した
- Vercel AI SDK、Cline、Cursorなど主要な開発ツールがWebSocketモードを採用し、最大40%のレイテンシ削減を報告している
詳細解説
なぜAPIがボトルネックになったのか
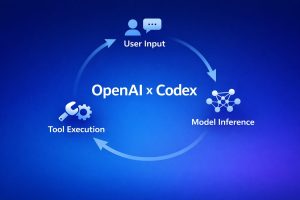
Codexエージェントループの仕組みを解説した過去記事でも触れたように、CodexがバグをFixする際には「コードベースのスキャン→ファイル読み込み→編集→テスト実行」というサイクルを繰り返します。裏側では「次のアクションを決定→ツール実行→結果をAPIに送信→繰り返す」という形で、Responses APIへの同期リクエストが何十回も発生します。
以前のフラグシップモデルであるGPT-5やGPT-5.2では推論速度が約65 TPS(トークン毎秒)だったため、API処理のオーバーヘッドは推論時間に隠れていました。しかし、CerebrasのLLM推論特化ハードウェアを採用したGPT-5.3-Codex-Sparkでは目標が1,000 TPS超と約15倍に引き上げられ、推論が速くなった分、APIのCPU処理が相対的に重いボトルネックへと変わりました。
OpenAIによれば、エージェントループの主な待ち時間は「APIサービス処理」「モデル推論(GPU上でのトークン生成)」「クライアント側処理(ツール実行・コンテキスト構築)」の3段階に分かれています。GPU推論が高速化されるほど、前後のCPU処理が相対的に目立つ構造的な問題があります。
最初のスプリント:単発リクエストの最適化
2025年11月頃、OpenAIはResponses APIの単一リクエストのレイテンシ改善に取り組みました。具体的には次の3点です。
まず、レンダリング済みトークンとモデル設定をメモリにキャッシュし、マルチターンレスポンスでの高コストなトークン化とネットワーク呼び出しを削減しました。次に、画像処理解決などの中間サービスへの呼び出しを廃止して推論サービスを直接呼び出し、ネットワークホップを削減しました。さらに、一部の安全性分類器を高速化し、会話のフラグ処理を迅速化しました。
これらの改善によりTime to First Token(TTFT、最初のトークンが返るまでの時間)は約45%改善されましたが、GPT-5.3-Codex-Sparkの速度には追いつけませんでした。
OpenAIが指摘するより根本的な問題は構造的なものでした。各リクエストを独立して処理しているため、会話履歴が長くなるほど毎回すべての履歴を再処理するコストが増大するという設計上の制約があります。
WebSocket持続接続の設計
この課題に対し、OpenAIはトランスポート層のプロトコルを見直しました。HTTPによる毎回の新規接続と全履歴の再送信ではなく、持続的な接続を維持して会話状態をキャッシュするアプローチです。
WebSocketとgRPC双方向ストリーミングが候補に挙がりましたが、最終的にWebSocketが採用されました。理由は、既存のResponses APIの入出力形式を変更せずに済む点でした。開発者は新たなAPIの形式を学び直す必要がなく、既存の実装との互換性を保てます。
最初のプロトタイプは「単一の長期Responseとしてエージェントロールアウトをモデル化する」設計でした。サンプリングループがツール呼び出し後に非同期でブロックし、response.doneイベントをクライアントに送信します。クライアントがツール実行後にresponse.appendイベントでツール結果を返すと、サンプリングループが再開される仕組みです。OpenAIはこれを「ウェブ検索などのホスト型ツール呼び出しと同じ仕組みをローカルツールに拡張したもの」と説明しています。
ただし、このプロトタイプはAPIの形式が複雑になるという課題がありました。そこで最終的にリリースされたバージョンでは、response.createという既存の形式を維持しつつ、previous_response_idを指定することで前回のレスポンス状態をキャッシュから継続する設計に変更されました。開発者視点では、パラメータを1つ追加するだけでWebSocketの恩恵を受けられる設計になっていると言えます。
キャッシュされる状態と実現した最適化
WebSocket接続上では、サーバーが接続スコープのインメモリキャッシュとして以下の状態を保持します。
- 前回のレスポンスオブジェクト
- 過去の入出力アイテム
- ツール定義と名前空間
- 再利用可能なサンプリング成果物(レンダリング済みトークンなど)
この再利用により、次のような最適化が実現されました。一部の安全性分類器とリクエストバリデーターが全履歴ではなく新規入力のみを処理するようになったほか、レンダリング済みトークンのインメモリキャッシュに追記するだけで不要なトークン化をスキップできます。また、成功したモデルのルーティングロジックをリクエスト間で再利用でき、請求処理などの非ブロッキングな後処理と後続リクエストの処理を並行実行できます。
OpenAIの説明では、これはAPIのレイテンシ構造が「シリアルなリクエストパイプライン」から「バリデーション・推論・後処理が重複実行される設計」へと変わったことを意味しています。前処理をロールアウト全体で1回だけ行い、ツール実行中は一時停止し、後処理もロールアウト終了後に1回だけ行うため、繰り返し発生していたコストが大幅に削減されます。
実際の成果と採用事例
2ヶ月間の開発スプリントを経てアルファリリースされたWebSocketモードは、主要なコーディングエージェントスタートアップが統合を進めました。OpenAIによれば、本番環境での成果は次の通りです。
- GPT-5.3-Codex-Sparkで目標の1,000 TPSを達成し、最大4,000 TPSのバーストを記録
- CodexはResponses APIトラフィックの大半をWebSocketモードに移行
- Vercel AI SDKがWebSocketモードを統合し、最大40%のレイテンシ削減
- Clineのマルチファイルワークフローが39%高速化
- CursorのOpenAIモデルが最大30%高速化
GPT-5.3-Codexに続きGPT-5.4以降のモデルもWebSocketモードの恩恵を受けるとされており、今後もアップデートが続くモデル世代に対してこの高速化基盤が引き継がれると考えられます。
この取り組みが示すのは、モデル推論そのものの高速化と、APIやインフラ側の最適化を同時に進める必要があるという点です。どちらか一方だけでは、ユーザーが体感できる速度改善には結びつかないと言えます。
まとめ
OpenAIは、Responses APIへのWebSocket対応によって推論速度の向上を実際のユーザー体験に結びつける仕組みを整えました。エンドツーエンドで最大40%の高速化を実現し、GPT-5.3-Codex-Sparkの1,000 TPS超という性能を実用レベルに引き上げています。エージェント開発でResponses APIを活用されている方は、コンピュータ環境対応について解説した記事もあわせてご参照いただければと思います。