はじめに
OpenAIが2026年2月5日、最も高度なエージェント型コーディングモデル「GPT-5.3-Codex」を発表しました。本稿では、OpenAIの公式発表とシステムカードをもとに、GPT-5.3-Codexの技術的性能、実装能力、安全性対策、そして開発現場への影響について解説します。
参考記事
メイン記事:
- タイトル: Introducing GPT-5.3-Codex
- 発行元: OpenAI
- 発行日: 2026年2月5日
- URL: https://openai.com/index/introducing-gpt-5-3-codex/
関連情報:
- タイトル: GPT-5.3-Codex System Card
- 発行元: OpenAI
- 発行日: 2026年2月5日
- URL: https://openai.com/index/gpt-5-3-codex-system-card/
要点
- GPT-5.3-Codexは、GPT-5.2-Codexのコーディング性能とGPT-5.2の推論・専門知識能力を統合し、25%高速化したモデルである
- SWE-Bench Pro、Terminal-Bench 2.0、OSWorld-Verifiedなど複数のベンチマークで業界最高性能を記録した
- コーディングだけでなく、デバッグ、デプロイ、ドキュメント作成、データ分析など、ソフトウェアライフサイクル全体とナレッジワークをサポートする
- OpenAIのPreparedness Frameworkにおいて、サイバーセキュリティ領域で初めてHigh capability分類を受け、予防的アプローチのもと包括的な安全対策が講じられている
- 有料ChatGPTプランでアプリ、CLI、IDE拡張、ウェブ経由で利用可能であり、API提供も準備中である
詳細解説
GPT-5.3-Codexの技術的位置づけ
OpenAIによれば、GPT-5.3-Codexは「最も高度なエージェント型コーディングモデル」として設計されました。このモデルは、GPT-5.2-Codexのフロンティアコーディング性能と、GPT-5.2の推論および専門知識能力を1つのモデルに統合しています。
従来のCodexモデルがコードの作成とレビューを主な機能としていたのに対し、GPT-5.3-Codexは長時間実行タスク、リサーチ、ツール使用、複雑な実行を含む作業に対応します。OpenAIは「同僚のように」と表現しており、作業中にステアリング(方向修正)と対話が可能で、コンテキストを失わずに進められる点が特徴です。
エージェント型AIとは、与えられた目標に向けて自律的に計画・実行・修正を繰り返すシステムを指します。GPT-5.3-Codexはこの能力を備えることで、単なるコード生成ツールから、開発者や専門家がコンピュータ上で行うほぼすべての作業をサポートするエージェントへと進化したと考えられます。
ベンチマーク性能と実用性能
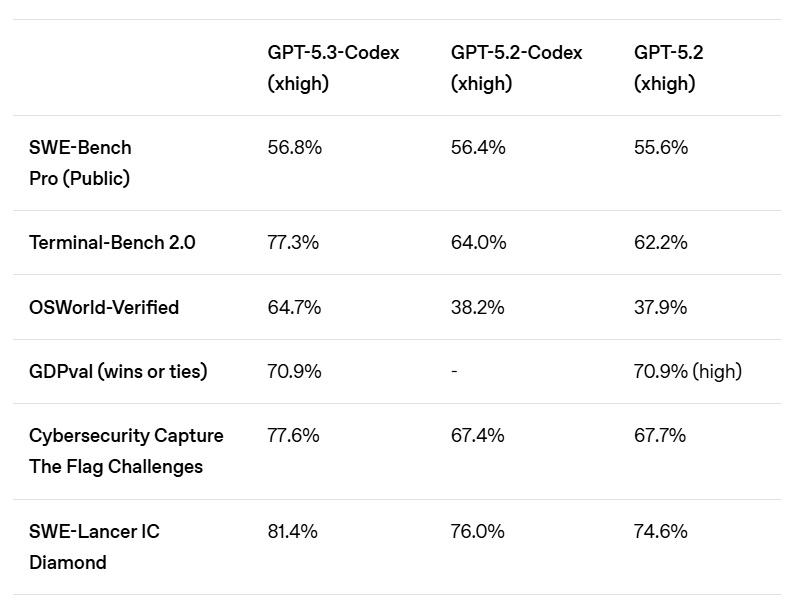
OpenAIの発表では、GPT-5.3-Codexは複数のベンチマークで業界最高性能を記録しました。
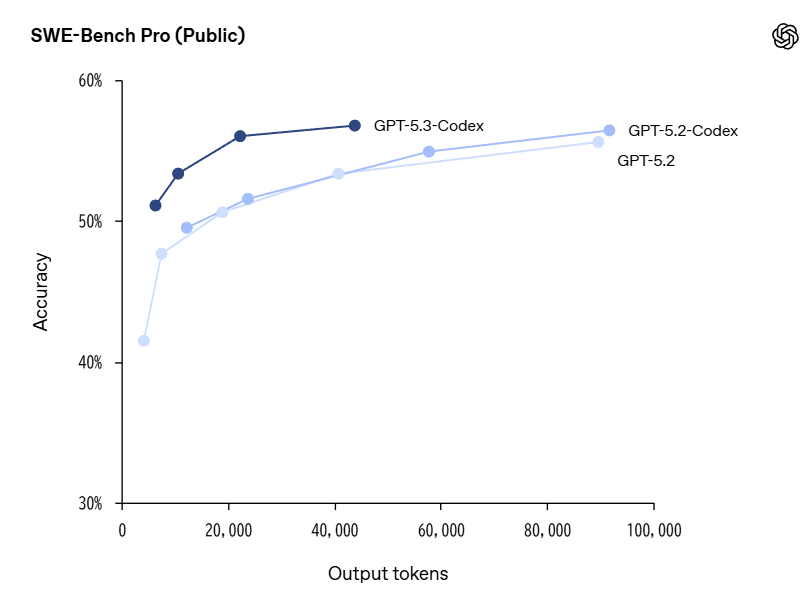
SWE-Bench Proでは56.8%の正解率を達成しています。SWE-Bench Proは実世界のソフトウェアエンジニアリングを評価する厳格なベンチマークで、従来のSWE-bench VerifiedがPythonのみをテストしていたのに対し、4つのプログラミング言語をカバーし、より汚染耐性が高く、多様で業界関連性の高い評価となっています。OpenAIによれば、GPT-5.3-Codexは従来モデルよりも少ないトークン数で高い性能を達成しており、これによりユーザーはより多くの構築作業が可能になります。
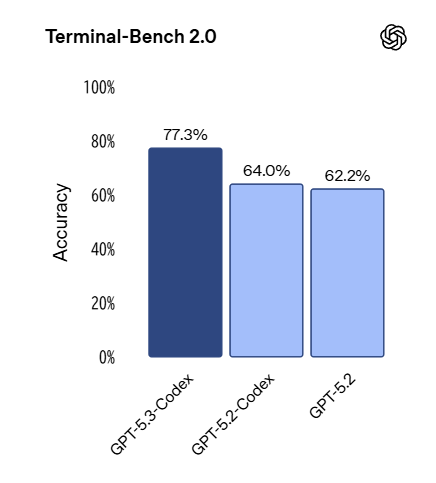
Terminal-Bench 2.0では77.3%の正解率を記録し、GPT-5.2-Codexの64.0%、GPT-5.2の62.2%を大きく上回りました。このベンチマークはCodexのようなコーディングエージェントに必要なターミナルスキルを測定するものです。ターミナル操作はコマンドライン環境での作業を指し、開発現場では不可欠なスキルと言えます。
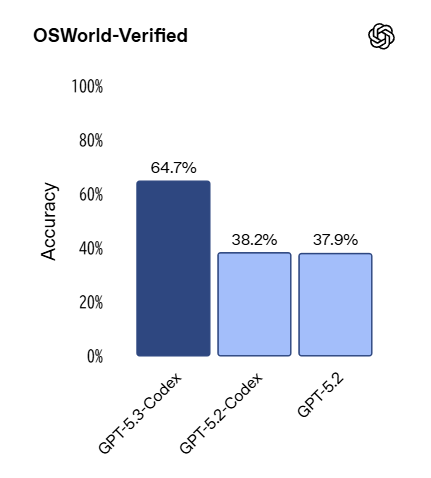
OSWorld-Verifiedでは64.7%の正解率を達成しました。これはビジュアルデスクトップコンピュータ環境で生産性タスクを完了するエージェント型コンピュータ使用ベンチマークで、モデルは視覚情報を使用して多様なコンピュータタスクを完了します。人間のスコアが約72%であることから、GPT-5.3-Codexは人間に近い水準でコンピュータ操作タスクをこなせると考えられます。
GDPvalでは70.9%のスコアを記録し、GPT-5.2と同等の性能を示しました。GDPvalはOpenAIが2025年にリリースした評価指標で、44の職種にわたる明確に定義されたナレッジワークタスクにおけるモデルのパフォーマンスを測定します。これにはプレゼンテーション、スプレッドシート、その他の作業成果物の作成が含まれます。この結果は、GPT-5.3-Codexがコーディング性能を大幅に向上させながら、汎用的な専門知識能力を維持していることを示しています。
ウェブ開発とゲーム制作能力
OpenAIは、GPT-5.3-Codexのウェブ開発能力を示すため、2つのゲーム制作実験を実施しました。モデルに対して「バグを修正して」「ゲームを改善して」といった一般的なフォローアッププロンプトを事前選択した上で、GPT-5.3-Codexは数百万トークンにわたってゲームを自律的に反復開発したとのことです。
制作されたのは、異なるレーサー、8つのマップ、スペースバーで使用できるアイテムを備えたレーシングゲームと、酸素・圧力・障害物を管理しながら様々なリーフを探索し魚図鑑を完成させるダイビングゲームです。これらは数日間かけて高度に機能的な複雑なゲームとアプリをゼロから構築する能力を示しています。
また、日常的なウェブサイト制作においても、GPT-5.3-CodexはGPT-5.2-Codexと比較してユーザーの意図をより適切に理解します。OpenAIの実験では、同じランディングページ制作プロンプトに対し、GPT-5.3-Codexは年間プランを割引後の月額料金として自動的に表示し、割引が明確で意図的に感じられるようにしました。また、1つではなく3つの異なるユーザー引用文を含む自動遷移する証言カルーセルを作成し、デフォルトでより完成度が高く本番環境に対応したページを生成しました。
フロントエンド開発においては、ユーザーの要求を適切に解釈し、実用的なデフォルト設定を提供する能力が重要と考えられます。この改善は、開発の初期段階での手戻りを減らし、より迅速なプロトタイピングを可能にすると思います。
コーディングを超えた専門業務のサポート
OpenAIは、GPT-5.3-Codexが「コードを生成する以上のことをする」と説明しています。ソフトウェアエンジニア、デザイナー、プロダクトマネージャー、データサイエンティストは、コード生成だけでなく、デバッグ、デプロイ、モニタリング、PRD(プロダクト要求文書)の作成、コピー編集、ユーザーリサーチ、テスト、メトリクス計測など、多岐にわたる作業を行います。
GPT-5.3-Codexはソフトウェアライフサイクル全体の作業をサポートするように構築されています。さらに、そのエージェント機能はソフトウェア開発を超え、スライドデッキの作成やスプレッドシートでのデータ分析など、ユーザーが構築したいものを何でも構築できるよう支援します。
OpenAIが示した具体例には、ウェルスマネジメント企業の金融アドバイザー向けに、定期預金と変額年金の比較に関する10枚のPowerPointプレゼンテーション、小売業のトレーニング文書、NPV(正味現在価値)分析スプレッドシート、ファッションプレゼンテーションPDFなどが含まれます。これらは専門的な知識とドメイン固有の理解を必要とするタスクです。
ソフトウェア開発現場では、実際にはコーディング以外の業務が多くの時間を占めています。仕様書作成、ドキュメント整備、データ分析、プレゼンテーション準備などをAIエージェントが支援できれば、開発者はより創造的な問題解決に集中できると考えられます。
インタラクティブな協働機能
OpenAIによれば、モデル能力が強力になるにつれ、エージェントが何をできるかではなく、人間が並行して作業する多数のエージェントをいかに簡単に対話、指示、監督できるかが課題となります。GPT-5.3-Codexを搭載したCodexアプリは、作業中に頻繁に更新を提供し、主要な決定と進捗状況を把握できるようにします。
従来は最終的な出力を待つ必要がありましたが、GPT-5.3-Codexではリアルタイムで対話できます。質問をしたり、アプローチを議論したり、解決策に向けて誘導したりすることが可能です。モデルは自身が行っていることを説明し、フィードバックに応答し、開始から終了まで常にユーザーを情報提供し続けます。
長時間実行タスクにおいては、途中経過の確認と軌道修正が重要です。GPT-5.3-Codexのこの機能は、エージェントが誤った方向に進むことを防ぎ、最終的な成果物の質を高めると思います。ユーザーはアプリの設定(Settings > General > Follow-up behavior)で、モデルの作業中にステアリングを有効にできます。
Codexによる自己開発の実例
OpenAIの発表で特筆すべき点は、GPT-5.3-Codex自体の開発にCodexが使用されたことです。OpenAIは「GPT-5.3-Codexは、自身を作成するのに役立った最初のモデル」と述べています。
Codexチームは初期バージョンを使用して、独自のトレーニングのデバッグ、独自のデプロイメントの管理、テスト結果と評価の診断を行いました。OpenAIのチームは、Codexが自身の開発をどれだけ加速できたかに驚いたとのことです。
具体的には、リサーチチームがCodexを使用してこのリリースのトレーニング実行を監視・デバッグしました。インフラストラクチャの問題をデバッグするだけでなく、トレーニング全体のパターンを追跡し、対話品質に関する詳細な分析を提供し、修正を提案し、モデルの動作が以前のモデルとどのように異なるかを人間の研究者が正確に理解するためのリッチなアプリケーションを構築しました。
エンジニアリングチームは、GPT-5.3-Codex用のハーネスを最適化および適応させるためにCodexを使用しました。ユーザーに影響を与える奇妙なエッジケースが発生し始めたとき、チームメンバーはCodexを使用してコンテキストレンダリングのバグを特定し、キャッシュヒット率の低さの根本原因を突き止めました。GPT-5.3-Codexは、トラフィックの急増に合わせてGPUクラスターを動的にスケーリングし、レイテンシーを安定させることで、ローンチを通じてチームを支援し続けています。
アルファテスト中には、ある研究者がGPT-5.3-Codexがターンごとにどれだけ追加作業を完了し、生産性にどのような差があるかを理解したいと考えました。GPT-5.3-Codexは、明確化、肯定的および否定的なユーザー応答、タスクの進捗の頻度を推定するための複数の単純な正規表現分類子を考案し、すべてのセッションログに対してスケーラブルに実行し、結論を含むレポートを作成しました。
AIモデルが自身の開発プロセスに貢献するという事例は、AI技術の成熟度を示す興味深い指標と言えます。これは単なる自動化ツールではなく、研究開発チームの生産性を根本的に変革する可能性を示唆していると考えられます。
サイバーセキュリティにおける高度能力と安全対策
OpenAIは、GPT-5.3-CodexをPreparedness Frameworkのもとでサイバーセキュリティ領域においてHigh capabilityとして分類する最初のモデルとしました。これはソフトウェアの脆弱性を特定するように直接訓練された最初のモデルでもあります。
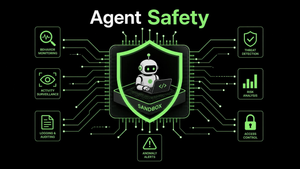
OpenAIによれば、エンドツーエンドのサイバー攻撃を自動化できるという決定的な証拠はありませんが、その可能性を排除できないため、予防的アプローチを採用しています。High capabilityのサイバーセキュリティに対する保護措置は、脅威アクターを阻止・妨害するように設計された階層的安全スタックに依存しており、同時にサイバー防御者がこれらの能力を可能な限り簡単に利用できるようにするとのことです。
具体的な緩和策には、安全性トレーニング、自動監視、高度な能力への信頼されたアクセス、脅威インテリジェンスを含む実行パイプラインが含まれます。
サイバーセキュリティは本質的に両用性(dual-use)を持つ領域です。同じ技術が防御にも攻撃にも使用できるため、OpenAIは証拠に基づく反復的アプローチを採用しています。このアプローチは、防御者が脆弱性を発見・修正する能力を加速しつつ、悪用を遅らせることを目的としています。
OpenAIはこの一環として、Trusted Access for Cyberというパイロットプログラムを開始し、サイバー防御研究を加速させています。また、セキュリティリサーチエージェントAardvarkのプライベートベータを拡大し、Codex Securityプロダクトおよびツールスイートの最初の提供としています。さらに、Next.jsなどの広く使用されているプロジェクトに対して無料のコードベーススキャンを提供するため、オープンソースメンテナーと提携しています。実際、先週、あるセキュリティ研究者がCodexを使用してNext.jsの脆弱性を発見し、開示されました。
2023年に開始した100万ドルのサイバーセキュリティ助成プログラムに加え、OpenAIは最も高度なモデルでサイバー防御を加速するために、1000万ドル相当のAPIクレジットをコミットしています。これは特にオープンソースソフトウェアと重要インフラシステムを対象としています。誠実なセキュリティ研究に従事する組織は、Cybersecurity Grant Programを通じてAPIクレジットとサポートを申請できます。
このようなエコシステム全体での保護措置は、高度なAI能力の安全な展開において重要なアプローチと考えられます。防御側への積極的な支援と悪用への多層的な対策を組み合わせることで、技術の恩恵を最大化しつつリスクを管理する姿勢が示されています。
生物学とAI自己改善の評価
システムカードによれば、GPT-5.3-Codexは生物学においてHigh capabilityとして扱われ、GPT-5ファミリーの他のモデルに使用される対応する保護措置スイートとともに展開されています。ただし、AI自己改善(AI self-improvement)についてはHigh capabilityには達していないとされています。
AI自己改善能力とは、AIシステムが自らの能力を自律的に向上させる可能性を指します。この能力が高度になると、人間による制御が困難になる可能性があるため、慎重な評価と管理が必要とされます。OpenAIがGPT-5.3-CodexをこのカテゴリーでHigh capabilityではないと評価したことは、現時点でのモデルの限界を明確にする重要な情報と言えます。
利用可能性とインフラストラクチャ
OpenAIによれば、GPT-5.3-Codexは有料ChatGPTプランで利用可能で、Codexを使用できるすべての場所(アプリ、CLI、IDE拡張機能、ウェブ)で使用できます。API経由でのアクセスも安全に有効化するため作業中とのことです。
今回のアップデートにより、OpenAIはインフラストラクチャと推論スタックの改善により、Codexユーザー向けにGPT-5.3-Codexを25%高速で実行しており、これによりより高速なインタラクションとより迅速な結果が得られます。
技術的な基盤として、GPT-5.3-CodexはNVIDIA GB200 NVL72システムで共同設計、トレーニング、提供されています。OpenAIはNVIDIAとのパートナーシップに感謝の意を表しています。NVIDIA GB200 NVL72は、NVIDIAの最新世代GPUシステムで、大規模AIモデルのトレーニングと推論に最適化された高性能プラットフォームです。
今後の展開と方向性
OpenAIは、GPT-5.3-Codexにより、Codexが「コードを書くことから、それをツールとして使用してコンピュータを操作し、作業をエンドツーエンドで完了することへと移行している」と述べています。
コーディングエージェントができることのフロンティアを押し広げることで、より広いクラスのナレッジワーク――ソフトウェアの構築とデプロイから、リサーチ、分析、複雑なタスクの実行まで――が解放されているとのことです。最高のコーディングエージェントであることへの焦点から始まったものが、コンピュータ上でのより一般的な協働者の基盤となり、誰が構築できるかとCodexで何が可能かの両方を拡大していると説明されています。
この方向性は、AIが特定の専門タスクから汎用的な作業支援へと進化していく過程を示していると考えられます。コーディングという専門領域での成功が、より広範な専門業務への適用の足がかりとなる可能性があります。
まとめ
OpenAIのGPT-5.3-Codexは、コーディング性能の向上だけでなく、汎用的な作業エージェントへの進化を示すモデルです。ベンチマークでの業界最高性能、長時間タスクへの対応、インタラクティブな協働機能、そして包括的な安全対策により、開発現場だけでなく広範な専門業務への適用が期待されます。サイバーセキュリティにおける予防的アプローチと防御側への積極的支援は、高度AI能力の責任ある展開の一例と言えます。今後、API提供が本格化することで、さらに幅広い活用事例が生まれると思います。