はじめに
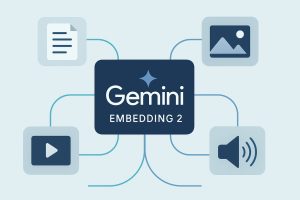
Google DeepMindが2026年4月22日、テキストだけでなく画像、動画、音声、文書を単一のベクトル空間に統合する「Gemini Embedding 2」の一般公開(GA)を発表しました。本稿では、プレビュー版を経て安定性と最適化が向上した本モデルの技術的特性と、マルチモーダルRAG(検索拡張生成)などの開発現場に与える影響について解説します。
参考記事
メイン記事:
- タイトル: Gemini Embedding 2 is now generally available
- 著者: Google DeepMind
- 発行元: Google
- 発行日: 2026年4月22日
- URL: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-embedding-2-generally-available/
関連情報:
- タイトル: Gemini Embedding 2: Our first natively multimodal embedding model
- 著者: Min Choi, Tom Duerig
- 発行元: Google
- 発行日: 2026年3月10日
- URL: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-embedding-2/
関連記事

要点
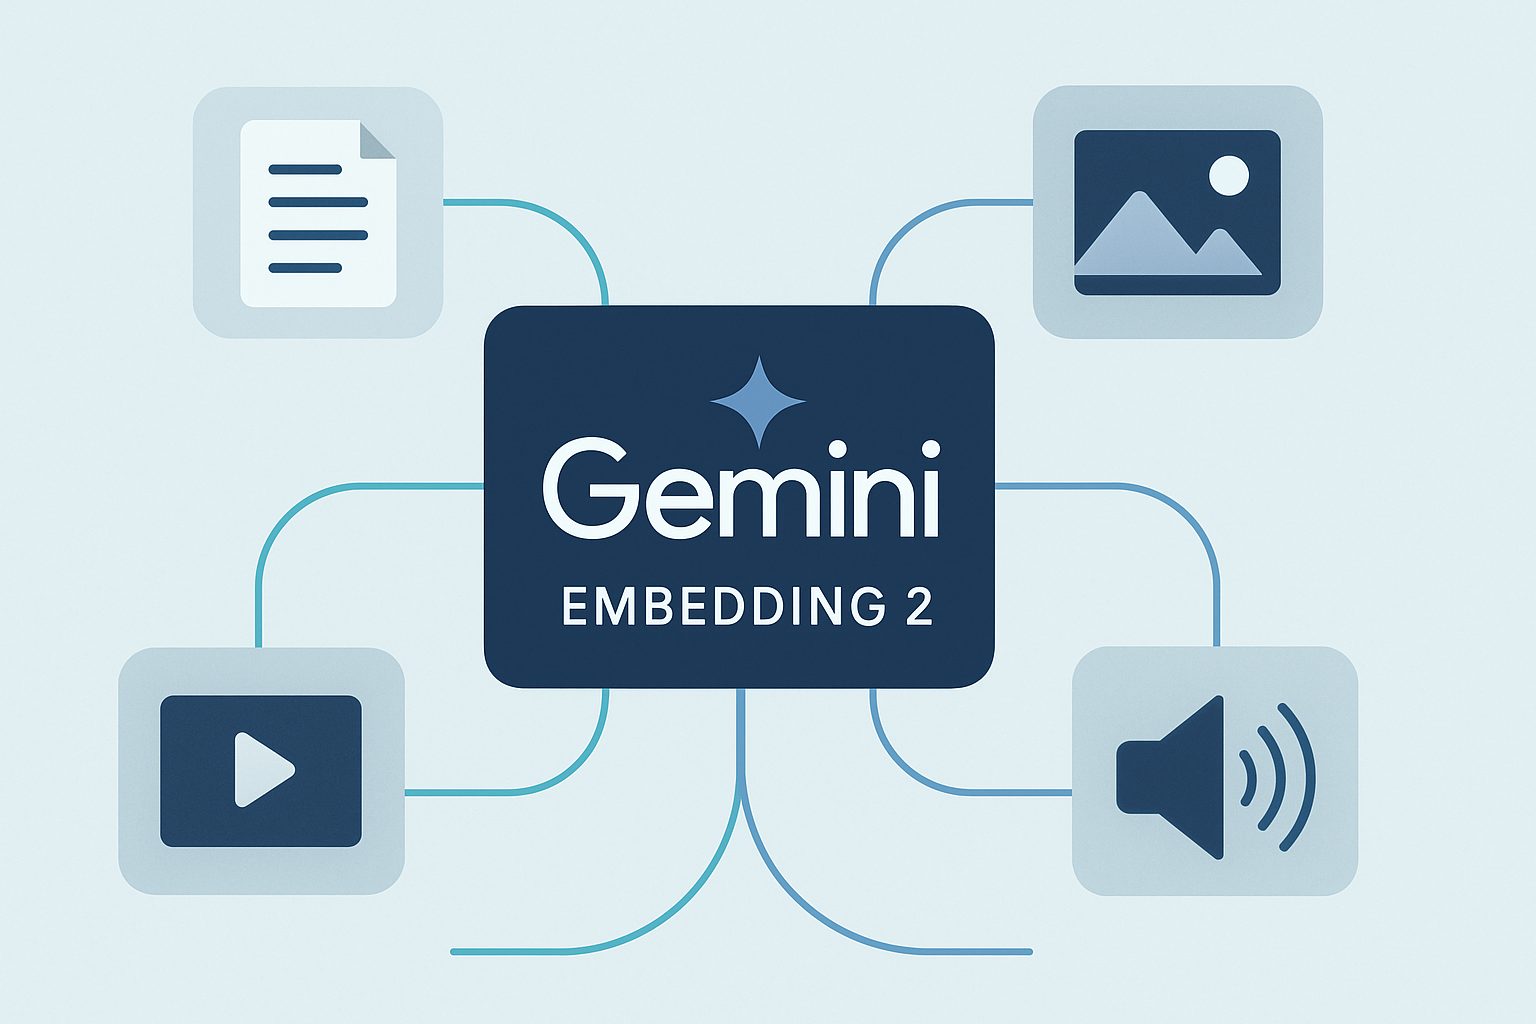
- Gemini Embedding 2は、異なるメディア形式を単一の埋め込み空間にマッピングできる、Google初のネイティブ・マルチモーダル埋め込みモデルである
- 2026年3月の公開からプレビュー期間を経て、Gemini APIおよびVertex AIで本番環境向けの一般公開(GA)が開始された
- テキスト(最大8,192トークン)に加え、画像、動画(最大120秒)、音声、PDFなどの文書を、翻訳等の工程を挟まず直接処理できる
- 出力次元数を柔軟にスケールダウンできる「Matryoshka Representation Learning(MRL)」を採用しており、精度とストレージコストの最適化が可能である
詳細解説
Gemini Embedding 2の一般提供と背景
Gemini Embedding 2が正式に一般提供(GA)されました。これまでプレビュー版として提供されてきたこのモデルは、開発者や企業がマルチモーダルな情報を扱うアプリケーションを構築するための基盤技術として位置づけられています。
埋め込み(Embedding)とは、AIが扱うデータ(テキストや画像など)をベクトル(数値の羅列)に変換する技術です。この数値化されたデータを用いることで、AIは「意味の近さ」を計算できるようになります。Gemini Embedding 2の重要性は、単一のデータ形式だけでなく、多様なマルチモーダルデータを共通のベクトル空間に投影できる点にあります。
マルチモーダルデータの統合検索
従来、テキスト、画像、動画、音声といった異なる形式のデータを横断的に検索・分析しようとすると、それぞれのデータ形式に対して個別のモデルや前処理パイプラインが必要でした。しかし、Gemini Embedding 2はこれらのデータをネイティブにサポートしているため、それらを統合的に処理できる可能性があります。
プレビュー期間中には、高度なeコマースのレコメンデーションエンジンや、効率的な動画解析ツールなど、多様なプロトタイプが開発されてきました。これらの事例は、マルチモーダルデータに対する深い推論と検索が、単一のパイプラインで実行できることの有用性を示しています。これまで複雑で分断されていたシステム構築が、よりシンプルかつ効率的に行えるようになると考えられます。
開発パイプラインの簡素化と実用化
今回の一般提供により、開発者は本番環境での安定した運用が可能となります。特に、これまで別々に管理・構築されていた推論パイプラインを統合できることは、運用コストや保守負荷の低減に大きく貢献すると言えます。
導入を検討する際は、自社のアプリケーションがどの程度のマルチモーダルデータを処理する必要があるのか、また、埋め込みモデルによってどの程度の検索精度が向上するかを検証することが重要だと思います。Gemini Embedding 2は、Googleの多くのプロダクトを支えるコア技術であるため、信頼性とスケーラビリティの面でも、企業用途での開発に適していると言えます。
マルチモーダル統合が実現する「真の意味理解」
Gemini Embedding 2はGeminiアーキテクチャを基盤として構築されており、テキスト、画像、動画、音声、そしてドキュメントをすべて「共通の座標空間」に配置することができます。従来のシステムでは、例えば動画を検索可能にするには一度テキストに要約(キャプション化)してから埋め込む必要がありましたが、本モデルではメディアそのものを直接ベクトル化します。
Googleは、これまでもGeminiモデルを用いた高度な言語処理技術を公開してきましたが(過去記事URL)、今回のモデルはそれらの「理解力」を検索や分類の基盤となる埋め込み表現に応用したものです。これにより、画像の中のオブジェクトとそれに関連する音声解説、あるいはテキストでの問いかけが、意味的に近いものとして正しく処理されるようになります。
開発の柔軟性を高める技術仕様とMRL
技術的な側面では、Gemini Embedding 2は非常に広範な入力に対応しています。テキストは最大8,192トークンのコンテキストをサポートし、動画は最大120秒、音声は中間的な文字起こしを介さずにネイティブに処理可能です。特筆すべきは、複数のモダリティ(例:画像+テキスト)を1つのリクエストで組み合わせて送信できる「インターリーブ入力」のサポートです。
また、運用コストの面で注目されるのが「Matryoshka Representation Learning(MRL)」の採用です。これは、情報の重要度をベクトル内の特定次元に「入れ子(マトリョーシカ)」のように格納する技術です。Googleによれば、デフォルトの3,072次元からスケールダウンしても高い精度を維持できるため、開発者はストレージ要件に合わせて次元数を調整できます。一般的に、ベクトル次元数が半分になればインデックスの保存コストも約半分になりますが、MRLはこのトレードオフを最小限の精度低下で管理できる手法として、大規模検索システムでの実用性が高いと言えます。
RAGとマルチモーダル検索の新たな可能性
プレビュー期間中、このモデルはeコマースの製品発見エンジンや効率的なビデオ分析ツールのプロトタイプ制作に活用されてきました。Googleの発表によれば、GA版では本番環境での稼働に耐えうる安定性と最適化が施されており、特にRAG(Retrieval-Augmented Generation)の構築において強力な武器となります。
これまでのRAGは主にテキストベースの資料を外部知識として活用してきましたが、Gemini Embedding 2を導入することで、社内の会議録画(音声・動画)やスライド資料(PDF・画像)をそのまま検索対象に含めることが可能になります。マルチモーダルな情報をそのまま「検索可能な資産」へと変換できる点は、企業のデータ活用における大きな転換点になると推測されます。また、100以上の言語に対応しているため、グローバル展開するアプリケーションでの一貫した精度も期待できるでしょう。
まとめ
Gemini Embedding 2の一般公開により、テキスト・画像・動画が入り混じる現実世界の複雑なデータを、よりシンプルかつ高精度に扱える環境が整いました。単なるモデルのアップデートに留まらず、次元数制御(MRL)によるコスト効率の向上など、商用利用を見据えた設計がなされている点が重要だと思います。
本モデルを活用した具体的な実装方法や、Gemini APIの最新仕様についてより深く知りたい方は、開発者向けドキュメントもあわせて確認することをお勧めします。