はじめに
OpenAIが2026年3月11日に発表した技術ブログによると、同社のResponses APIに新たなコンピュータ環境が追加されました。シェルツール、ホステッドコンテナ、エージェントスキルといった仕組みを組み合わせることで、開発者が複雑なエージェント型ワークフローを構築しやすくなる内容です。本稿では、その仕組みと実用上のポイントを解説します。
参考記事
- タイトル: From model to agent: Equipping the Responses API with a computer environment
- 著者: Bo Xu, Danny Zhang, Rohit Arunachalam
- 発行元: OpenAI
- 発行日: 2026年3月11日
- URL: https://openai.com/index/equip-responses-api-computer-environment/
要点
- OpenAIはResponses APIにシェルツールとホステッドコンテナを追加し、モデルがファイル操作・API呼び出し・コード実行などをエージェントループ内で自律的に行える環境を整備した
- シェルツールは既存のコードインタープリター(Python専用)と異なり、Go・Java・Node.jsなど幅広い言語やUnixコマンドを実行できる
- コンテナにはファイルシステム・データベース(SQLite)・ポリシー制御されたネットワークアクセスの3種類のコンテキストが用意されており、セキュリティを保ちながら外部リソースへアクセスできる
- コンパクション(文脈圧縮)機能により、長時間にわたるエージェントタスクでもコンテキストウィンドウの枯渇を防ぐ仕組みが組み込まれた
- エージェントスキルは繰り返し使われるワークフローのパターンをパッケージ化したもので、バージョン管理しながら再利用できる
詳細解説
モデルからエージェントへ——背景と課題
OpenAIの発表によれば、AIの活用は「特定タスクをこなすモデル」から「複雑なワークフローを処理するエージェント」へと移行しつつある段階にあります。エージェントを自前で実装しようとすると、中間ファイルの保存場所、大量データのプロンプトへの貼り付け、ネットワークアクセスのセキュリティ確保、タイムアウトや再試行の処理といった実務的な問題が複数浮かび上がります。
こうした課題を開発者が個別に解決しなくて済むよう、OpenAIはResponses APIにコンピュータ環境を直接搭載する形を選びました。プロンプトで呼び出せる訓練済みの知性にアクセスするだけでなく、ファイルやデータベース、外部APIを扱える実行環境をセットで提供するという考え方です。
シェルツールとエージェントループの仕組み
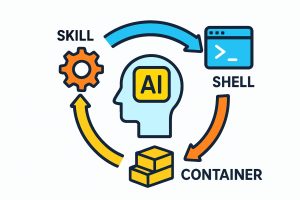
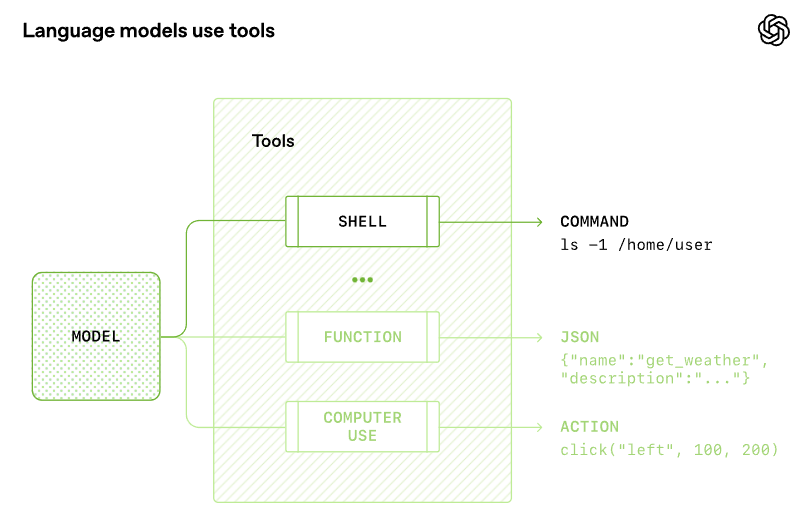
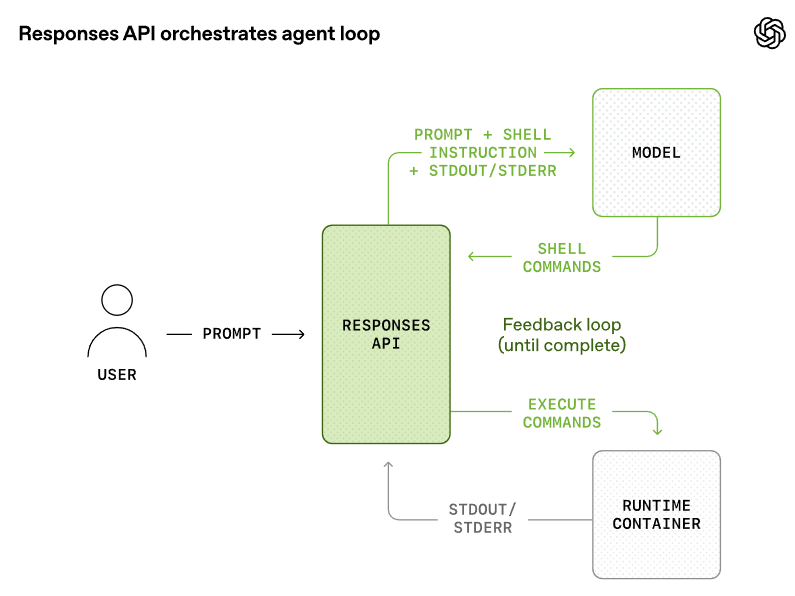
シェルツールは、モデルがコマンドラインを通じてコンピュータを操作するための仕組みです。モデルはあくまでコマンドを「提案」するだけで、実際の実行はResponses APIがコンテナ上で行います。grep・curl・awkといったUnixの標準ユーティリティに加え、Go・Java・Node.jsのプログラム実行やサーバー起動も可能です。これは従来のコードインタープリターがPythonの実行に限定されていた点と大きく異なります。
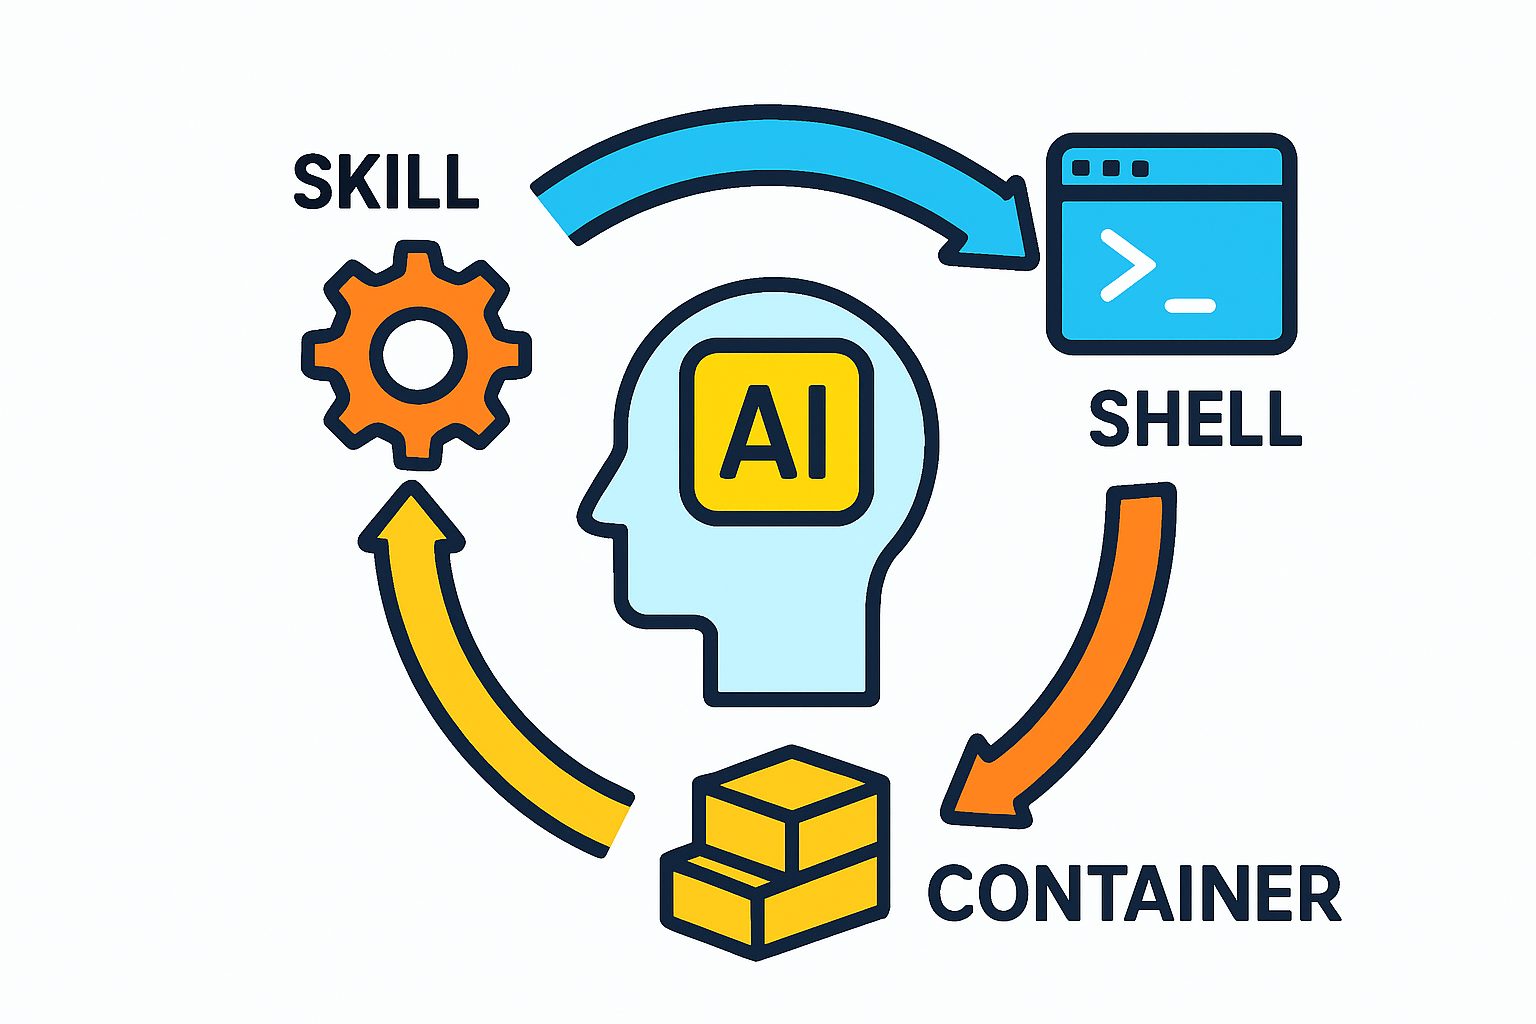
エージェントループの流れは、「モデルがコマンドを提案 → APIがコンテナ上で実行 → 結果をモデルに返す → 次のステップへ」という繰り返しです。Responses APIはこのループを内部でオーケストレーション(調整)するため、開発者が自前でループ処理を組む必要がありません。なお、シェルコマンドを提案できるのはGPT‑5.2以降のモデルとされています。
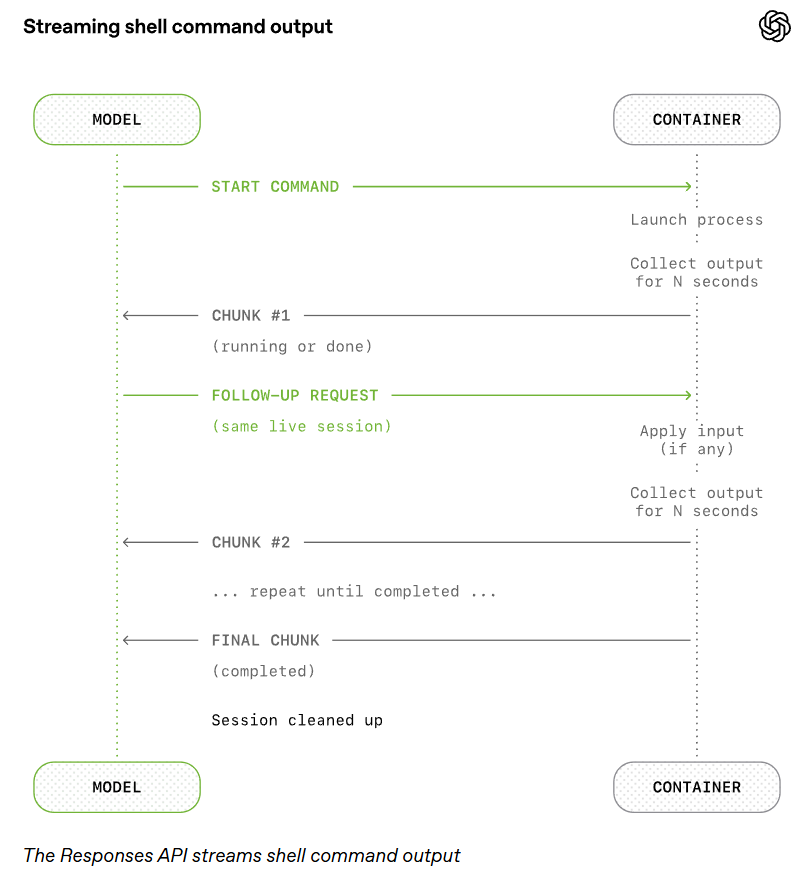
また、複数のシェルコマンドを並列実行することもでき、ファイル検索・データ取得・中間結果の検証といった処理を同時進行させることが可能です。出力が膨大になる場合には、コマンドごとに出力上限を設定して前後の内容を保持しつつ中間を省略する「バウンド出力」の機能も備わっています。これにより、コンテキストを無駄に消費することなく、モデルが必要な情報に集中できる設計になっています。
コンテナが提供する3つのコンテキスト
ホステッドコンテナはコマンドを実行する場所であるだけでなく、モデルが作業する際の「作業デスク」としての役割を担います。提供されるコンテキストは大きく3つに分かれます。
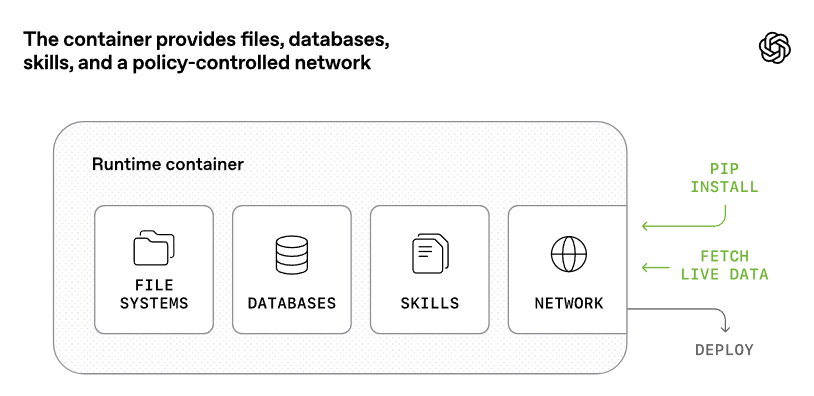
ファイルシステムは、入力データや中間ファイルを整理して格納する場所です。すべての入力をプロンプトに詰め込む「アンチパターン」ではなく、必要なファイルをコンテナ上に用意しておき、モデルが適切なシェルコマンドで取得・変換する形を推奨しています。人間が整理された情報を扱いやすいのと同様に、モデルも構造化されたデータの方が効率よく処理できると考えられます。
データベースは、構造化データをSQLiteなどの形式で格納し、モデルが必要な行だけをクエリで取得できるようにするものです。例えば「今四半期に売上が減少した商品はどれか」という問いに対し、スプレッドシート全体をプロンプトに貼り付けるのではなく、該当行だけをSQLで取得させることができます。処理速度・コスト・スケーラビリティの面で有利と言えます。
ネットワークアクセスは、外部APIへのリクエストやパッケージのインストールを可能にしつつ、セキュリティリスクを抑える仕組みです。すべてのアウトバウンド通信は一元的なポリシーレイヤー(エグレスプロキシ)を経由し、許可リストに基づくアクセス制御が行われます。APIキーなどの認証情報はモデルやコンテナからは見えないプレースホルダーとして扱われ、実際の値は承認済みの送信先にのみ適用されます。これにより、認証情報の漏洩リスクを低減しながら外部への認証リクエストが可能になっています。
コンパクション——長時間タスクへの対応
エージェントが長時間稼働すると、やり取りの履歴がコンテキストウィンドウを埋め尽くし、以降の処理に支障が出るという問題が生じます。この課題に対し、OpenAIはResponses APIにネイティブのコンパクション機能を組み込みました。
最新モデルは過去の会話履歴を分析し、重要な情報を暗号化されたトークン効率の高い形式に圧縮する「コンパクションアイテム」を生成するよう学習されています。圧縮後は、このアイテムと直前ウィンドウの重要部分だけが次のコンテキストに引き継がれます。サーバーサイドでの自動実行に加え、独立した/compactエンドポイントからも利用でき、閾値の設定によって圧縮タイミングを制御できます。
OpenAIによれば、コーディングエージェントのCodexがこのコンパクション機能の開発にも関わっており、Codex自身が長時間タスクを継続するための基盤として活用されているとのことです。
エージェントスキル——再利用可能なワークフローの部品化
繰り返し発生する多段階の処理パターンをエージェントが毎回ゼロから再学習するのは非効率です。そこで設計されたのがエージェントスキルです。スキルはフォルダ単位のパッケージで、SKILL.md(メタデータと手順を記述)と関連リソース(APIスペックやUIアセットなど)で構成されます。
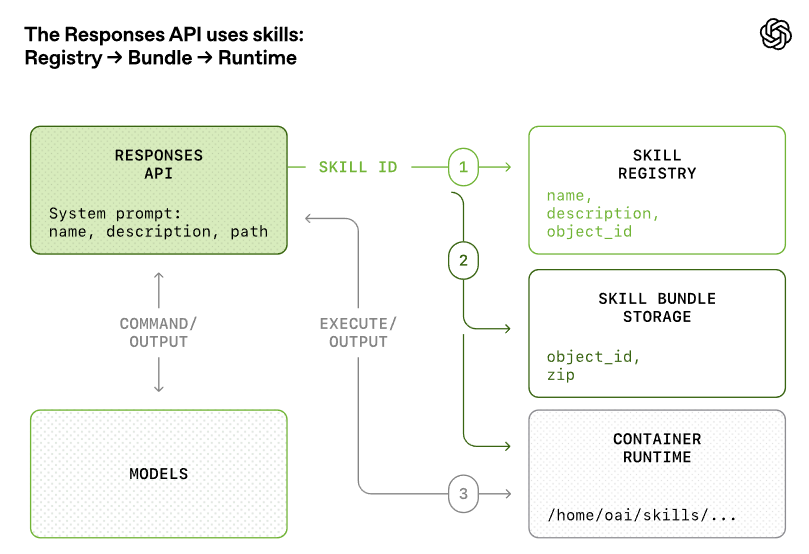
Responses APIはプロンプト送信前にスキルを読み込み、メタデータとコンテナパスをモデルのコンテキストに含めます。処理の流れは「スキルメタデータの取得 → バンドルのコンテナへの展開 → モデルコンテキストの更新」という順序で決定的に実行されます。モデルはシェルコマンドでスキルの内容を探索し、必要に応じてスクリプトを実行します。スキルはバージョン管理された形でOpenAIのプラットフォームに登録・取得できるAPIも提供されています。
スキルによって、ワークフローのパターンが標準化されるため、実行結果の一貫性が高まると考えられます。たとえば、ライブデータの取得 → ローカルのSQLiteへの格納 → 集計クエリの実行 → スプレッドシートとしての出力、といった一連の流れを1つのプロンプトから再現性高く実行できるようになります。
まとめ
OpenAIがResponses APIに追加したシェルツール・ホステッドコンテナ・スキル・コンパクションは、エージェント開発の実務的な課題を一体的に解消しようとする取り組みです。モデルの推論能力と実行環境を組み合わせることで、より複雑な業務ワークフローへの応用が広がると考えられます。今後のモデルバージョンと合わせた進化にも注目したいところです。