はじめに
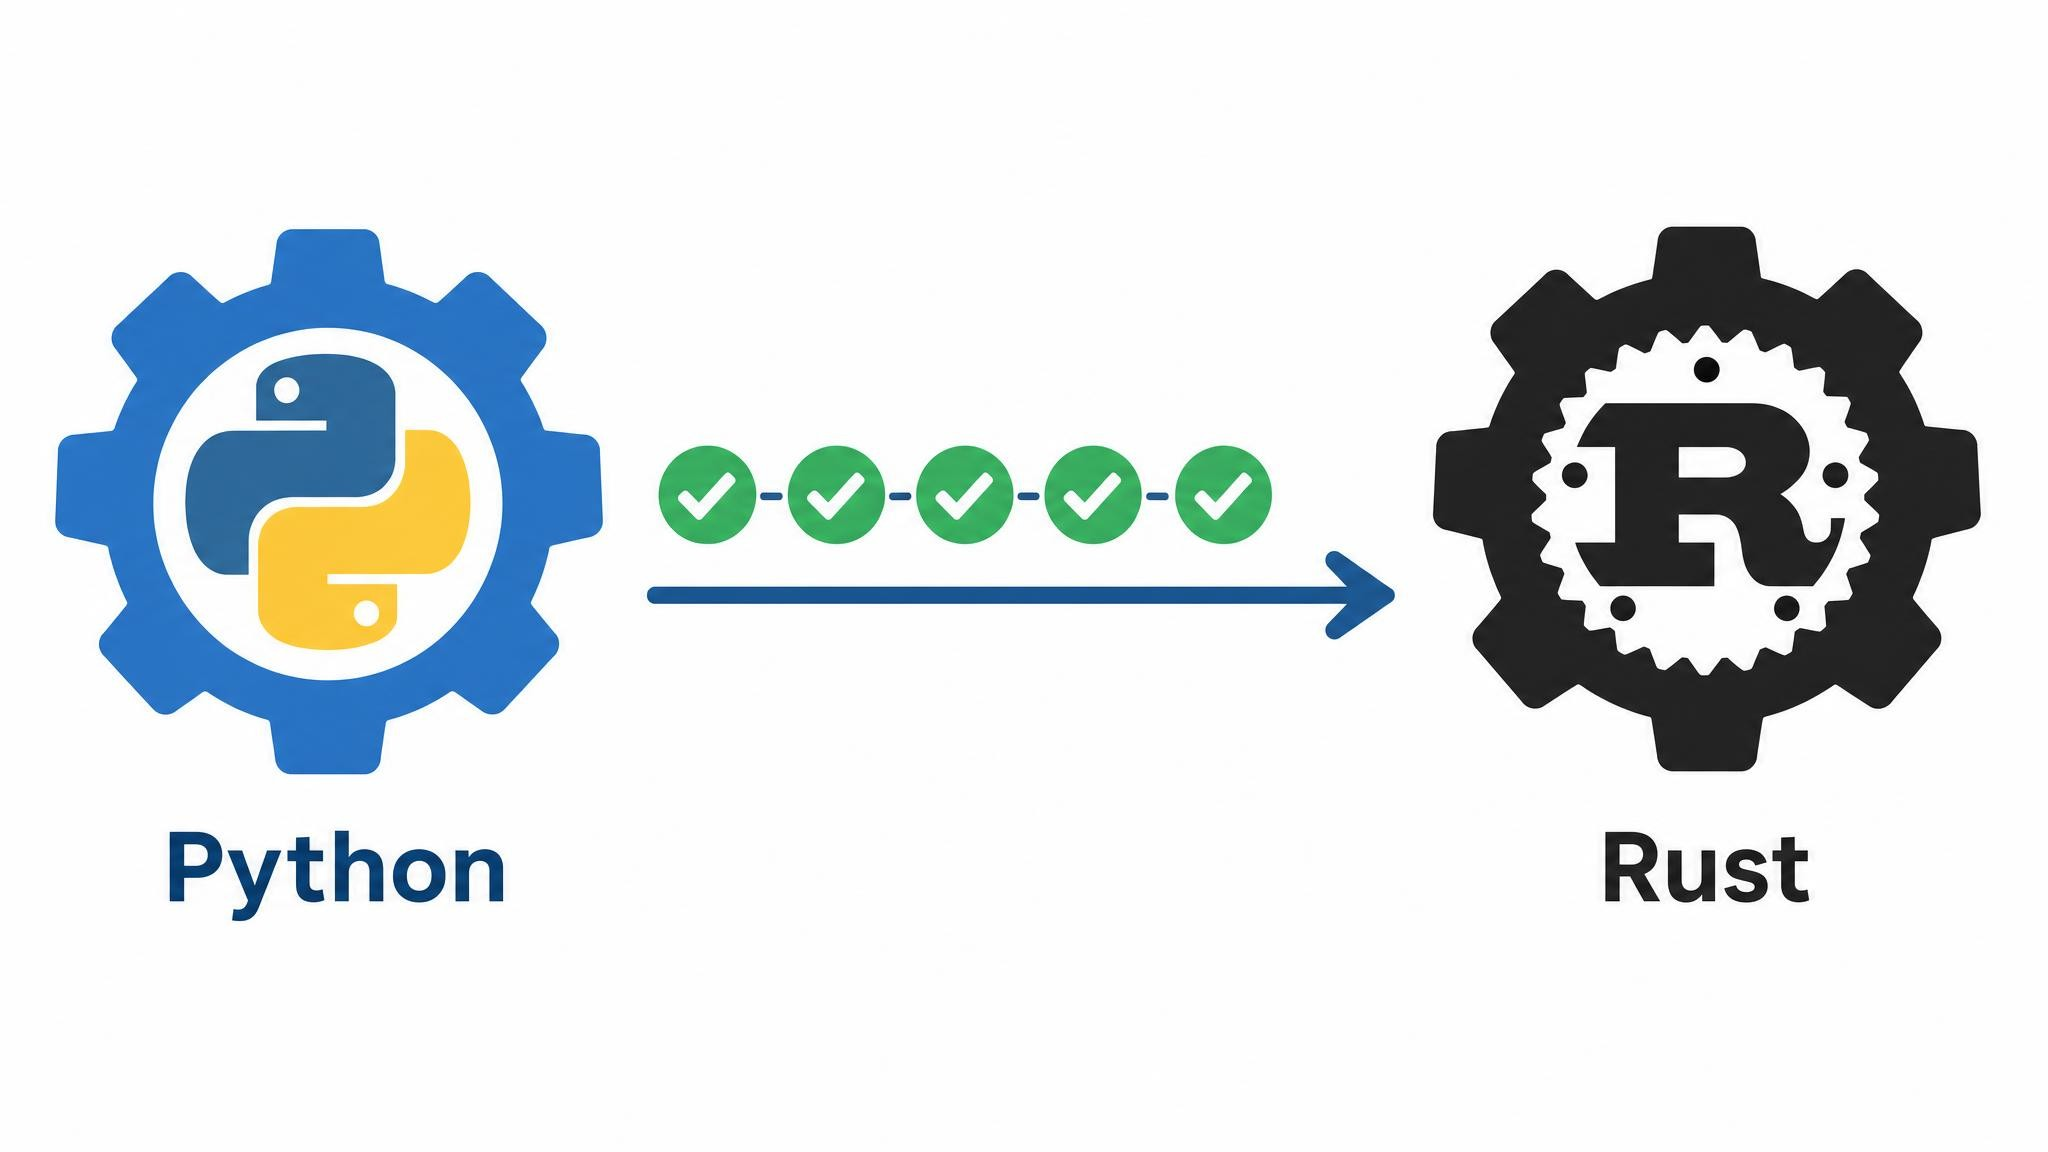
NVIDIAは2026年9月16日、GPU向けカーネルライブラリ「TileGym」のCUDAタイルカーネルを、AIエージェントを使ってPythonからRustへ自動変換する取り組みを公式ブログで公開しました。本稿では、この変換パイプラインの仕組みと性能検証の結果について解説します。
参考記事
- タイトル: Translating CUDA Tile Operations from Python to Rust Using Agentic AI
- 著者: Yinuo Liu、Melih Elibol、Dheemanth Manur
- 発行元: NVIDIA Developer Blog
- 発行日: 2026年9月16日
- URL: https://developer.nvidia.com/blog/translating-cuda-tile-operations-from-python-to-rust-using-agentic-ai/
関連記事
要点
- NVIDIAは、cuTile PythonとTriton-TileIRで書かれたGPUカーネルをcuTile Rustへ自動変換するAIエージェントスキルをTileGymリポジトリで公開した。
- このスキルを用いて、TileGymが持つ公開演算子24個すべてをRustへ移植し、平均でcuTile Python比99.5%の性能を達成した。
- 変換は解析・カーネル生成・ホスト/FFI実装・性能検証という複数のサブエージェントによる段階的なパイプラインで進み、各段階の結果は機械的に検証される。
- NVIDIA DGX B200上のベンチマークでは、24演算子すべてがcuTile Python比0.95以上の幾何平均速度比をクリアした。
- スキル一式はGitHubのTileGymリポジトリで公開されており、CUDA 13.1以上・Rust 1.89以上などの環境があれば利用できる。
詳細解説
cuTile RustとTileGymの関係
NVIDIAによれば、cuTile Rustはタイルベースの安全なGPUカーネルをRustで書くための仕組みで、Rustの所有権モデル(メモリの読み書き権限をコンパイラが静的に管理する仕組み)をGPUカーネルにまで拡張しています。可変な出力を重ならない断片に分割しつつ、カーネル呼び出しをまたいだホスト側の所有権契約を保つ設計です。
TileGymはCUDA Tile Python(cuTile Python)とTriton-TileIR(nvtriton)という2つの記法で書かれた本番カーネル群を蓄積してきたライブラリで、cuTile Python・Triton-TileIR・cuTile Rustの3つの記法はいずれも同じ中間表現「CUDA Tile IR」を経由して同じコンパイラ(tileiras)に渡り、同じGPUバイナリを生成します。共通のIRを介しているため、変換結果が元のカーネルと構造的に一致しているかを直接比較・検証できる点が、この取り組みの土台になっていると考えられます。
暗黙の仕様を明示化する変換の難所
NVIDIAの技術文書によれば、cuTile PythonとcuTile Rustの最大の違いは「特殊化(specialization、型やサイズなどを確定させる処理)」のタイミングです。cuTile PythonはJIT(実行時コンパイル)により呼び出し時点の情報から暗黙に特殊化するのに対し、cuTile RustはAOT(事前コンパイル)方式で、カーネルのシグネチャに明示的に宣言された内容のみが特殊化されます。主な違いは次の3点です。
- 条件分岐: Pythonでは未使用の分岐がコンパイル前に除去されるが、Rustでは両方の分岐が型チェックを通る必要があり、1つのPythonカーネルが複数のRust実装に分かれることがある
- データ型: Pythonでは任意の型の組み合わせがオンデマンドでコンパイルされるが、RustではFFI(言語間の呼び出し境界)が固定のシンボル/型テーブルを介してディスパッチするため、型の対応表を明示的に拡張する必要がある
- 入力検証: PythonではJITの型システムがそのまま入力検証を兼ねるが、RustではC ABI(C言語の呼び出し規約)を越えた先に安全網がないため、誤ったストライド(配列の要素間隔)は例外ではなく静かなメモリ破壊につながる。このためPythonラッパーでの意味検証とFFI層でのABIチェックという2重の防御層を設けている
この整理は、動的言語の柔軟性を静的型付け言語に移す際に一般的に直面する課題を、GPUカーネルという具体的な領域に当てはめたものだと受け止めています。
Softmaxカーネルの変換例(Python→Rust)
NVIDIAは、行ごとのSoftmax計算を行うカーネルを例に、cuTile PythonとcuTile Rustの対応関係を示しています。まずcuTile Python版です。
@ct.kernel
def softmax_kernel(output, input, TILE_SIZE: Constant[int]):
    row_idx = ct.bid(0)                     # 1つのCTA(スレッドブロック)が1行を担当
    row = ct.load(input, index=(row_idx, 0), shape=(1, TILE_SIZE),
                  padding_mode=ct.PaddingMode.NEG_INF)
    row = ct.astype(row, ct.float32)
    row_max = ct.max(row, axis=1, keepdims=True)
    numerator = ct.exp(row - row_max)
    denominator = ct.sum(numerator, axis=1, keepdims=True)
    out = numerator / denominator
    out = ct.astype(out, input.dtype)
    ct.store(output, index=(row_idx, 0), tile=out)
同じ処理をcuTile Rustで書くと、次のようになります。
#[cutile::module]
pub mod softmax_module {
    use cutile::core::*;

    #[cutile::entry()]
    pub fn softmax_kernel<E: ElementType, const TILE_SIZE: i32>(
        output: &mut Tensor<E, { [1, TILE_SIZE] }>,   // 1つのCTAが1行を担当
        input: &Tensor<E, { [-1, -1] }>,
    ) {
        let row_idx = get_tile_block_id().0;           // ct.bid(0) に相当
        // ct.load(..., padding_mode=NEG_INF) に相当する2段階の処理:
        // まず余った列を-infで埋める安全なビューを作り、次にこのCTAが担当する行を読み込む
        let token: Token = get_tensor_token(input);
        let row_view: Partition<E, { [1, TILE_SIZE] }> = make_partition_view(
            input, const_shape![1, TILE_SIZE], padding::NegInf, dim_map::Identity, token);
        let row: Tile<E, { [1, TILE_SIZE] }> = row_view.load([row_idx, 0i32]);
        let row: Tile<f32, { [1, TILE_SIZE] }> = convert_tile(row);   // ct.astype(f32) に相当
        let row_max: Tile<f32, { [1] }> = reduce_max(row, 1i32);
        let shifted = row - row_max.reshape(const_shape![1, 1])
                                   .broadcast(const_shape![1, TILE_SIZE]);
        let numerator: Tile<f32, { [1, TILE_SIZE] }> = exp(shifted);
        let denominator: Tile<f32, { [1] }> = reduce_sum(numerator, 1i32);
        let out = numerator / denominator.reshape(const_shape![1, 1])
                                         .broadcast(const_shape![1, TILE_SIZE]);
        let out: Tile<E, { [1, TILE_SIZE] }> = convert_tile(out);     // ct.astype(dtype) に相当
        output.store(out);                                            // ct.store に相当
    }
}
両者を見比べると、対応関係がそのまま読み取れます。
Constant[int]型の引数はRustのconstジェネリクスになり、呼び出しごとの形状に応じてホスト側が同じTile IRのJITを通じて具体化するpadding_mode=NEG_INFを伴うct.loadは、Rustでは「パーティションビューの作成」と「そのビューからの読み込み」という2つの明示的な手順に分かれるct.bid(0)はget_tile_block_id()に対応する- Pythonでは暗黙だった型が、Rustではすべて明示的な型(
Tile<f32, {[1, TILE_SIZE]}>など)になり、keepdims=Trueを伴う集約処理は「reduce → reshape → broadcast」という明示的な手順に展開される
変換後は、参照実装と生成コードそれぞれのTile IRを比較する「IR diff」によって、両者が同じ命令列(読み込み・最大値/合計の集約・書き込みなど)を生成しているかを直接確認できます。テストを実行する前に構造面での正しさを確かめられる点は、機能テストだけでは見逃しやすい「テストは通るが性能や意味が誤っている変換」を防ぐ仕組みとして有効だと考えられます。
C ABIを介したPython連携
Rustで書かれたカーネル自体は、Rustアプリケーションからcutileクレート(Rustのパッケージ)経由で直接呼び出せる完成品です。一方でTileGymのPythonテスト基盤やその他の非Rustホストから呼び出すために、C ABI層が用意されています。各演算子は1つのC関数として公開されます。
#[unsafe(no_mangle)]
pub unsafe extern "C" fn cutile_softmax(
    out: *const TensorDesc, inp: *const TensorDesc,
    n_rows: i32, tile_size: i32, device_id: i32, raw_stream: u64,
) -> i32 {
    let out_d = unsafe { &*out };
    let inp_d = unsafe { &*inp };
    let device = Device::new(device_id as usize).expect("device");
    let stream = unsafe { Stream::borrow_raw(raw_stream as *mut c_void, &device) };
    let mut y = unsafe { borrow_f32(out_d, device_id as usize) };
    let x = unsafe { borrow_f32(inp_d, device_id as usize) };
    let y_part = (&mut *y).partition([1, tile_size as usize]);
    match softmax_kernel(y_part, &*x).sync_on(&stream) {
        Ok(_) => 0,
        Err(_) => -1,
    }
}
Python側では、cffi(PythonからC関数を呼び出すためのライブラリ)を使ってこのシンボルをバインドします。
_FFI_CDEF = """int32_t cutile_softmax(
    const TensorDesc* out, const TensorDesc* inp,
    int32_t n_rows, int32_t tile_size,
    int32_t device_id, uint64_t raw_stream);"""

def softmax(x):
    x = x.contiguous(); m, n = x.shape
    y = torch.empty_like(x)
    rc = lib.cutile_softmax(_desc(y), _desc(x), m, next_pow2(n),
                             x.device.index or 0,
                             torch.cuda.current_stream().cuda_stream)
    assert rc == 0
return y NVIDIAによれば、この呼び出し経路ではテンソルのコピーや確保、所有権の移動を一切行わず、PyTorchが確保したメモリをRust側が借用するだけの構造になっています。また、Rustのソースを編集すると次回呼び出し時に共有ライブラリが自動的に再ビルドされる遅延コンパイル方式のため、開発中は明示的なcargo buildを挟まずにカーネルの修正とテストを繰り返せます。
エージェントスキルの内部構造
NVIDIAによれば、この変換を担う「tilegym-converting-python-to-rust」スキルは、GitHubのTileGymリポジトリで公開されており、最上位のエージェントは実装作業を一切行わず、ルーティング(振り分け)だけを担う設計になっています。実際の作業は、それぞれ専門化されたサブエージェントが担当します。
- アナライザー: 参照カーネルのTile IRを解析し、定数・データ型・許容誤差・起動グリッドなどをまとめた仕様ファイル(analysis.json)を出力する。cuTile PythonとTriton-TileIRの両方の実装がある場合は、性能を比較して基準となる方を選ぶ
- カーネルライター: Rustのカーネルファイルのみを生成する。ホスト側のコードには一切関与しない。生成したコードは、Rust単体で動くテストによる機能面の検証と、参照実装とのIR diffによる構造面の検証を両方通過する必要がある
- ホスト/FFIビルダー: C ABI層とPythonラッパーを実装し、TileGymの実テストスイートを全データ型・全形状で実行する。すべて合格して初めてベンチマーク段階に進める
- 性能バリデーター: CUPTI(NVIDIAのGPUプロファイリングツール)を使ったベンチマークを実行し、参照実装に対する幾何平均の速度比が5%以内に収まっているかを確認する
- IR diffアナリスト: 正しさのテストが失敗した場合や性能に問題がある場合にのみ呼び出され、参照IRと生成されたIRの差分を分類し、変換ミスかコンパイラ側の問題かを切り分ける
- 残存性能調査官: 正しく動くが一部の入力形状で遅いカーネルについて、デバイス側(メモリ操作の種類やコード生成)とホスト側(起動設定や自動チューニング)の両面から原因を調べ、修正点をカーネルライターに引き継ぐ
役割をここまで細かく分割している理由についてNVIDIAは、1回の変換が数百万トークン規模になること、そしてカーネル単体を先に検証してからホスト側のコードを足すことで、後工程で不具合が出た際の原因箇所を特定しやすくなることの2点を挙げています。
オーケストレーターのループ(6ステップ)
NVIDIAによれば、1回の変換作業は次の6段階からなる状態機械として進みます。
- プリフライト: 環境変数とツールチェーンのパスを検証するスクリプトを実行する。ここで失敗した場合は環境自体が使えない状態であり、以降のエージェント作業では解決できないため即座に停止する
- 最小限の情報でサブエージェントを起動: 各サブエージェントには、自分の担当段階に必要な指示ファイルと、前段階までの成果物のパスのみを渡す。指示内容をプロンプトに直接貼り付けることはしない
- 機械的な検証: すべてのサブエージェントは、検証結果を示す決まった形式のブロックと判定行を出力で返す。オーケストレーターはこの判定だけを見てルーティングし、文章の内容から自分で修正方法を推測することはない
- 判定テーブルに沿ったルーティング: 判定結果に応じて、次の段階に進むか、担当の分かる形で前段階に差し戻すか、環境の問題として停止するかを機械的に決める
- 試行回数の上限: 解析1回、カーネルライター2回、ホスト/FFIビルダー2回、診断1回、ベンチマーク2回、任意の性能調査1回というように、各段階の試行回数に上限を設けている
- 最終集約チェック: ルーティングが完了した段階で、報告書・IRダンプ・正しさと性能のログなど、成果物一式が仕様を満たしているかをまとめて再確認する
サブエージェント同士は会話ではなく決まった形式の成果物だけを通じてやり取りし、各段階の判定は機械的な検証スクリプトの結果に基づきます。この設計により、24件の変換を無人で走らせても再現性のある結果が得られると説明されています。
ベンチマーク結果
NVIDIAによれば、このスキルを使うことでカーネル変換にかかるトークン消費量は平均でおよそ半分に抑えられ、変換したすべての演算子が数値的な正しさを検証された上で、cuTile Python比0.95以上の幾何平均速度比を達成しています。最終的な性能数値は、NVIDIA DGX B200(1バックエンドにつきGPU1基を専有)上で、24演算子にまたがる347通りの入力設定について、CUPTIによるデバイス時間を4回のCI実行から最良値を採用して算出しています。
全体の幾何平均は0.995で、cuTile Python版とほぼ同等の性能でした。24演算子すべてが0.95のしきい値をクリアし、約3分の1の演算子は参照実装を上回る結果になったとされ、特に要素ごとの演算や正規化系のカーネルで性能向上が大きかったとのことです。
この結果は、3つの記法がすべて同じTile IRを経由して同じコンパイラに渡るという構成に強く依存していると考えられます。参照実装に忠実な変換であれば、同じ最適化パイプラインを通る以上、性能もおおむね引き継がれるという理屈は妥当だと受け止めています。
始め方
NVIDIAによれば、このスキル一式はTileGymリポジトリのskills/tilegym-converting-cutile-triton-to-cutile-rs/にあり、段階ごとの指示ファイル・コーディングルール集・概念解説・検証スクリプト・Softmaxとバッチ行列積(bmm)の実装例が含まれています。変換済みのカーネル自体はsrc/tilegym/ops/cutile_rs/から参照できます。
利用にあたっての要件は次のとおりです。
- CUDA 13.1以上
- 性能検証にはBlackwell世代のGPUが必要
- Rust 1.89以上
- tileirasコンパイラ
NVIDIAは、任意のエージェントにリポジトリを指定した上で「〈演算子名〉のcutile-rsバックエンドを追加して」と依頼するだけで、解析からカーネル生成、FFI実装、正しさの検証、ベンチマークまでの一連の流れが自動で進むと説明しています。
まとめ
NVIDIAは、CUDAタイルカーネルをPythonからRustへ自動変換するAIエージェントスキルを公開し、TileGymの演算子24個をすべて移植して平均99.5%の性能を維持したと報告しました。段階ごとに機械的な検証を挟む設計は、AIエージェントによるコード変換の信頼性を高める実践例です。NVIDIAのAIスキル評価の枠組みもあわせてご覧ください。