はじめに
NVIDIAが 2026年8月19日 、AIエージェント用スキルの効果を測るオープンソースツール「SkillEvaluator」の評価方法と初期結果を公開しました。本稿では、3段階の検証、スキルあり・なしの実測値、導入手順、結果を読む際の制約を解説します。
参考記事
メイン記事:
- タイトル: Evaluating AI Agent Skill Performance with NVIDIA SkillEvaluator
- 著者: Moshe Abramovitch、Christopher Kevin、Narendran Raghavan、Jean-Francois Puget、Nikhil Swaminathan
- 発行元: NVIDIA Technical Blog
- 発行日: 2026-08-19
- URL: https://developer.nvidia.com/blog/evaluating-ai-agent-skill-performance-with-nvidia-skillevaluator/
関連情報:
- タイトル: NVIDIA/SkillEvaluator
- 著者: NVIDIA
- 発行元: GitHub
- 発行日: 記載なし
- URL: https://github.com/NVIDIA/skillevaluator
- タイトル: benchmarks.json at commit 738d79e
- 著者: NVIDIA
- 発行元: GitHub
- 発行日: 2026年08月12日時点の評価スナップショット
- URL: https://github.com/NVIDIA/skills/blob/738d79edf4336404e1922b7321e959bdb81b6910/benchmarks.json
関連記事

要点
- SkillEvaluatorは構造・安全性、重複、ライブ実行の3段階でAIエージェント用スキルを評価するオープンソースツールである
- 300超のスキルと30超のNVIDIA製品をCodexとClaude Codeで評価し、スキルあり・なしの点数差をSkill Liftとして算出した
- 正確性は46から87、有効性は39から78へ上がり、Skill Liftはそれぞれ+41、+39ポイントである
- 85%のスキルは1回試行、15%は2回試行で、信頼区間は報告されていない
- トークンと実行時間は改善する例と悪化する例があり、スキル導入だけで効率化が保証されるわけではない
詳細解説
SkillEvaluatorが測るもの
エージェント用スキルは、製品の機能、使う場面、ツールの呼び出し方、例、補助ファイルをまとめた指示パッケージです。適切なスキルがあれば探索の遠回りを減らせますが、説明が重複していたり、関係のない場面で読み込まれたりすると、かえってトークンと手順を増やす可能性があります。SkillEvaluatorは、スキルの形式だけでなく、実際のタスク達成へ寄与したかを比較実験で測ります。
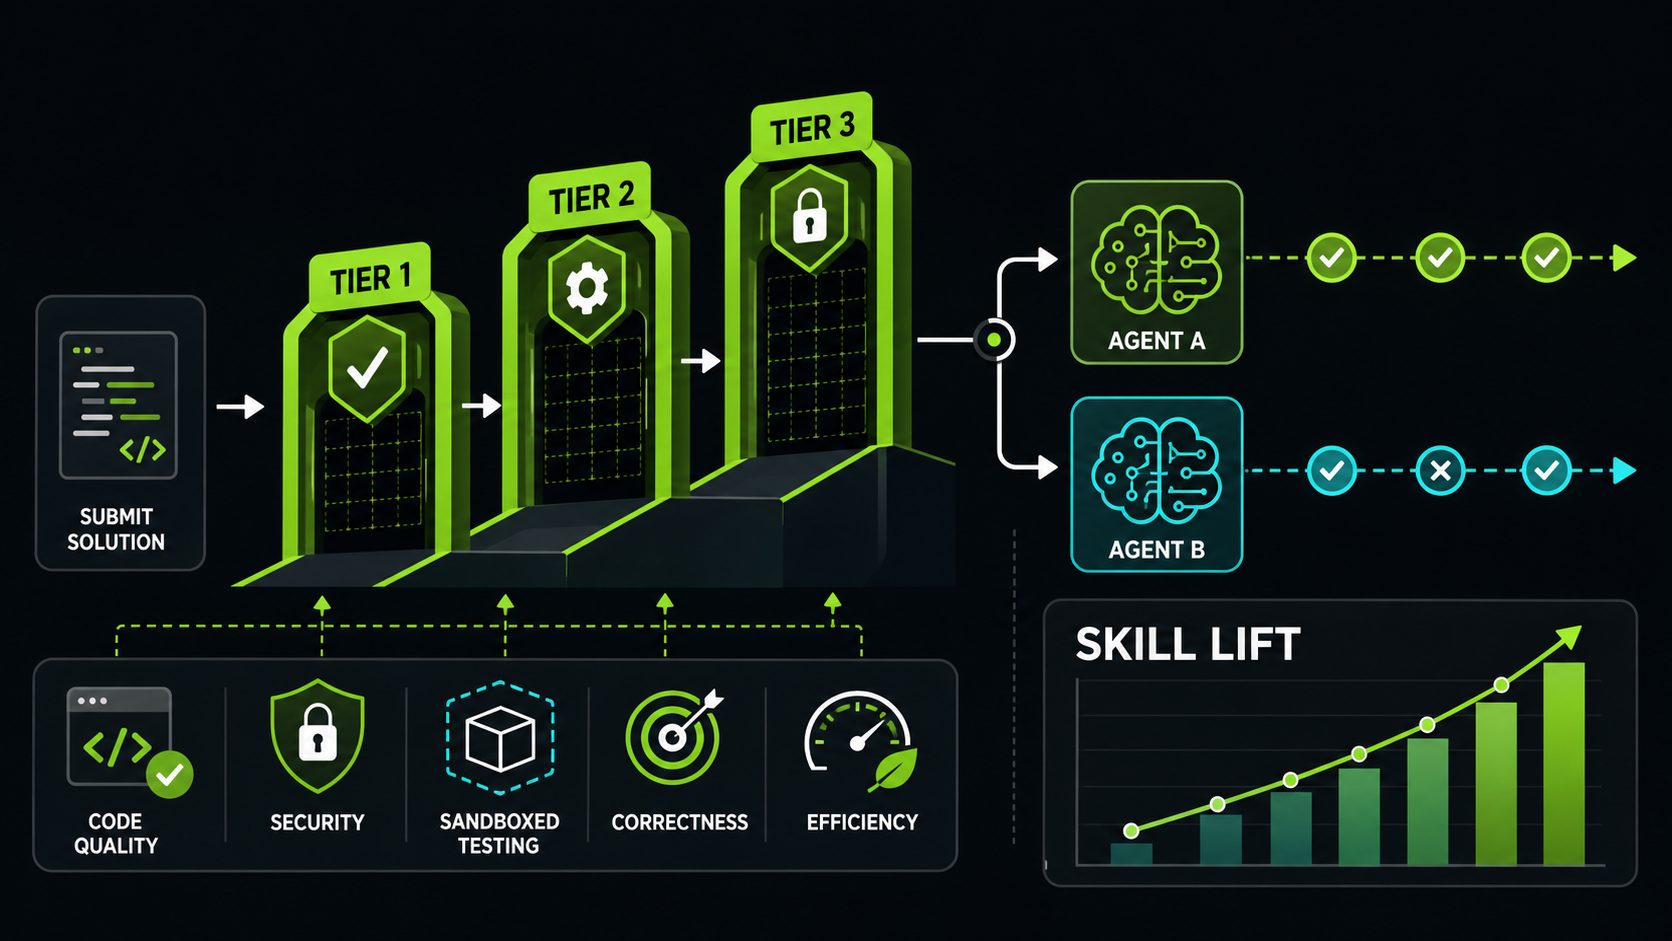
NVIDIAは300超の検証済みスキルと30超の製品について、CodexとClaude Codeという独立した二つのエージェントハーネスで評価しました。ハーネスは、モデルへ文脈を渡し、道具を呼び、結果を採点可能な形で返す実行基盤です。各ハーネスでスキルあり・なしのスコア差をSkill Liftと定義しています。
Tier 1からTier 3までの役割
Tier 1は「安全で形式が正しいか」を静的に確認します。スキーマとfrontmatter、品質、プロンプトインジェクション、データ流出、秘密情報、個人情報、ライセンス、Unicodeを使った隠蔽、スクリプトのlintなどが対象です。LLMを動かす前に、機械的に検出できる問題を落とす品質ゲートと言えます。
Tier 2は埋め込み表現を使い、単一スキル内の重複と、カタログ内の他スキルとの役割重複を調べます。指示が長いだけで同じ内容を繰り返していないか、別スキルと境界が曖昧になっていないかを確認する段階です。
Tier 3はHarborというオープンソース評価基盤を使い、隔離環境でライブ実行します。同じプロンプト、モデル、入力、採点基準を使い、唯一の実験変数をスキルの有無にします。各ケースを二つのハーネスで実行するため、特定のエージェントだけに合う指示か、対象製品の作業一般に効く指示かを見分けやすくなります。
前提条件・インストール
公式READMEの簡易手順では、uv(Python環境とパッケージを管理するツール)を使い、Python 3.13を指定して全評価機能を導入します。以下では、公式コマンドへ日本語コメントを補っています。
#Python 3.13環境へSkillEvaluatorと全評価用依存関係を導入します

uv tool install --python 3.13 "skillevaluator[all] @ git+https://github.com/NVIDIA/SkillEvaluator.git"

 次の静的検証は、指定された範囲であればAPIキー、Docker、リポジトリのcloneを必要としません。

#スキルの形式、個人情報、ライセンス、品質、Unicode、スクリプトを検査します

skillevaluator validate ./my-skill \

  --checks schema,pii,license,quality,unicode,lint \

  --no-dedup
./my-skillはSKILL.mdを含むフォルダです。完全なTier 1セキュリティスキャンではSemgrep、SkillSpector、Gitleaksなども必要です。Tier 2には埋め込みモデル、Tier 3には評価用モデル、対象エージェントの認証情報、Docker・ローカルOS・クラウドのいずれかの隔離環境が必要です。ホスト型モデルや管理サンドボックスは料金が発生する場合があります。
注意: validate –fullはTier 1からTier 3をまとめて実行しますが、Tier 2とTier 3にはモデル呼び出しや隔離環境が必要です。最初から全件を実行せず、静的検証、少数ケースのライブ比較、評価セットの修正という順で進めると、費用と失敗原因を分けて確認できます。
評価データセットとライブ比較
まず、明示的な依頼、暗黙的な依頼、文脈依存の依頼、スキルを使うべきでない依頼を含む評価セットを作ります。
#4種類のケースを含む評価データセットを生成します

skillevaluator create-eval-dataset ./my-skill --full
生成物はevals/evals.jsonで、各ケースにID、プロンプト、期待出力、任意のアサーションが入ります。自動生成後に、人間が対象業務と対象外業務を正しく表しているかレビューすることが重要です。評価セットが曖昧なら、点数が高くても実務上の改善を示せません。
確認後、CodexとDockerを使ってTier 3を実行します。
#同一条件でスキルあり・なしを実行し、差分を計測します

skillevaluator tier3 evaluate ./my-skill \

  --agents codex \

  --env-mode docker
SkillEvaluatorがケースをHarbor用タスクへ変換し、隔離された環境で両条件を実行して採点します。未確認コードを本番スキルや機密ワークスペースへ直接適用せず、信頼できないスキルはDockerまたはクラウド隔離環境で評価する必要があります。
数値で見るSkill Lift
NVIDIAの2026年8月12日スナップショットでは、スキルなしの平均点は正確性46、発見可能性42、有効性39、効率43、セキュリティ97でした。スキルありでは87、82、78、78、98となり、Skill Liftは順に+41、+40、+39、+35、+1ポイントです。全次元平均は+31、セキュリティを除く平均は+39でした。
正確性と有効性は両条件で同じ性質を測るため、スキルの効果を比較しやすい指標です。一方、発見可能性と効率には、スキルが適切に読み込まれ、無駄なく使われたかというスキル固有の採点が含まれます。数値を「スキルなしのエージェントが42%の確率で発見した」と読むのは適切ではありません。
ハーネス別ではClaude Codeが全次元+34、セキュリティ除外+42、Codexが+29と+36でした。差は平均約5ポイントですが、製品別のSkill Liftは約+2〜+46まで広がりました。NVIDIAは、ハーネスの種類より、対象製品、課題、評価セットの設計が結果を大きく左右したと分析しています。
制約と効率の読み方
公開結果の85%は1タスク1回、15%は2回の試行で、信頼区間は示されていません。エージェント実行にはばらつきがあるため、個別スキルの小さな差を確定的な優劣として扱わず、重要タスクでは試行回数を増やし、失敗内容も確認する必要があります。
効率も自動的には改善しません。NVIDIAによれば、jetson-optimize-memoryはトークンを617,306から142,540へ76.9%減らし、時間を474.9秒から220.0秒へ53.7%短縮しました。一方、cuopt-installはトークンが25,227から55,582へ120.3%増え、時間も34.0秒から41.1秒へ20.8%増えました。評価では最終点だけでなく、トークン、時間、冗長な道具呼び出しを別々に見ることが重要です。
SkillEvaluator自体は実験的で、コミュニティによるベストエフォートの支援です。SLAやNVIDIAの企業サポート権利はありません。まず小さな評価セットと一つのハーネスから始め、改善点をスキル本文と評価セットへ戻す反復運用が現実的だと考えられます。
パートナー試験も運用像を補います。OpenClawはClawHubの公式組織向けに評価結果を表示する試験を行い、Nous ResearchはHermes Agentの導入フローでSkillSpectorによる助言的スキャンを試しました。後者は29件のテストに合格し、1スキルあたり約1.4〜1.5秒でした。ただし、これは限定されたスキャン時間であり、Tier 3のモデル実行時間とは分けて読む必要があります。
まとめ
SkillEvaluatorは、スキルを形式、安全性、重複、実タスクへの寄与で評価する枠組みです。平均点は改善しましたが、試行回数、採点の意味、効率悪化の例も確認が必要です。評価セットを業務に合わせ、スキルあり・なしを同条件で反復比較することが導入の出発点になります。