はじめに
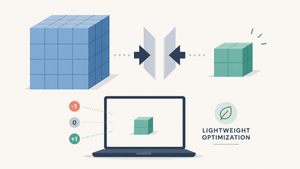
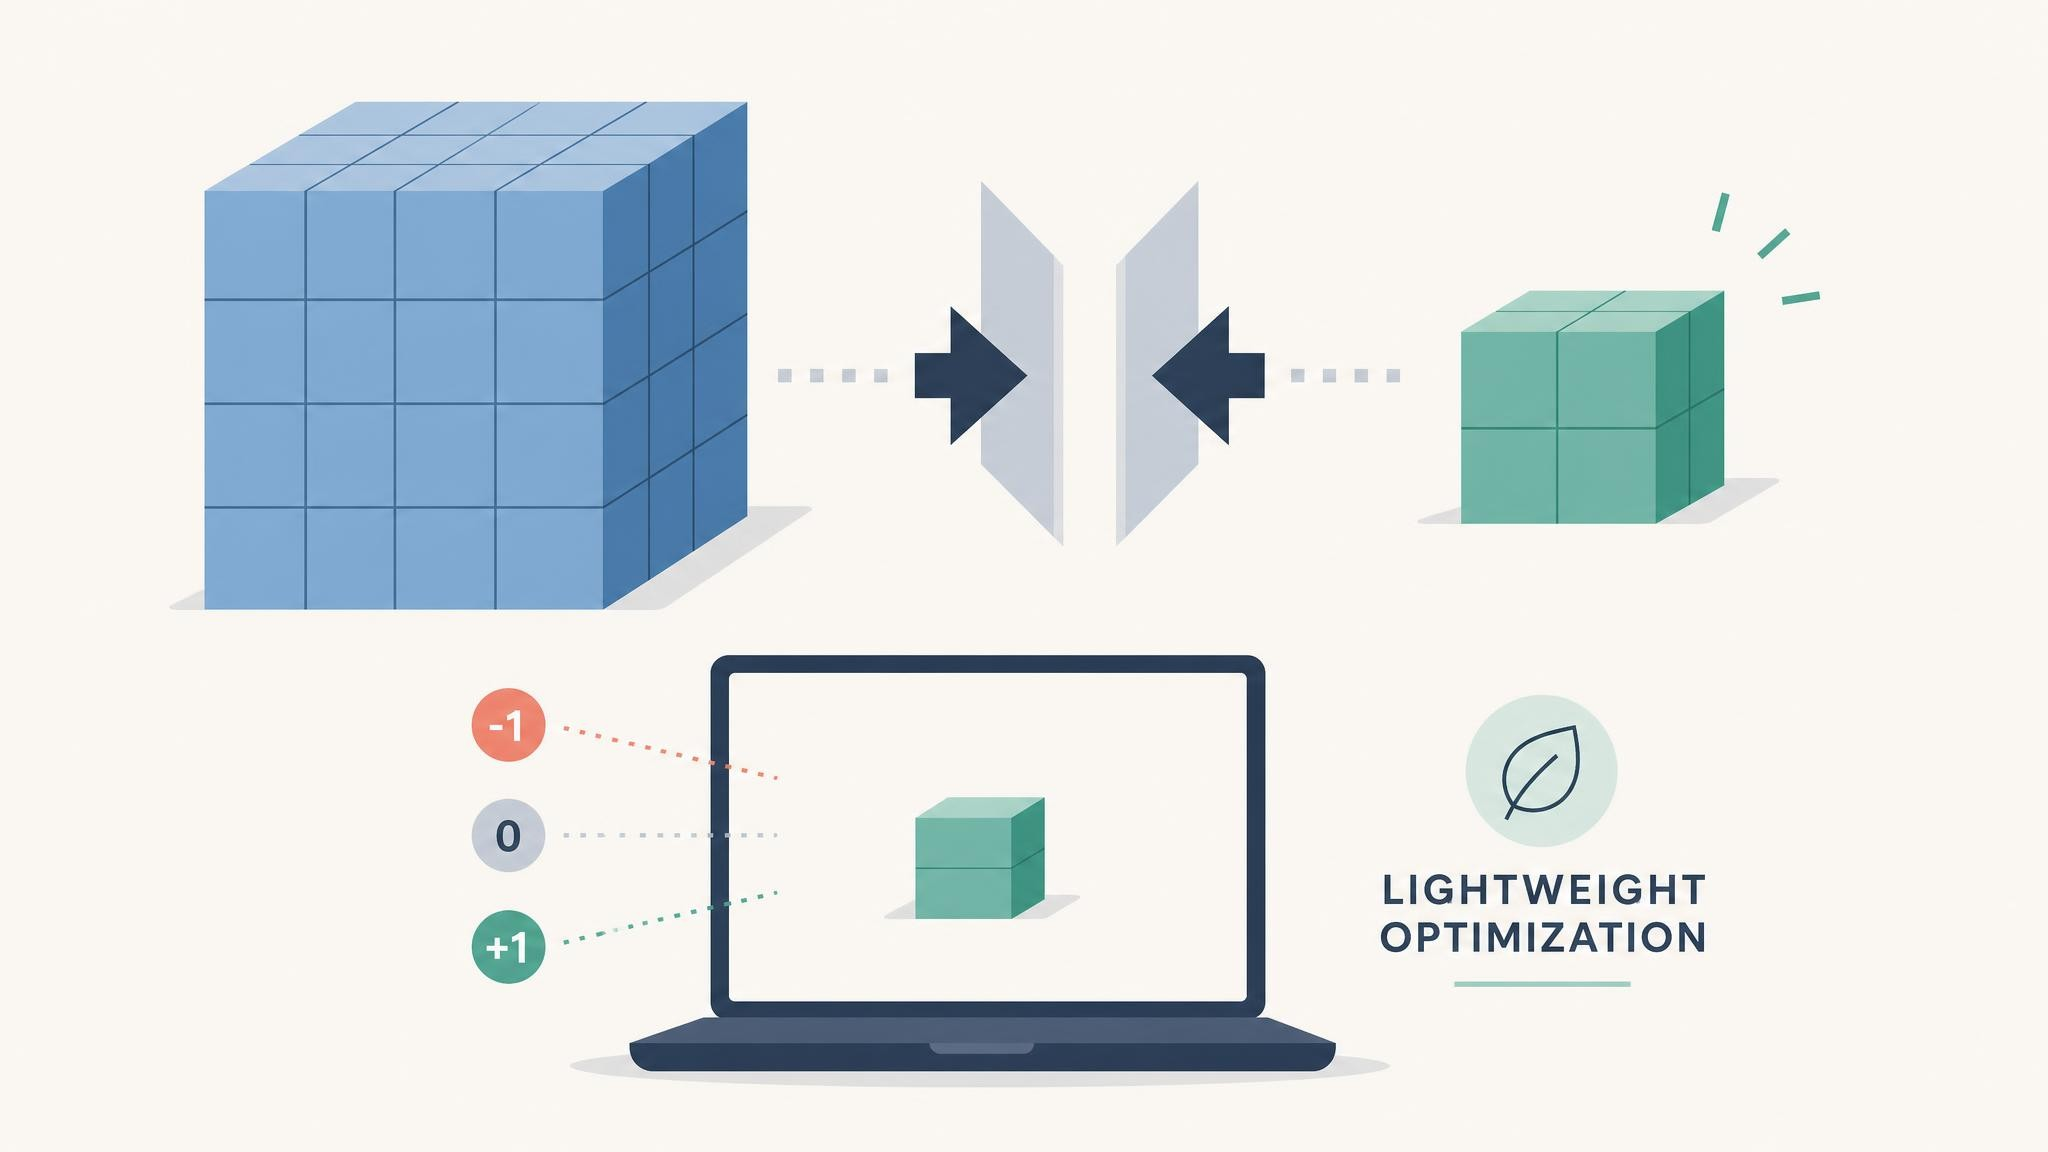
Prism MLは2026年9月、Qwen3.8-27Bの重みを3値(-1・0・+1)まで圧縮した27B級推論モデル「Bonsai 2 27B」をHugging Faceで公開しました。ノートPC1台で動く軽さながら、FP16比98.2%の性能を維持しているとされています。本稿ではこの内容をもとに、仕組みと導入手順を解説します。
参考記事
- タイトル: Bonsai 2 27B — GGUF
- 著者: Prism ML
- 発行元: Hugging Face(prism-ml)
- 発行日: 2026年9月
- URL: https://huggingface.co/prism-ml/Ternary-Bonsai-2-27B-gguf
関連記事
要点
- Prism MLは、Qwen3.8-27Bの重みを3値(-1・0・+1)まで圧縮した27B級推論モデル「Bonsai 2 27B」を公開した。
- モデルサイズはFP16の約54GBから約5.9GBまで縮小され、Apple M5 Max搭載ノートPCで約47トークン/秒の生成速度を記録した。
- 14種類の思考モードベンチマーク平均でFP16比98.2%(84.78点)のスコアを維持し、従来の2bit級量子化(72.59点)を大きく上回った。
- 数学・コーディングではFP16とほぼ同水準を保つ一方、知識・推論やビジョン関連のベンチマークでは性能差が目立つとされている。
- 専用のllama.cppフォークが必要で、標準版のllama.cppではこのモデルを正しく実行できないと明記されている。
詳細解説
Bonsai 2 27Bとは——27B級モデルを1.72ビット/重みまで圧縮
Bonsai 2 27Bは、Qwen3.8-27B(ハイブリッドアテンション構成の27B級大規模言語モデル)をベースに、重みを3値表現(ternary、各重みが-1・0・+1のいずれかの値のみを取る形式)まで圧縮したモデルです。埋め込み層・アテンション投影・MLP投影・言語モデルのヘッドまで、モデル全体の重みを一貫して3値化しており、低ビット化をうたいながら一部だけ高精度のまま残す「抜け道」がない設計だとされています。ビジョン(画像入力)を扱うための追加コンポーネントは8bit形式の別ファイルとして提供され、画像入力があるときだけ読み込まれます。
同じQwen3.8シリーズのモデルについては本ブログでも実装方法を紹介しましたが、Bonsai 2 27Bはこのベースモデルのアーキテクチャ自体は変更せず、重みの表現方法だけを大幅に圧縮している点が特徴です。ライセンスはApache 2.0とされています。
三値重み表現「Ternary g128」の仕組み
各重みは-1・0・+1のいずれかの値を取り、128個の重みごとに1つのFP16スケール係数を共有する「g128」というグループ単位で量子化されています。3値は理論上log₂3(約1.585)ビットの情報量を持ち、128個ごとに共有する16bitのスケール係数を割り当てたコストを均すと、実効的な保存コストは1重みあたり約1.71ビットになるとされ、3値化されずに高精度のまま残る一部のテンソル(全体の0.0976%)を含めたモデル全体では1.72ビット/重みとなり、FP16比で理論上約9.3倍の圧縮に相当するとされています。
重みは、ブロック単位(1024個)でアダマール回転(直交行列による座標変換の一種で、量子化による誤差を分散させる手法)を適用した上で3値化されており、この回転はオフラインで重みに折り込まれているため、実行時に追加のビットや計算コストを必要としないとされています。実行環境は、この回転が適用されている前提でファイルのメタデータを読み取り、対応する変換を活性化に適用するか、対応していなければファイルの読み込み自体を拒否する仕組みになっているとされています。
パッキング形式とメモリ使用量
実際に配布されるファイルには2種類のパッキング形式があります。PTQ1_0は3値を密に詰め込む形式で1重みあたり1.75ビット(5.95GB)、PQ2_0は各3値を2ビットのスロットに格納する形式で1重みあたり2.13ビット(7.21GB)になるとされています。どちらか一方が常に優れているわけではなく、後述するようにハードウェアによって速いパッキングが異なるとされています。これらのファイルサイズはテキスト推論に必要な言語モデル部分のみを指しており、常駐させる必要のあるコンポーネントです。
比較対象として、一般的な「2bit」量子化と称される既存モデルの多くは、実際には表示されているビット数より高い平均ビット幅になっている(Qwen3.8-27Bの広く使われる「2bit」ビルドは実際には1重みあたり2.8ビット、9.4GBだと紹介されています)のに対し、Bonsai表現は名称通りのビット幅を実現している点が強調されています。
ベンチマーク結果——FP16比98.2%の性能を維持
NVIDIA H100上でEvalScopeとvLLMを用い、6つのスキルカテゴリにまたがる14種類のベンチマークを思考モードで評価した結果、Bonsai 2 27Bは平均84.78点を記録し、FP16版(86.32点)の98.2%に相当するとされています。この結果は、同じベースモデルの一般的な4bit量子化版(UD-Q4_K_XL、5.2ビット/重み、17.6GB、85.18点)にわずか0.4点差まで迫りながら、そのファイルサイズの3分の1程度で達成されているとされ、一般的な2bit量子化版(IQ2_XXS、2.8ビット/重み、9.4GB、72.59点)を12点以上、しかもより小さいファイルサイズで上回っているとされています。
スキルカテゴリ別に見ると、数学(FP16の97.06点に対し96.57点)やコーディング(89.07点に対し89.42点)、指示追従ではFP16とほぼ同水準を保っている一方、知識・推論(85.55点に対し79.86点)やビジョン(71.36点に対し66.19点)では差が目立つとされています。特筆すべき点として、一般的な2bit量子化版はAIME26(数学オリンピック形式の問題)で56.4点、LiveCodeBenchで57.5点まで急落する一方、MMLU-Reduxでは88.93点を保っており、この選択的な劣化は表面的なテストでは見落とされがちだと指摘されています。Bonsai 2 27Bはこれらの難易度の高いベンチマークでもそれぞれ95.83点、90.07点を維持しているとされ、同様の傾向は別のベースモデル(Gemma-4-31B)を使った前バージョンでも確認されており、この劣化パターンは特定のモデルというより量子化手法自体に起因する性質だとされています。
開発チームは、モデルの能力とファイルサイズの比率を示す「知能密度」という指標も提示しており、Bonsai 2 27Bは0.469(1GBあたり)で、既存の2bit量子化版(0.199)の2.3倍以上、FP16版(0.053)の9倍近くに達するとされています。
前提条件・環境構成
Bonsai 2 27Bを動かすには、対応する専用のllama.cppフォーク(PrismML-Eng/llama.cpp)が必要です。標準版のllama.cppはこのモデルのファイル形式(PQ2_0・PTQ1_0)を認識できずに読み込みを拒否するか、あるいはQ2_0として誤って読み込んでしまい、警告なしに意味のない出力を生成するとされています。これは、3値表現に必要な「アダマール変換」の実行環境が標準版に存在しないためです。以前、軽量モデルをllama.cppでローカル実行する方法も本ブログで紹介しましたが、今回のように専用フォークが必須のモデルでは、標準版との互換性を前提にせず、公式手順に厳密に従うことが重要になります。対応するバックエンドはCUDA(NVIDIA GPU)・Metal(Apple Silicon)・CPUで、Macの場合は追加設定なしでMetalが使われるとされています。
インストール・セットアップ
以下は、モデルカードに記載されたセットアップ手順をそのまま再現しています。まず、専用フォークのビルド済みバイナリをダウンロードして展開します。
# 公開されているビルド済みバイナリの中から、自分の環境(OS)に合ったものをダウンロードします
# 配布先: https://github.com/PrismML-Eng/llama.cpp/releases/latest
tar -xzf llama-<tag>-bin-<platform>.tar.gz -C bin --strip-components=1
自分でビルドする場合は、専用フォークをクローンしてビルドします。
# 専用フォークのリポジトリをクローンし、そのディレクトリに移動します
git clone https://github.com/PrismML-Eng/llama.cpp && cd llama.cpp

# ビルド設定を行い、並列ビルドを実行します
# NVIDIA GPUを使わない場合(macOSなど)は -DGGML_CUDA=ON を外してください。Macでは既定でMetalが使われます
cmake -B build -DGGML_CUDA=ON && cmake --build build -j
注意: ビルド済みバイナリを使う場合は実行ファイルのパスが./bin/llama-cli、自分でビルドした場合は./build/bin/llama-cliと異なる点に注意してください。
続いて、Hugging Face CLI(Hugging Faceが提供するモデルダウンロード用のコマンドラインツール)を使ってモデルファイルをダウンロードします。
# PQ2_0形式のモデルファイルをカレントディレクトリにダウンロードします
hf download prism-ml/Ternary-Bonsai-2-27B-gguf Ternary-Bonsai-2-27B-PQ2_0.gguf --local-dir .
実行・動作確認
ダウンロードしたモデルファイルを指定して、対話的にプロンプトを実行します。
./bin/llama-cli -m Ternary-Bonsai-2-27B-PQ2_0.gguf \
    -ngl 99 -fa on -c 32768 \
    --temp 1.0 --top-p 0.95 --top-k 20 \
    -p "Explain quantum computing in simple terms." -n 256
-ngl 99はすべてのレイヤーをGPUにオフロードする指定で、0を指定するとCPUのみで実行されます。-cはコンテキスト長の指定で、最大262144(約26万2千トークン)まで設定できます。--temp・--top-p・--top-kは生成のサンプリングパラメータです。このモデルは既定で「思考モード」(reasoning、途中の推論過程を出力してから最終的な回答を生成するモード)が有効になっているとされています。
推奨されるサンプリングパラメータは、思考モードではtemperature=1.0, top_p=0.95, top_k=20, min_p=0.0, presence_penalty=0.0, repetition_penalty=1.0、通常の指示応答モードではtemperature=0.7, top_p=0.80, top_k=20, min_p=0.0, presence_penalty=1.5, repetition_penalty=1.0とされ、これらはベースモデル自身の設定ファイルおよびGGUFファイルのメタデータに含まれているため、対応するクライアントであれば明示的な指定なしで自動的に使われるとされています。推論に割く計算量を示す「推論努力度」は既定で最も高いxhighに設定されており、応答を短くしたい場合はmediumを、lowは非対応でxhighに近い挙動になるとされています。サーバー機能・ツール呼び出し・画像入力・投機的デコードといった応用的な使い方については、公式のデモリポジトリに沿って進めることが推奨されています。
なお、筆者はこの手順を実際に動作確認したわけではなく、モデルカードに記載された内容をもとにしています。実行環境やライブラリのバージョンによっては、追加の調整が必要になる場合があると考えられます。
クロスプラットフォームの実行速度
開発チームは、複数のGPUおよびApple Silicon搭載ノートPCで、128トークン生成時の速度(TG128、メモリ帯域幅が制約になる対話的なフェーズ)と512トークンのプロンプト処理速度(PP512、演算量が制約になるフェーズ)を計測しています。RTX 5090ではPQ2_0形式で129.9トークン/秒、H100ではPQ2_0形式で113.9トークン/秒を記録した一方、Ada世代のGPUやL4ではPTQ1_0形式の方が速いという結果が示されています。PTQ1_0は転送するデータ量が17%少ない一方、3値を展開する演算コストがかかるため、メモリ帯域幅が制約になる環境ではPTQ1_0が、演算能力が制約になる環境ではPQ2_0が有利になる傾向があるとされています。
ノートPC環境では、Apple M5 Max搭載機で約47トークン/秒、M5 Pro搭載機で約28.7トークン/秒、M4 Pro搭載機で約18トークン/秒を記録したとされています。FP16版(約54GB)はそもそもノートPCのメモリには収まらないため、開発チームは、速度の比較そのものより、27B級のモデルが日常的なノートPCで対話的に動作すること自体が重要な意味を持つと説明しています。
想定される用途と限界
開発チームが挙げる主な用途には、262Kトークンの長いコンテキストを活かした長文書分析やリポジトリ全体を対象にしたコード作業を含む、ノートPC上での27B級エージェント利用、プロンプトやデータを端末外に出さないプライバシー重視・オフライン環境での利用、単一の一般向けGPUやエントリークラスのデータセンターGPUでの27B級品質のサービング、そして品質を優先した低ビット量子化での運用が挙げられています。
一方で限界として、品質とファイルサイズのトレードオフは残っており、知識・推論やビジョンといった特に負荷の高いカテゴリに性能差が集中している点、そして3値を展開する演算コストの影響で、PTQ1_0形式がAda世代や小型アクセラレータでは高速な一方、Ampere・Hopper・Blackwell世代ではまだ遅く、あらゆる環境でファイルサイズの優位性をそのまま速度の優位性に変換することは、開発チームにとって現在進行中の課題だとされています。
まとめ
Bonsai 2 27Bは、重みを3値まで圧縮しながら、専用の量子化技術によって数学やコーディングではFP16に近い性能を保つ27B級モデルです。ノートPC1台で動作する軽さと、名称通りのビット幅を実現している点が特徴と言えます。本稿としては、専用フォークが必須である点に注意しつつ、ローカル環境でのAI活用を検討する際の選択肢の一つとして参考になると考えています。