はじめに
Googleが2026年5月5日、Gemma 4ファミリー向けの Multi-Token Prediction(MTP)ドラフター を公開しました。Speculative Decoding(投機的デコーディング)の技術を採用し、出力品質を損なわずに最大3倍の推論速度向上を実現します。本稿では、その仕組みと導入方法を解説します。
参考記事
- タイトル: Accelerating Gemma 4: faster inference with multi-token prediction drafters
- 著者: Olivier Lacombe、Maarten Grootendorst
- 発行元: Google
- 発行日: 2026年5月5日
- URL: https://blog.google/innovation-and-ai/technology/developers-tools/multi-token-prediction-gemma-4/
関連記事
要点
- Gemma 4ファミリー向けのMTPドラフターが公開され、出力品質を損なわずに最大3倍の推論速度向上を実現するものである
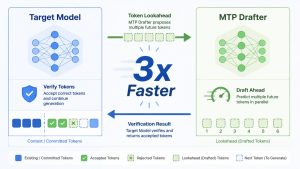
- Speculative Decodingの仕組みにより、軽量なドラフターモデルが複数トークンを先読みし、ターゲットモデルが並列で一括検証することでスループットを高める設計である
- ドラフターはターゲットモデルのKVキャッシュとアクティベーションを共有するため、文脈の再計算コストを省いて動作するものである
- Apple Siliconでは26B MoEモデルのバッチサイズを4〜8に設定すると約2.2倍の速度向上が見込まれるなど、ハードウェアごとの最適化が施されている
- Apache 2.0ライセンスで公開されており、Hugging Face・Kaggle・vLLM・Ollama・SGLangなど主要プラットフォームから即日利用可能である
詳細解説
LLM推論がメモリ帯域に縛られる理由
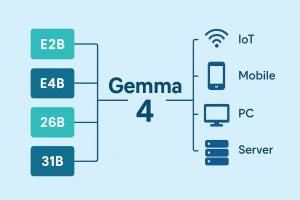
Googleによれば、標準的なLLM推論はメモリ帯域に強く制約される構造を持っています。1トークンを生成するたびに数十億のパラメータをVRAMから演算ユニットへ転送する必要があり、演算リソースの多くが遊休状態になっています。コンシューマー向けGPUやEdgeデバイス(E2B/E4B)では、この問題が特に顕著です。
また、自己回帰生成では「Actions speak louder than…」の後に「words」が続くような自明な予測も、複雑な論理推論と全く同じ計算量をかけて処理します。Speculative Decoding(投機的デコーディング)は、この非効率を解消するために設計された手法であり、Google研究者らが2022年に発表した論文 Fast Inference from Transformers via Speculative Decoding で提案された技術を基にしています。
MTPドラフターによるSpeculative Decodingの仕組み
MTPドラフターは、重いターゲットモデル(Gemma 4 31Bなど)と 軽量なドラフターモデル を組み合わせて動作します。ドラフターはターゲットモデルが1トークンを処理する時間内に、複数の次トークン候補を先読みします。その後、ターゲットモデルがこれらの候補を 並列で一括検証 します。
ターゲットモデルが先読みトークン列を承認した場合、そのシーケンス全体を一度の前向き処理で確定させ、さらに独自のトークンを1つ追加します。つまり通常は1トークン分の時間で終わる処理が、ドラフト列全体+1トークン分の出力に相当することになります。出力品質についてはターゲットモデルが最終検証を担うため、MTPドラフターの有無による精度の差はないとされています。
技術的な実装面では、ドラフターがターゲットモデルの アクティベーション と KVキャッシュ を共有する設計を採っています。これにより、ドラフターが文脈を再計算するコストを省いて高速に動作します。さらにE2B・E4Bのエッジモデルでは、最終ロジット計算のボトルネックを解消するため、エンベッダーに クラスタリング手法 を導入した効率化も施されています。
ハードウェアごとの速度向上の実態
Googleによれば、LiteRT-LM・MLX・Hugging Face Transformers・vLLMを用いた検証で最大3倍の tokens-per-second 向上が確認されています。ただし、ハードウェアによって特性が異なります。
26B MoEモデルをApple Siliconでバッチサイズ1のまま動かす場合、MoEのルーティング構造がSpeculative Decodingと相性が悪く、速度改善が限られることが確認されています。Googleは、バッチサイズを4〜8に増やすと約2.2倍の速度向上が得られると報告しており、Nvidia A100でも同様の傾向が見られるとしています。ローカルでMTPドラフターを活用する際は、バッチサイズの設定を意識することが重要だと思います。
対応ユースケースと対象デバイス
Googleはこの高速化が有効な用途として以下を挙げています。リアルタイムチャットや音声アプリでのレイテンシ削減、26B MoEや31B Denseモデルを個人PCやコンシューマーGPU上で動かすローカル開発環境の強化、E2B・E4Bによるエッジデバイスでの生成速度向上とバッテリー消費の抑制、そして複数ステップの計画立案が必要なエージェントワークフローへの応用です。
数週間前に公開されたGemma 4 は60万回以上のダウンロードを記録しており、今回のMTPドラフターはその活用範囲をさらに広げる位置づけです。
利用開始の方法
MTPドラフターはGemma 4と同じApache 2.0ライセンスの下、本日より公開されています。モデルの重みはHugging FaceおよびKaggleからダウンロードでき、対応フレームワークは以下の通りです。
- Hugging Face Transformers / MLX(Apple Silicon向け)
- vLLM / SGLang(高スループットサービング向け)
- Ollama(ローカル実行向け)
- Google AI Edge Gallery(Android・iOSアプリ)
公式ドキュメント(https://ai.google.dev/gemma/docs/mtp/overview)にセットアップ手順や各フレームワークとの連携方法が記載されています。視覚的なアーキテクチャやKVキャッシュ共有の詳細については、Googleが公開した技術的な解説も参考になります。
まとめ
今回のMTPドラフターにより、Gemma 4は出力品質を維持したまま最大3倍の推論速度向上を実現しました。ハードウェアごとにバッチサイズなどの最適化ポイントが異なるため、自身の環境に合わせた調整が必要だと思います。ローカルや On-Device でのLLM活用を検討している方にとって、選択肢がさらに広がる発表だと言えます。