はじめに
NVIDIAが2026年9月15日に公開したブログ記事では、AIモデルの主要アーキテクチャである「Dense(密)モデル」と「MoE(Mixture-of-Experts)モデル」の違いについて解説されています。本稿では、同社の発表をもとに、両者の仕組みやパフォーマンスの違い、プロジェクトにおける選択基準に加え、MoEモデルを実際に動かす際の実装手順についても解説します。
参考記事
- タイトル: Dense vs. MoE Models: Active Parameters, Throughput, and When to Choose Each
- 著者: Sophia Abbassi
- 発行元: NVIDIA
- 発行日: 2026年9月15日
- URL: https://developer.nvidia.com/blog/dense-vs-moe-models-active-parameters-throughput-and-when-to-choose-each/
要点
- Denseモデルは全パラメータを、MoEモデルは一部のパラメータのみを稼働させる。
- MoEモデルは同規模のDenseモデルより高速なトークン処理を実現する。
- 並行処理数が増加すると、MoEの速度面の優位性は縮小する傾向がある。
- 選択時はメモリ予算、並行処理要件、チューニング計画を考慮する必要がある。
詳細解説
アーキテクチャの違いと仕組み
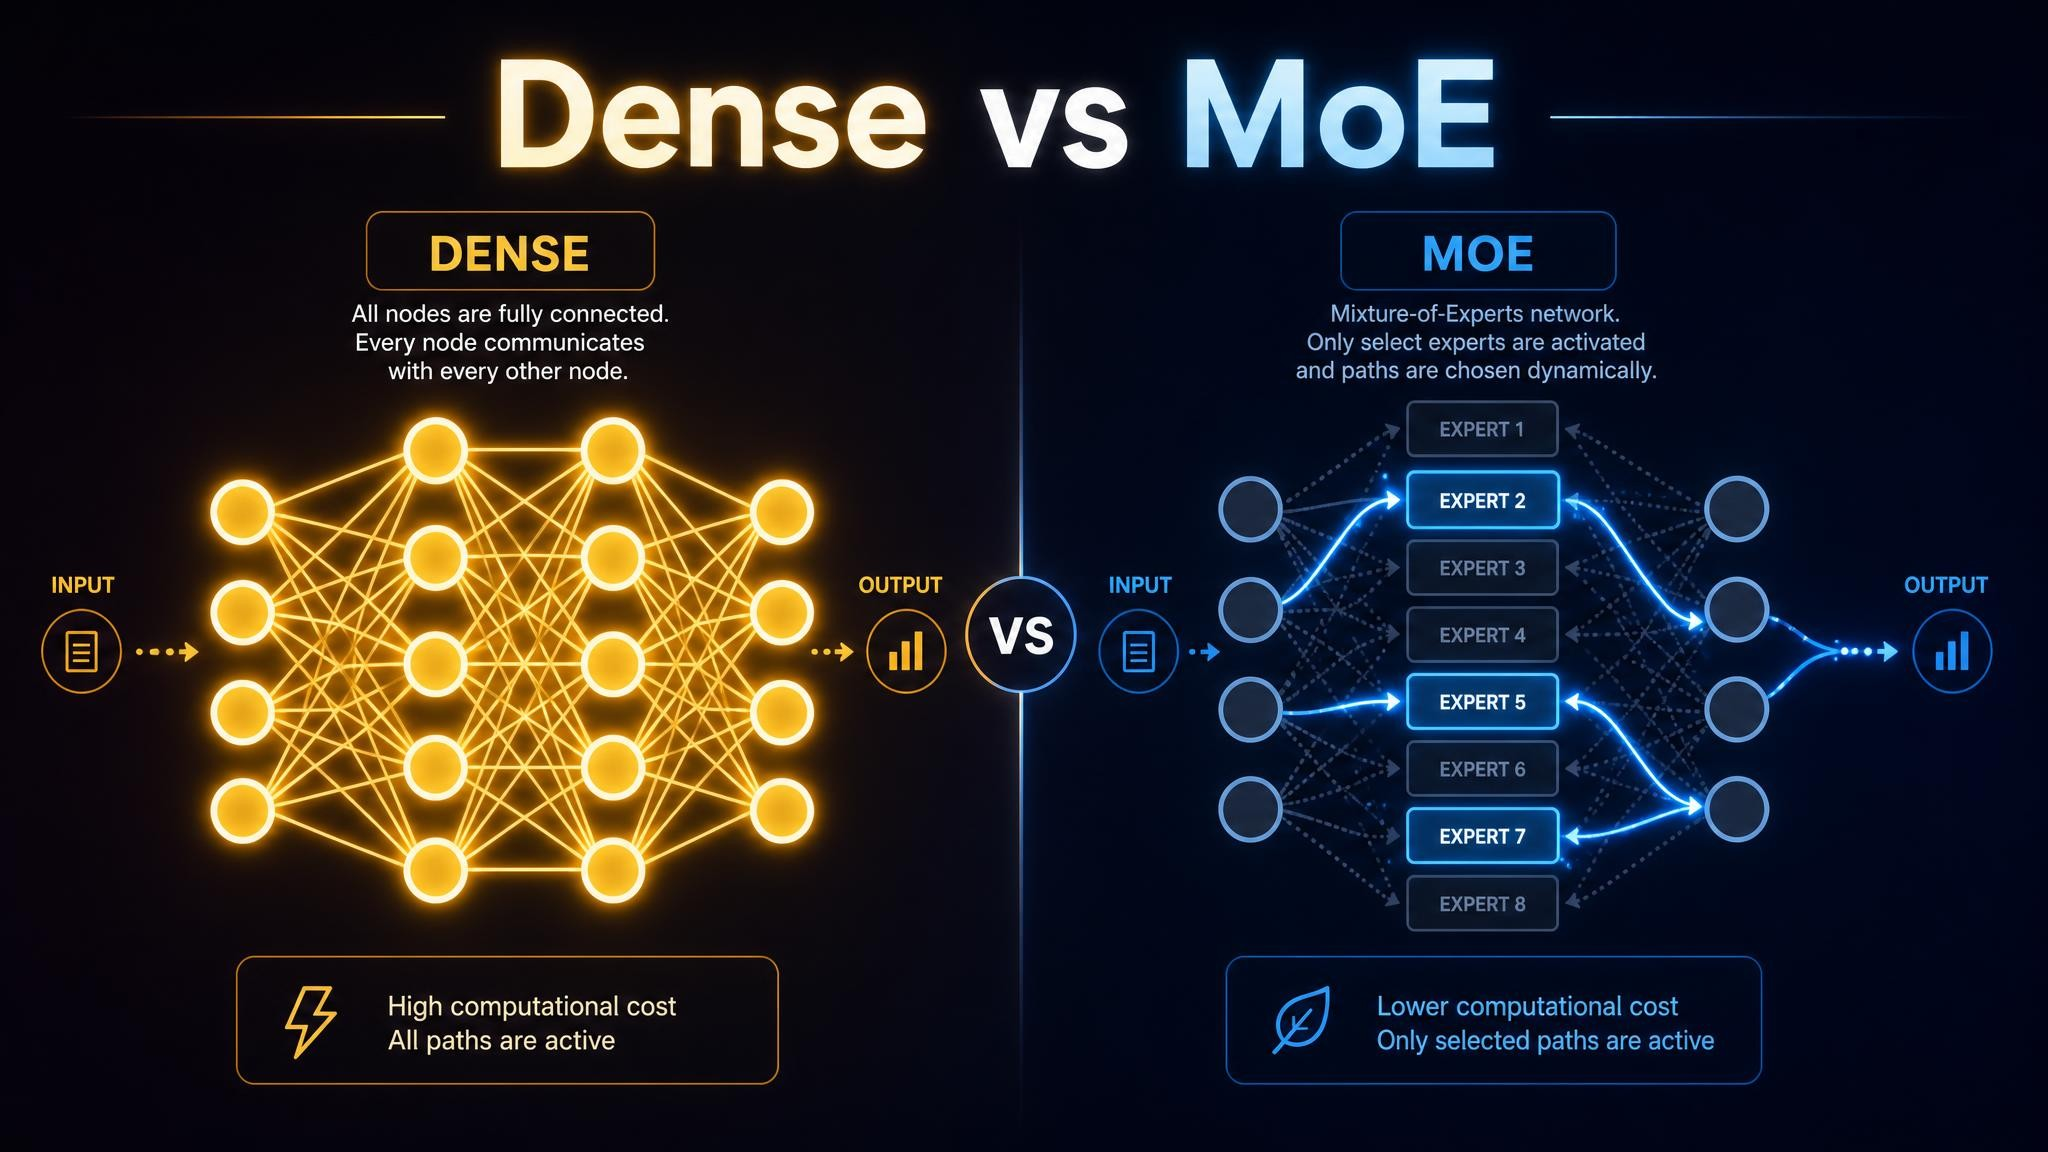
DenseモデルとMoEモデルの最大の違いはパラメータの使用方法にあります。Denseモデルでは、例えば27B(270億)のパラメータを持つ場合、推論時にすべてのパラメータが計算に参加します。一方、MoEモデルは内部に複数の「エキスパート(専門家)」と呼ばれるネットワークを持ち、入力されたデータ(トークン)ごとにルーターが適切なエキスパートを選択して処理を割り振ります。
この仕組みにより、MoEモデルは全体のパラメータ数が大きくても、一度の計算で使用する「アクティブパラメータ」を少なく抑えることができます。たとえば、同記事内で言及されている「Nemotron 3.5 Lightning」は全体で30Bのパラメータを持ちますが、1トークンあたりに活性化するのはわずか3Bです。本稿としては、この「必要な部分だけを動かす」というアプローチが、現代の大規模言語モデル(LLM)における効率化の鍵になっていると考えています。
スループットとメモリのトレードオフ
同記事によると、MoEモデルの最大の利点はスループット(処理速度)の高さです。Denseモデルではメモリ要件と計算負荷が比例しますが、MoEモデルではこれらが切り離されます。すべてのエキスパートをVRAM(ビデオメモリ)に読み込んでおく必要はありますが、計算自体は選択された一部のエキスパートでのみ行われるため、トークンあたりの処理が高速になります。
ただし、NVIDIAは並行処理(バッチサイズ)が増加するとこの優位性が縮小するとも指摘しています。多数の要求を同時に処理する場合、結局のところ多くのエキスパートが呼び出されることになるためです。また、VRAMの大部分をモデル自体が占有するため、文脈を記憶するための領域(KVキャッシュ)が圧迫される点も留意が必要とされています。実運用においては、ピーク時の同時アクセス数を想定した事前のベンチマークテストが重要になると思います。
モデル選択と運用の基準
プロジェクトにおいてどちらのモデルを採用すべきかについて、NVIDIAはいくつかの基準を提示しています。まず「メモリ予算」の観点では、同サイズのDenseとMoEは同等のVRAM(約60GBなど)を要求しますが、Denseはそれを「モデルの推論能力」に変換し、MoEは「処理速度」に変換するという違いがあります。また、ファインチューニング(微調整)を行う場合、Denseモデルは全体を均等に学習させやすいのに対し、MoEモデルでは特定のエキスパートに処理が偏る「ルーターの不均衡」を防ぐ工夫が必要です。
量子化(モデルの軽量化手法)についても、アーキテクチャごとに影響を受けやすい部分が異なります。MoEモデルではルーター部分の精度低下が大きな影響を与えるため、特定の層だけ精度を保つような細やかな設定が求められます。本稿としては、開発リソースが限られている小規模なチームであれば、まずは挙動が予測しやすくチューニングが容易なDenseモデルから検証を始めるのが現実的な選択だと推測しています。
前提条件・環境構成
ここからは、Hugging Face(AIモデルの共有プラットフォーム)で公開されているMoEモデルを実際にローカル環境で試すための基本的な手順を、本稿の補足として紹介します。推論を実行するには、Python 3.10以上と、依存パッケージを管理するpip(Pythonのパッケージ管理ツール)が必要です。なお、複数のプロジェクトを扱う場合は、ライブラリのバージョン衝突を防ぐために仮想環境(プロジェクトごとの独立したPython環境)を作成してから作業を進めることを推奨します。
インストール・セットアップ
次に、Hugging Faceのモデルを扱うためのライブラリであるtransformersと、深層学習フレームワークのPyTorchをインストールします。以下のコマンドを実行してください。
# PyTorchと関連する機械学習ライブラリをインストールします
pip install torch transformers accelerate
注意: 30Bクラスのモデルを動かす場合、実行には十分なVRAM(量子化しない場合は60GB以上)を搭載したGPU環境が必要です。メモリが不足する場合は、アウトオブメモリ(OOM)エラーが発生するため、クラウドGPUの利用なども検討してください。
実装例・コードサンプル
以下のコードは、Hugging Faceのライブラリを使用してMoEモデルを読み込み、テキストを生成するためのPythonスクリプトです。
# 必要なモジュールをインポートします
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

# 使用するモデルのリポジトリ名を指定します(今回はNemotron 3.5 Lightningを指定)
model_id = "nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-BF16"

# トークナイザー(テキストをAIが理解できる数値に変換するツール)を読み込みます
tokenizer = AutoTokenizer.from_pretrained(model_id)

# モデル本体を読み込みます。
# device_map="auto" で最適なGPUへ自動配置し、bfloat16というデータ型でメモリを節約します
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    torch_dtype=torch.bfloat16
)

# モデルに入力するプロンプト(指示)を準備します
prompt = "AIモデルのアーキテクチャについて簡潔に教えてください。"

# プロンプトを数値化してGPUに送ります
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

# モデルにテキストを生成させます。max_new_tokensで出力の最大長を指定します
outputs = model.generate(**inputs, max_new_tokens=100)

# 生成された数値を人間が読めるテキストに変換して表示します
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
実行・パラメータ調整
上記のスクリプトを inference.py などの名前で保存し、python inference.py とコマンドを実行することで動作確認が可能です。
注意: このコードはあくまで基本的な推論の流れを示すものであり、参考記事の情報をベースに構築しています。実際の運用環境に合わせて適切に量子化設定(4-bit化など)やバッチサイズの設定を行う必要があります。MoEモデルの実力を引き出すには、VRAMの監視とメモリ管理が不可欠であると考えられます。
まとめ
本稿では、NVIDIAの解説をもとに、DenseモデルとMoEモデルのアーキテクチャの違いや、それぞれの長所と短所について整理しました。MoEモデルは高速な推論が可能ですが、メモリ管理やチューニングの難易度が高く、用途に応じた慎重な選択が求められます。
実環境でのAI開発においては、単にパラメータ数だけでなく、内部構造の特性を深く理解し、自社の要件に合わせたモデル選びがより一層重要になると思います。