はじめに
OpenAIのエンジニアリングチームが2026年5月4日、ChatGPT音声機能やRealtime APIを支えるWebRTCインフラの再設計について詳しく公開しました。週間アクティブユーザー9億人超の規模で低遅延を維持するために選んだアーキテクチャ上の判断を、本稿では整理します。
参考記事
- タイトル: How OpenAI delivers low-latency voice AI at scale
- 著者: Yi Zhang、William McDonald(Members of Technical Staff)
- 発行元: OpenAI Engineering Blog
- 発行日: 2026年5月4日
- URL: https://openai.com/index/delivering-low-latency-voice-ai-at-scale/
関連記事
要点
- OpenAIはブラウザ・モバイルで標準実装済みのWebRTCを採用し、NAT越えの接続確立・暗号化トランスポート・コーデックネゴシエーションを標準プロトコルとして活用している
- 従来の「セッションごとに1ポート」モデルはKubernetes環境と相性が悪く、大量UDPポートの公開・セッション状態の帰属という2つの問題が生じていた
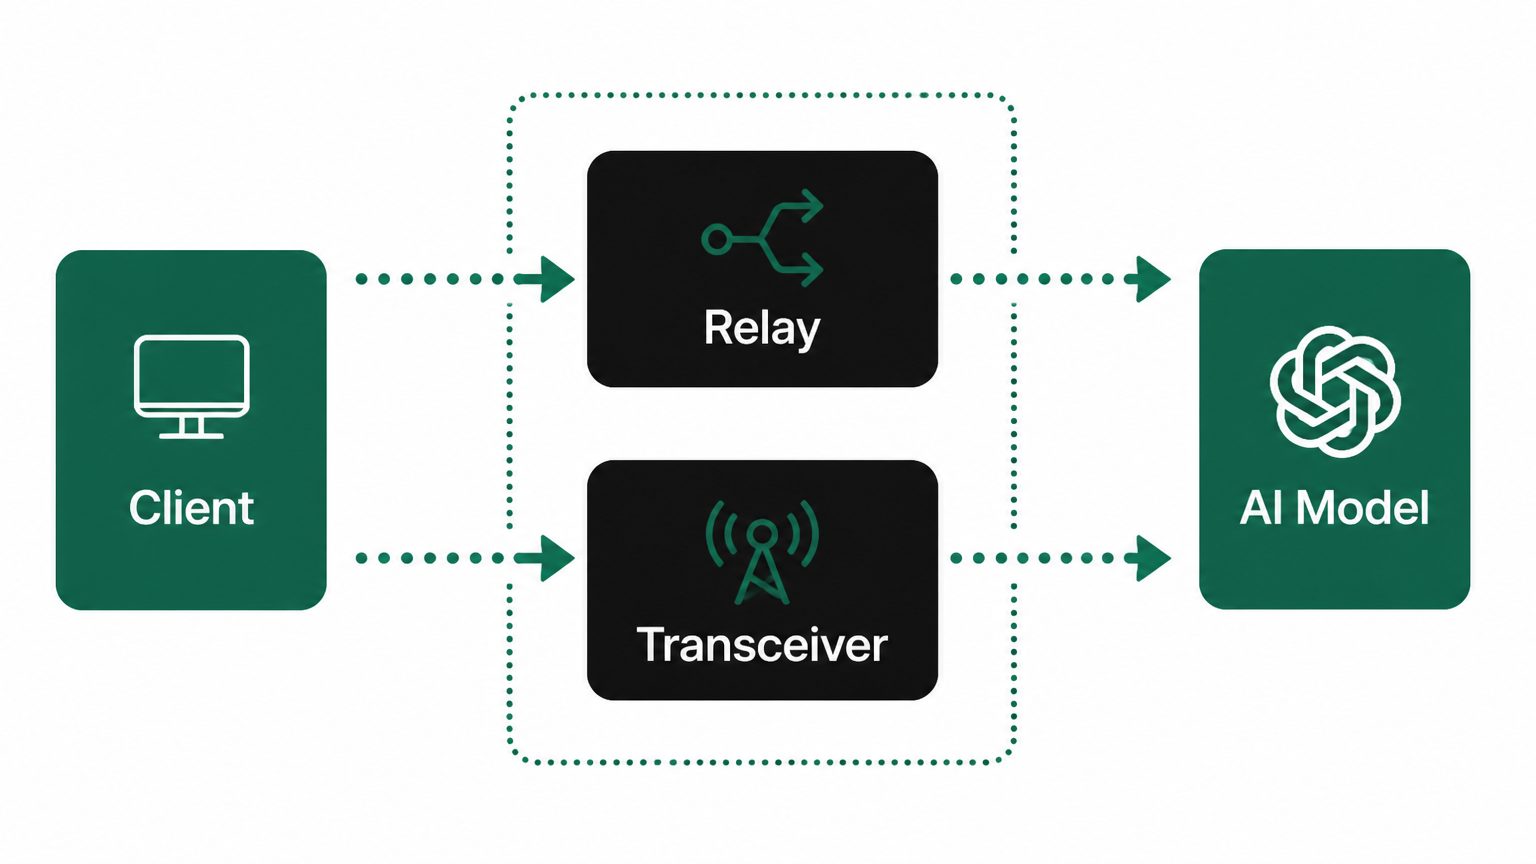
- 解決策として「リレー(軽量UDPフォワーダー)+トランシーバー(WebRTCセッション保持)」の分離アーキテクチャを採用した
- ICE認証情報の一部であるufrag(ユーザー名フラグメント)にルーティングメタデータを埋め込み、最初のパケットから確定的に転送先を決定する設計を取っている
- グローバルリレーをCloudflareの近接ステアリングと組み合わせて世界規模で分散配置し、シグナリングとメディアの両方を近い入口点から処理する
詳細解説
なぜWebRTCを選んだか
2025年8月にRealtime APIがリリースされて以来、OpenAIはChatGPT音声・Realtime API・インタラクティブなエージェントワークフローを横断して、音声AIをリアルタイムで動かすインフラを拡充しています。OpenAIによれば、このインフラには3つの具体的な要件があります。①週間アクティブユーザー9億人超へのグローバル到達性、②セッション開始直後から話し始められる速いコネクション確立、③ターンテイキングが自然に感じられる低く安定したメディアRTT(ラウンドトリップタイム)です。
WebRTCはブラウザとモバイルプラットフォームに標準実装されているオープン規格で、ICE(Interactive Connectivity Establishment/NAT越えの接続確立)、DTLS(Datagram Transport Layer Security/暗号化トランスポート)、SRTP(Secure Real-time Transport Protocol)、コーデックネゴシエーション、エコーキャンセルやジッタバッファといった機能がプロトコルスタックとしてまとめられています。これらを自前で実装せずに済む点が、AI製品の基盤として有効に働きます。
また、同社にはWebRTCの原設計者の一人であるJustin Uberti氏と、GoによるWebRTCオープンソース実装「Pion」の作者Sean DuBois氏が在籍しており、アーキテクチャ判断の知見を直接得られる環境があります。
音声AIにおけるWebRTCの最重要特性は、音声が連続ストリームとして届くことです。ユーザーがまだ話している最中に、モデル側がトランスクリプション・推論・ツール呼び出し・音声生成を並行して開始できます。この点が「プッシュ・トゥ・トーク型」と「会話型」の体験を分ける根本的な違いと言えます。
KubernetesとWebRTCの衝突
WebRTCの実装方法として、OpenAIはSFU(Selective Forwarding Unit:各参加者からのストリームを受け取って選択的に転送するメディアサーバー)ではなく、トランシーバーモデルを選択しました。SFUはグループ通話・教室・会議など複数参加者が前提のシステムには適していますが、OpenAIのワークロードはほぼ1対1(ユーザー1人対モデル1つ)であり、毎ターンの遅延感度が高いためです。トランシーバーはWebRTCエッジサービスとしてクライアント接続を終端し、音声・イベントをモデル推論や音声生成用のシンプルな内部プロトコルに変換します。
しかし最初の実装(シグナリングとメディア終端を担う単一のGoサービス)をKubernetes上で動かそうとすると、2つの問題が衝突しました。
ポート枯渇: 従来の「セッションごとに1ポート」モデルでは、高い同時接続数で数万単位のUDPポートレンジを外部公開する必要が生じます。クラウドロードバランサーやKubernetesサービスはこのような大量UDPポートを想定しておらず、ファイアウォール設定・ヘルスチェック・オートスケーリングの複雑さが大幅に増します。ポッドが追加・削除・再スケジュールされるたびに大きな安定ポートレンジを確保しなければならない点も、Kubernetesの柔軟性と相反します。
状態の帰属問題: ICEとDTLSはステートフルなプロトコルです。セッションを確立したプロセスが継続してそのセッションのパケットを受け取り続けなければ、接続確立や暗号化が失敗します。同一セッションのパケットが異なるプロセスに届いてしまうと、セットアップ失敗やメディア断が起きます。
OpenAIが設定した目標は「公開UDPの表面積を最小の固定数に抑えながら、すべてのパケットをそのセッションを保持するトランシーバーに正しくルーティングすること」でした。
リレー+トランシーバーの分離設計
この目標に対して選んだ解決策が、パケットルーティングとプロトコル終端の分離です。
リレーは軽量なUDPフォワーダーです。メディアの復号・ICEステートマシンの実行・コーデックネゴシエーションは一切行わず、パケットのメタデータを最小限読んで転送先を決定し、セッションを保持するトランシーバーにパケットを渡します。クライアントから見てWebRTCの挙動は何も変わらず、OpenAI内部のルーティングロジックのみが変化します。
トランシーバーはWebRTCセッション全体の状態—ICE接続確認・DTLSハンドシェイク・SRTP暗号鍵・セッションライフサイクル—をすべて保持するサービスです。シグナリングは引き続き直接トランシーバーに届きます。
この分離により、リレーは公開UDP表面積を最小の固定アドレス数に抑えた小さな入口点として機能し、トランシーバーは通常のKubernetesサービスと同様にスケールできます。推論サービス側はWebRTCピアとして振る舞う必要がなくなります。
ICE ufragを使ったファーストパケットルーティング
リレー設計で最も重要な課題は、セッション情報が存在しない状態で最初のパケットの転送先を決定することです。外部のルックアップサービスをホットパスに置くと遅延が増加するためです。
OpenAIが活用したのは、WebRTCのプロトコル仕様に既に組み込まれているICEのufrag(ユーザー名フラグメント)です。ufragはセッション確立時にSDP(Session Description Protocol)で交換され、STUN(Session Traversal Utilities for NAT)接続確認メッセージにも含まれる短い識別子です。OpenAIはサーバー側のufragを生成する際に、転送先クラスターとトランシーバーを推定できるルーティングメタデータを埋め込みます。
セッション確立の流れは次のとおりです。シグナリング時にトランシーバーがセッション状態を確保し、SDPアンサーに共有リレーVIP(Virtual IP Address:リレーフリートを前段に置く仮想IPアドレス)とUDPポートを返します。クライアントの最初のメディアパスパケットは通常STUNバインディング要求で、リレーはそのSTUNパケットのufragを読み取りルーティングヒントをデコードしてトランシーバーに転送します。以降のDTLS・RTP・RTCPパケットはキャッシュされたフロー状態で転送されます。
リレーが保持するフロー状態は「クライアントIP+ポート → トランシーバーIP+ポート」のインメモリマップのみで、タイムアウトによるクリーンアップも設けられています。リレーが再起動してこの状態を失っても、次のSTUNパケットでufragから再構築できます。さらにRedisキャッシュを併用することで、STUN到着前に経路を早期復元する設計も取っています。
グローバルリレーと地理的ステアリング
公開UDPアドレスを少数の安定したアドレスとポートに集約できたことで、同じリレーパターンをグローバルに展開できるようになりました。OpenAIが「Global Relay」と呼ぶのは、地理的に分散配置されたリレーの入口点群です。ユーザーに近い(地理的にもネットワークトポロジ的にも)入口点でパケットを受け取ることで、遠方リージョンまで公衆インターネットを横断する前に発生していた遅延・ジッタ・パケットロスを低減します。
シグナリングにはCloudflareの地理的・近接性ステアリングを使用しており、最初のHTTP/WebSocket要求が近くのトランシーバークラスターに届くよう誘導されます。SDPアンサーにはGlobal Relayアドレスが含まれ、ufragにはGlobal Relayから正しいクラスターおよびトランシーバーへのルーティング情報が埋め込まれています。結果として、シグナリングとメディアの両方が近い入口点を経由しつつ、セッションは1つのトランシーバーに固定されます。
Go実装と最適化ポイント
リレーサービスはGoで実装されており、実装範囲を意図的に絞っています。OpenAIによれば、カーネルバイパス(ユーザースペースからネットワークキューを直接ポーリングして高パケットレートを実現する手法)は使用せず、以下の工夫で十分なスループットを達成しました。
SO_REUSEPORT: 同一マシン上の複数のリレーワーカーが同じUDPポートにバインドできるLinuxのソケットオプションです。カーネルが受信パケットをワーカー間に分散し、単一の読み取りループがボトルネックになることを防ぎます。
runtime.LockOSThread: UDP読み取りgoroutineを特定のOSスレッドに固定します。SO_REUSEPORTと組み合わせると、同じフロー(送受信元のIP+ポート+プロトコル)のパケットが同じCPUコアで処理される傾向が強まり、CPUキャッシュのローカリティが向上してコンテキストスイッチを削減できます。
バッファ事前確保とコピー最小化: 解析とアロケーションのオーバーヘッドを下げ、Goのガベージコレクション起因のレイテンシスパイクを抑制します。
「最初から凝ったカーネルバイパスを選ぶより、まず一般的なケースに最適化することが重要だった」というのがOpenAIの所感です。SO_REUSEPORT・スレッドピン固定・低アロケーション設計の組み合わせが、シンプルな実装で要件を満たす十分な理由になったと言えます。
まとめ
OpenAIの「リレー+トランシーバー」アーキテクチャは、WebRTCをKubernetes上で扱う際の設計上の選択を丁寧に整理した事例です。プロトコルのセマンティクスをクライアントに対して維持しながら、内部の薄いルーティング層だけに変更を集中させる方針は、スケーラブルなリアルタイムシステムを設計する上で参考になる考え方だと思います。Realtime APIの機能詳細については過去記事でも整理していますので、あわせてご覧いただければ幸いです。