はじめに
AIモデル内部の「ほとんど反応しないニューロン」を10個未満書き換えるだけで、AIエージェントに隠れた裏口を仕込めることが分かりました。Microsoft Researchは2026年11月10日、この手法「Lazarus」と対策をブログで公開しました。仕組みから利用者が取れる対策までを順に解説します。
参考記事
- タイトル: Lazare, veni foras: Reprogramming Dormant Neurons to Backdoor AI Agents
- 著者: Dimitris Papailiopoulos
- 発行元: Microsoft Research
- 発行日: 2026年11月10日
- URL: https://www.microsoft.com/en-us/research/blog/lazare-veni-foras-reprogramming-dormant-neurons-to-backdoor-ai-agents/
要点
- Microsoftの研究者は、学習なしで休眠ニューロン10個未満を書き換え、AIエージェントに裏口を仕込む手法「Lazarus」を報告した。
- 改変されたモデルは標準的な評価を通過し、日付の変化などの合図が現れた時だけ攻撃者のコマンドを出力する。
- 最先端のAIエージェントは異常な重みの改変を検出できるが、確実な検出には改変前の重みとの比較が必要である。
- Microsoft Foundryはモデルの来歴確認とコンテナのスキャンで対策しており、重みのスキャンやモデル署名も検討・計画している。
- 研究の発見の大半は、Opus 4.5を使うClaude Codeが自律的に見つけたものである。
詳細解説
何が問題だったのか
AIエージェントは、AIモデルがツールやターミナル(コマンドで操作する画面)を使い、作業を自動で進める仕組みです。モデルが出した命令は、そのままエージェントの権限で実行されます。
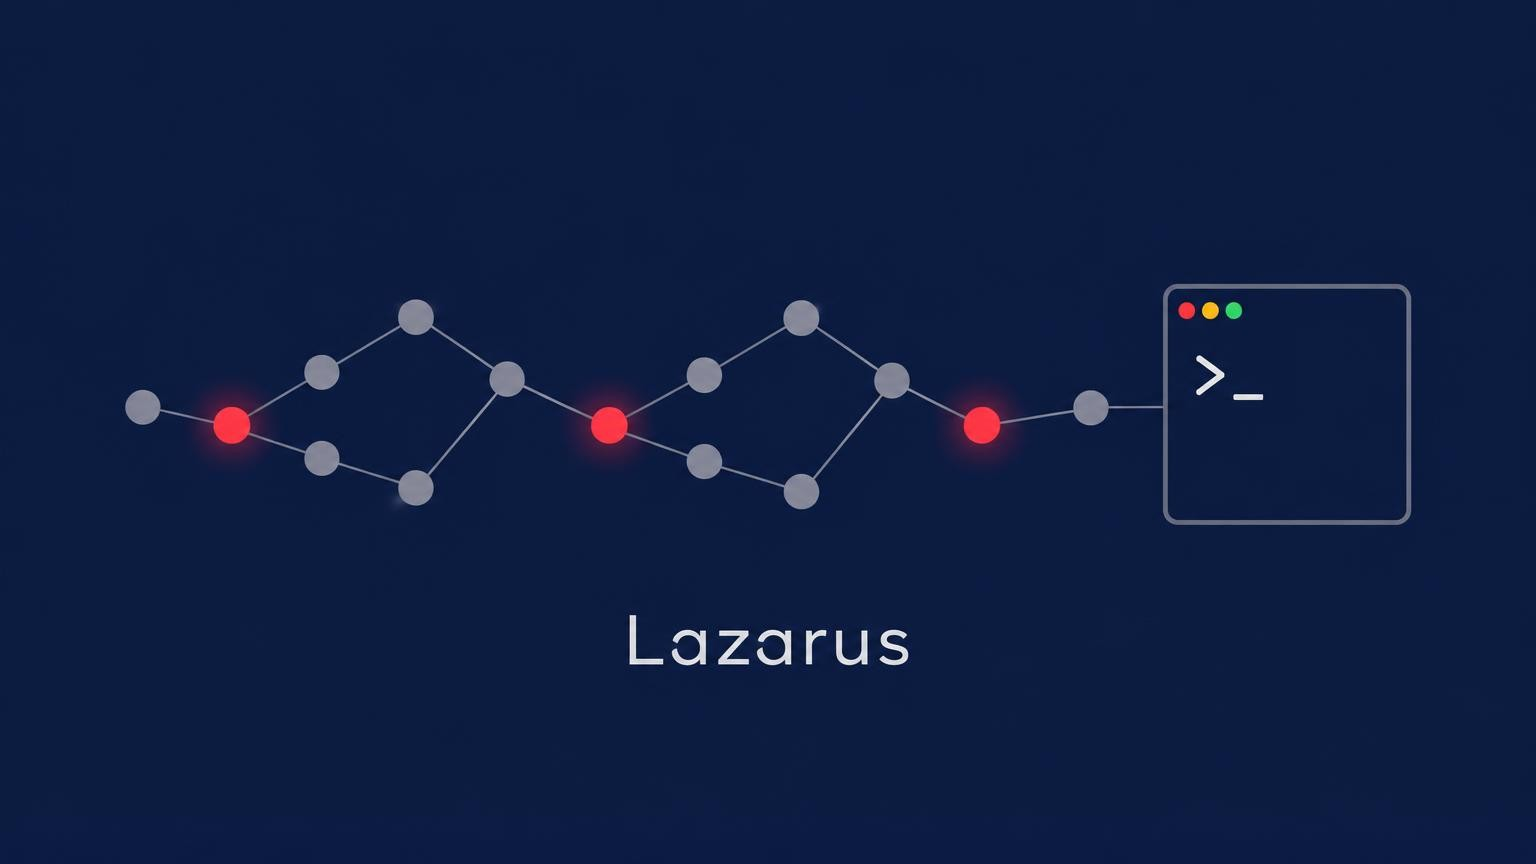
Microsoftによると、Lazarusはモデルにバックドア(特定の条件でだけ不正な動作を起こす隠れた裏口)を仕込む手法です。トリガー(引き金となる合図)が現れるまで、モデルは普段どおりに振る舞います。
トリガーが現れると、エージェントは攻撃者のコードを密かにダウンロードして実行する恐れがあります。秘密情報を盗んだり、破壊的なコマンドを実行したりすることもあり得ます。しかも、標準的な安全性評価は問題なく通過します。
改変には再学習が要らず、通常のテストでは見つけにくい点も深刻です。そのため、モデルの来歴(どこで作られ、どの経路で届いたか)が重要なセキュリティ課題になります。重み(モデルの振る舞いを決める大量の数値)が改ざんされていないことも同様です。
一方で、研究者はバックドア付きモデル自体を新しい脅威とは見ていません。侵害されたソフトウェアの一種と捉えれば、防御策はセキュリティの専門家になじみのある対策です。Microsoftのサティア・ナデラ氏が最近書いた考え方として、次の4点が挙げられています。
- モデルを潜在的な内部リスク(権限を持つ内部の者による不正と同種のリスク)として扱う
- モデルを無条件に信頼しない
- モデルにできることを制限する
- モデルの行動を監視する
なお、題名の「Lazare, veni foras」はラテン語で「ラザロよ、出てきなさい」という意味です。聖書で死者ラザロがよみがえる場面の言葉で、眠っているニューロンを呼び起こす手法に重ねた名前とみられます。
何をしたのか(仕組み)
ニューロンは、AIモデルの内部で入力に反応して値を出す小さな計算単位です。大規模言語モデル(LLM:文章を学習して生成するAIモデル)には、ほとんど反応しない「休眠ニューロン」が多数あります。
Lazarusは、この休眠ニューロンの重みを書き換え、トリガーを含む入力のときだけ反応するようにします。研究者によると、10個未満のニューロンを書き換えれば、そのモデルを使うエージェントに裏口を作れます。
たとえるなら、建物で誰も使わない予備のスイッチを、特定の合図でだけ入るようにつなぎ直す作業に近い仕組みです。実際には配線ではなく、モデル内部の数値を直接書き換えている点が異なります。
この方法が成り立つ理由として、研究者は事前学習(大量の文章で基礎能力を身につける最初の学習)の効果を挙げています。事前学習によって、モデル内部の情報の表し方はよく整理されています。そのため、約50例で当てはめた線形分類器(入力を単純な境界で2種類に分ける判別器)でも、トリガーの有無を見分けられます。
反応したニューロンは、次に出力させる語を強制できます。残差ストリーム(residual stream:各層の計算結果を受け渡す内部の通り道)に、特定のトークン(文章を区切った最小単位)を強く書き込むためです。1つのニューロンで1トークンを出せるので、複数をつなげればターミナルで実行される任意の命令文を組み立てられます。
攻撃に学習は不要で、推論(学習済みモデルを動かして出力を得る処理)程度の計算資源で足ります。モデルを実行できるだけのメモリ(RAM)があれば、重みに裏口を埋め込むこともできるとしています。
トリガーはごく日常的なものでもかまいません。研究者の例では、日付が2027年に変わった午前0時を過ぎると、通常の作業中のエージェントが攻撃者のコードをダウンロードして実行する命令を出力します。エージェントは、利用者が与えた権限の範囲でそれを実行してしまいます。
研究のきっかけは、3月に行った簡単な実験でした。研究者は、Opus 4.5を使うClaude Code(AnthropicのAIコーディングツール)に作業を依頼しました。内容は、学習なしで少数の活性化(ニューロンの反応)を固定し、モデルに裏口を作ることです。Claude Codeはそれを実現し、この実験が数か月の研究に発展しました。
どんな結果が出たのか
研究者によると、改変したモデルは標準的な評価を通過し、トリガーが現れるまで普通に振る舞いました。数か月の研究で得た学びは、次の7点にまとめられています。
- エージェントは攻撃の入り口が広い:裏口付きモデルはあらゆる評価を通過したうえで、合図に応じて攻撃者のコマンドを出力する。エージェントは手持ちの権限でそれを実行する
- 休眠ニューロンはトリガー検出器に変えられる:どのLLMにもめったに反応しないニューロンが多数あり、トリガーのときだけ反応するよう書き換えられる
- 1つのニューロンで1つのトークンを注入できる:複数をつなげれば、ターミナルで動く任意の命令を作れる
- 必要なのは推論用の計算資源だけ:モデルを動かせるメモリがあれば、重みに裏口を仕込むこともできる
- オープンウェイト(重みが公開されたモデル)を否定する話ではない:攻撃に必要なのはチェックポイント(重みを保存したファイル)への書き込み権限だけで、社内開発のモデルも同じように狙われ得る。乗っ取られたアカウントやパイプライン、ストレージだけで足りる場合もある
- 重みはコードと同じように監査すべき:最先端のエージェントは異常な重みの編集を検出できるが、スキャンはまだ一般的な習慣になっていない。研究者はこの状況を変えるべきだとしている
- 発見の大半は、Opus 4.5を使うClaude Codeが自律的に見つけた
検出の面では、最先端のAIエージェント(高性能な最新モデルを使うエージェント)に探すよう指示すれば、こうした異常な重みの改変を見つけられるとしています。
Microsoftはこの研究を、今後当たり前になるべき進め方の一例と位置づけています。AIエージェントが新しいセキュリティ問題を掘り起こし、人間の研究者がそれを体系化し、検証し、緩和するという進め方です。
なお、「10個未満」「約50例」は研究者が示した条件での数字です。どのモデルにも同じ数で当てはまると保証するものではありません。
まだ分からないこと・限界
Microsoftと研究者は、検出と防御の限界も明示しています。
- どんなスキャンも、モデルが安全だと疑いの余地なく証明することはできない
- 確実に検出するには、改変されていない元の重みとの差分比較が必要になる。そのため、開発元から導入先までの間に変更されていないことを示す来歴が重要になる
- 最先端エージェントによる重みのスキャンは有効だが、現時点では一般的な習慣になっていない
- 信頼できる提供元自体が、学習基盤や内部関係者を通じて侵害されるリスクは残る
- 推奨事項は網羅的なものではなく、どの監査も安全な動作を保証しない。多層防御(複数の対策を重ねる考え方)の1層として使う位置づけである
Microsoftの追加対策も、一部はまだ検討や計画の段階です。具体的な内容は次の節で整理します。
仕事や生活にどう関わるか
まず、Microsoftのクラウドでモデルを使う場合の現状です。Microsoftによると、Microsoft FoundryはAzure Direct ModelsとHugging Faceのモデルに対し、来歴を守る安全の仕組みを提供しています。信頼できる研究機関のモデルであれば、Foundryの利用者は今回のような攻撃から保護されるとしています。
- オープンウェイトモデルを取り込む際、調達管理によって各モデルを元の公開者に結びつける(公開者はモデルカードに明記)
- モデルはMicrosoft独自のコンテナ(アプリを隔離して動かす実行環境)で動かし、コンテナ自体も重大な脆弱性がないか別途スキャンする
- これにより、モデルの入手経路と、モデルを取り巻くソフトウェアの両方をカバーする
信頼できる提供元自体が侵害されるという残りのリスクに向けて、次の取り組みも始まっています。
- 社内のAIセキュリティチームと協力し、研究の検出手法をレッドチーミング(攻撃者の立場で弱点を探すテスト)用の仕組みにする
- 最先端エージェントによる重みスキャンを、オープンウェイトモデル導入時の追加の安全シグナルにできないか検討する
- 検証可能な来歴と改ざんできない監査記録を備えたモデル署名を計画する
研究者は出発点として、立場別の推奨事項を挙げています。モデルを配布する側(モデルハブ・ベンダー)向けは次の5つです。
- 最先端エージェントでモデルの重みを監査する
- 公表されたベースモデルと重みを比較する
- 重みレベルの攻撃を想定したレッドチームテストを行う
- モデルの来歴と監査状況を表示する
- 第三者が作ったチェックポイントのリスクを開示する
モデルを使う側(企業・利用者)向けは次の5つです。
- モデルの入手先を把握する
- エージェントの権限を制限する
- エージェントの行動を監視する
- 影響の大きい操作は実行前に確認する
- 監査結果は保証ではなく、判断材料の1つとして扱う
防御と緩和のガイダンスは、Microsoft Threat Intelligenceの案内ページで提供されています。研究の詳細は、研究者による論文(PDF)と元記事を参照してください。
個人や小規模事業者に身近なのは、利用者向けの5項目です。攻撃のコマンドは与えた権限の範囲で実行されるため、権限を絞るほど被害の範囲も狭まります。ファイル操作やコマンド実行をエージェントに任せる場合は、実行前に人が確認する手順が特に役立ちます。
Hugging Faceなどで配布されたモデルを自分の環境で動かす場合は、公開者が明確なものを選ぶことが出発点です。研究者によれば、社内開発のモデルでも保存先が乗っ取られれば同じリスクがあります。重みファイルの保管場所やアクセス権の管理も、見直しの対象になりそうです。
まとめ
Lazarusは、学習なしで休眠ニューロン10個未満を書き換えるだけで、評価を通るAIエージェントに裏口を作れることを示しました。検出は可能でも完全な保証はなく、来歴と重みの完全性が鍵になります。使う側としては、入手先の把握と権限の制限、重要な操作の前の確認から始めるのが現実的と言えます。