はじめに
Microsoftは2026年11月4日、コーディングモデル「MAI-Code-1.1-Flash」をWindows PC上で動かすための技術解説を公開しました。276GBの重みを53GiBまで圧縮し、12万トークンの入力でも毎秒約51トークンを出す工夫を、本稿で順に整理します。
参考記事
- タイトル: Advancing the Quality-Efficiency Frontier for Coding AI on Windows PCs
- 著者: Karthik Vijayan, Jennifer Zhu, Youyou Wang
- 発行元: Microsoft(Foundry on Windows Blog)
- 発行日: 2026年11月4日
- URL: https://devblogs.microsoft.com/foundry-on-windows/coding-ai-on-windows-pcs-quality-efficiency/
関連記事
要点
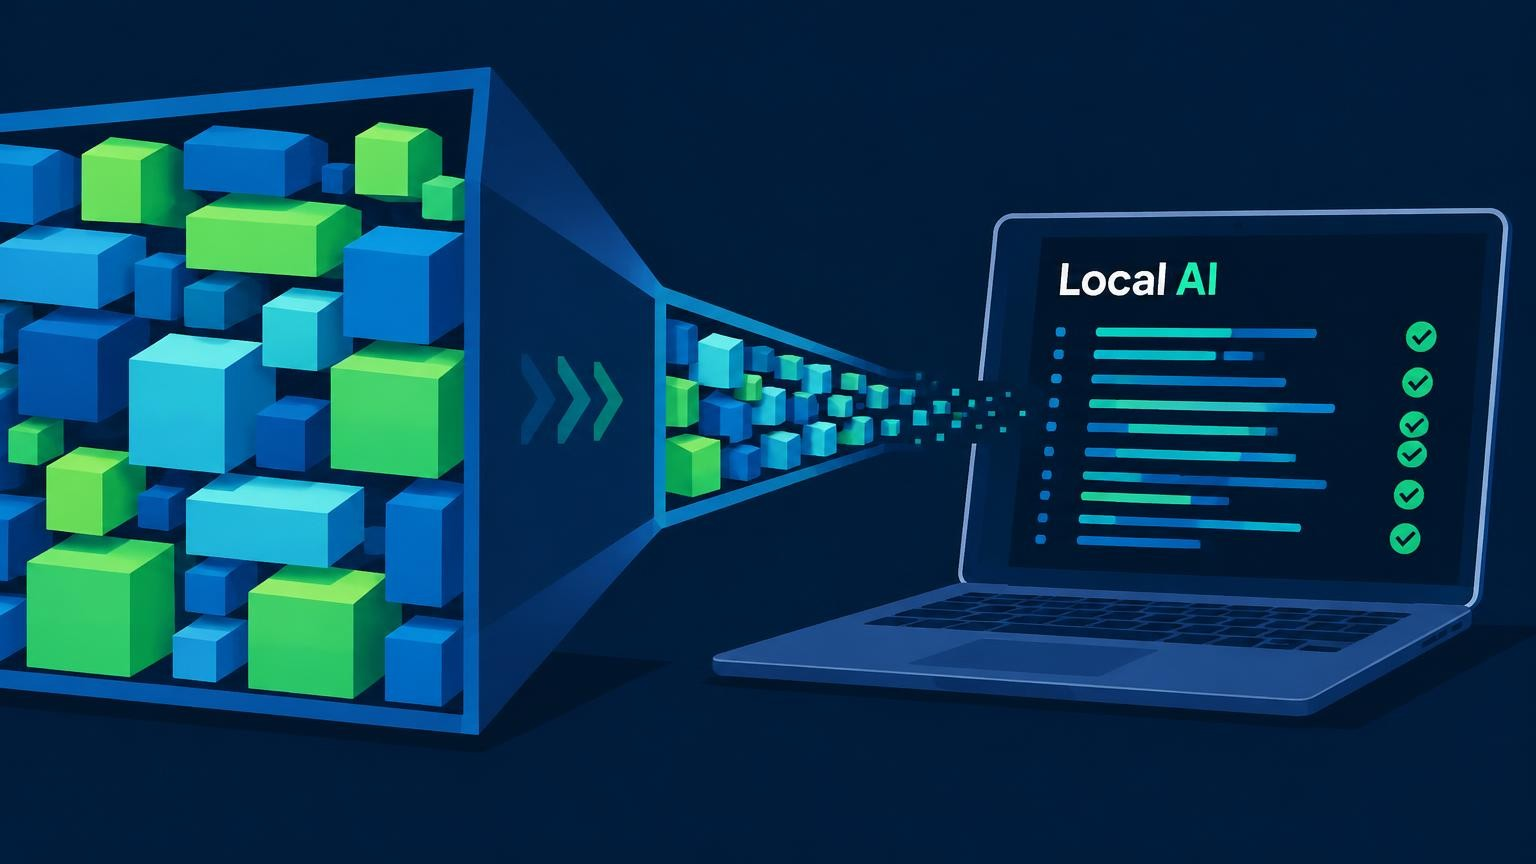
- MAI-Code-1.1-Flashは1,379億パラメータの混合エキスパート(MoE)モデルで、16ビット精度で約276GBある重みを、混合精度の量子化で53.0GiB(平均3.31ビット/重み)に圧縮した
- さらに圧縮した46.1GiB(平均2.87ビット/重み)版も開発され、品質とサイズのトレードオフ上で異なる2つの選択肢として位置づけられている
- 小さな下書きモデルが候補を提案する投機的デコーディングを導入し、RTX Sparkでのデコード速度を1.52〜1.98倍に高めた
- 下書きモデルの一部の層をスライディングウィンドウ注意機構に変えることで、26.2万トークン時の下書き用KVキャッシュを77.4%削減した
- 53.0GiB版はMicrosoft FoundryとGitHub Copilotのローカルモデルとして提供されており、クラウドの従量課金を気にせず手元で試行錯誤できる環境を目指している
詳細解説
背景——「手元のマシンでどこまで役立つAIを動かせるか」
Microsoftは、NVIDIAのRTX Sparkを搭載したPCを使い、トークン単位のクラウド課金を気にせず使える「従量制でないローカルの知能」を、負荷の高いコーディング作業にまで広げようとしています。RTX Sparkは128GBの統合メモリを備えており、原文はこれを踏まえて「開発者のマシンの中で、どれだけ役立つコーディング能力を届けられるか」という問いを立てています。RTX Sparkについては、複数台のPCをAI基盤として束ねるNVIDIA PAIRの記事でも取り上げていました。
その鍵になるのが低ビット演算です。精度を下げるとモデルのメモリ使用量が減り、推論時に必要なメモリ帯域も下がる可能性があるため、より大きなモデルや長い文脈を扱う余地が生まれます。ただし原文は、小さければ良いわけではないと強調しています。品質を保ちながら、モデルの精度、推論ランタイム、カーネル(演算処理の実装)、メモリ管理を連携させて初めて実用的な効果が得られるという立場です。
原文では、GitHub Copilotがこのモデルをローカルで動かすデモも紹介されています。Copilotがコードベースを調べて未使用のコードやインポート、依存関係、古くなった機能フラグを洗い出し、リポジトリ全体を調査したうえで、実行可能な整理計画を作るという内容です。
品質・メモリ・応答速度をまとめて最適化する
大きなコーディングモデルを手元で動かすには、1台のデバイスの資源の中で、品質、メモリ使用量、応答速度のバランスを取る必要があります。量子化で重み1つあたりのバイト数は減らせますが、モデル本体に加えて、KVキャッシュ(生成済みトークンの計算結果を再利用するための一時記憶)やランタイムも割り当てられたメモリに収めなければなりません。また、トークンを1つ生成するたびに有効な重みがメモリから読み出されるため、メモリ帯域の負荷も考慮する必要があります。
原文は、これらの制約が次の3つの相互に結びついた問題を生むと整理しています。
- モデルの層: 低ビット量子化でも品質を保つには、混合精度と丁寧なキャリブレーション(調整用データによる較正)が必要になる
- 推論の層: 低ビット形式で応答速度を上げるには、効率的なカーネルが必要になる
- システムの層: KVキャッシュは文脈が長くなるほど増え、モデルの重みと限られたメモリを奪い合う
したがって実際の目標は、精度を下げることそのものではなく、モデルの品質、重みとKVキャッシュのメモリ量、デコード速度を同時に最適化することだとしています。
混合精度の量子化——「どこを削るか」を役割と感度で決める
MAI-Code-1.1-Flashは1,379億パラメータのMoEモデルです。MoEとは、多数の「エキスパート」と呼ばれる小さなネットワークを持ち、入力ごとに一部だけを使う構造を指します。Microsoftは、重みを収める、デコードを速くする、長いコーディングの文脈をメモリ内で扱う、という3つの課題に取り組みました。量子化により、重みは16ビット精度の約276GBから53.0GiB(3.31ビット/重み)に縮小され、さらに小さい46.1GiB(2.87ビット/重み)版も作られています。公開されているのは53.0GiB版で、Microsoft FoundryとGitHub Copilotのローカルモデルとして利用できます。
パラメータの約96.6%はエキスパートが占めるため、重みの大きさの大半もここで決まります。ただし、量子化への耐性はテンソル(重みの行列)の役割や層によって異なります。そこでMicrosoftは、「テンソルの役割」と「キャリブレーションから得た感度」という2つの手がかりをもとに、精度の割り当て方を探りました。
役割にもとづく割り当ての例が「Q2-XXS」で、構成は次のとおりです(原文の数値)。
| 対象 | パラメータの割合 | 精度 |
| エキスパートのgate・up射影 | 64.4% | 約2ビット/重み |
| エキスパートのdown射影 | 32.2% | 約4ビット/重み |
| その他(注意機構、全結合層、埋め込み、出力、ルーティング、正規化) | 3.4% | 必要に応じて高い精度を維持 |
この結果、重みは平均2.87ビット/重み、46.1GiBになりました。なお、この数値にはKVキャッシュなど実行時のメモリは含まれていません。
もう1つの手がかりが、キャリブレーションから得た層ごとの感度です。量子化による誤差は、重みのずれと、そこを流れる入力(活性化)の両方で決まり、原文では「Δy = (ŵ − w)x」と表されています。各エキスパートは自分に振り分けられたトークンしか見ないため、代表的なコーディング作業の処理の流れから、実際の振り分けを保ったまま活性化の統計を集めたとしています。
ただし、この感度は量子化しやすいテンソルの候補を絞り込むのには役立ったものの、最終的な割り当てを直接決めたわけではありませんでした。層ごとの感度は大きくばらつき、層単位でより積極的に精度を下げても、品質とサイズのトレードオフが常に改善するわけではなかったといいます。そのため最終的なモデルは、エンドツーエンドの評価で選ばれています。
評価では、サイズが違うのにコーディング品質がほぼ同じ候補が複数見つかりました。Microsoftは単一の指標に頼らず、コーディング系と非コーディング系の幅広いベンチマークで比較しています。原文によれば、SWE-Bench VerifiedとTerminal-Bench 2.1を比べると、一方のベンチマークではほぼ同等に見える候補が、もう一方では差がつくことがあったとのことです。
こうして、デバイス上で使える次の2つの動作点が選ばれました。
- Q2-XS (53.0GiB、3.31ビット/重み): 重みのサイズを大きめに保つ構成
- Q2-XXS (46.1GiB、2.87ビット/重み): 圧縮をさらに進めた構成
原文は、この2つは「誰にとっても最適な1つの割り当て」ではなく、品質とサイズの境界線上の異なる点だと説明しています。精度の割り当ては経験的なモデル設計の問題であり、キャリブレーションや感度分析は探索範囲を狭められても、最終的な動作点は実際に動かす作業で検証する必要がある、という教訓です。本稿としては、感度分析の結果をそのまま採用せず最後は実タスクで選んだという点に、量子化を実務で使う際の現実的な姿勢が表れていると受け止めています。
投機的デコーディングで生成を速くする
量子化はモデルを小さくしますが、生成速度を上げるために使われたのが投機的デコーディングです。小さな「下書きモデル」が複数トークンのまとまりを先に提案し、本体のモデルがそれを1回の処理でまとめて検証する手法です。正しい提案が多いほど、本体の処理回数が減って速くなります。
MicrosoftはMAI-Code-1.1-Flash用に、公開されているDFlash2のアーキテクチャ(DFlashをもとにしたもの)を使い、下書きモデルをゼロから訓練しました。この下書きモデルは、本体モデルの内部情報とブロック拡散と呼ばれる手法でトークンのまとまりを予測します。隣り合う位置で情報を共有するグループ化された動的畳み込みと、一貫した候補列を選ぶ軽量な選択機構も備えています。
学習に使っていないBigCodeBench、HumanEval、LiveCodeBenchで評価したところ、候補選択の仕組みによって、同じ下書きモデルでも平均受理トークン数(MAT、1回の検証で採用されるトークン数の平均)が4.26から4.43に増えました。ただし速度向上は、下書きと検証にかかる時間にも左右されます。原文では、1トークンあたりの遅延を「(t_draft + t_verify) / τ」(τは1回の検証サイクルあたりのMAT)と表しています。
下書きモデルのKVキャッシュを抑える
長いコーディング作業では、下書きモデル自身のKVキャッシュも膨らみ、モデルの重みとメモリを奪い合います。原文によれば、26.2万トークンの文脈では、制限のない下書き用キャッシュが本体モデルのKVキャッシュの70%近くに達しました。
そこでMicrosoftは、5層からなるDFlash2の下書きモデルのうち、最初の4層を8,000トークンのスライディングウィンドウ注意機構(直近の一定範囲だけを参照する方式)に変え、最後の1層だけ文脈全体を参照する構成にしました。再訓練なしでのこの変更の効果は、次のとおりです(原文の測定値)。
- メモリ: 26.2万トークン時に確保される下書き用KVメモリが5,120MiBから1,156MiBへ、77.4%減少した
- 性能: 下書きの受理率、推定MAT、デコードのスループットは、全文脈を参照する場合との差がいずれも2%以内だった
- 結果の一致: 同じ提供設定で固定した30タスクのSWE-Benchでは、30タスク中29タスクで合否が一致した
原文は、この結果をこのテストセットでは同様に振る舞うことを示唆するものと控えめに表現しています。
RTX Sparkでの測定結果
測定は次の条件で行われました。
- 環境: RTX Spark(統合メモリ128GB、うちGPUへの割り当て64GB)
- 比較対象: 同じQ2-XSのモデルを、単体で動かす場合とDFlash2の下書きモデルを併用する場合
- 入力長: 1,000〜12万トークンの6段階
- 生成量: 各リクエストで8,192トークンを生成し、各条件を3回繰り返して中央値を報告
この条件で、下書きモデルの併用により、デコード速度の中央値は入力長に応じて1.52〜1.98倍に向上しました。12万トークンの入力では、毎秒25.81トークンから51.12トークンに上がり、エンドツーエンドの遅延の中央値は527.25秒から382.41秒へ27%短くなっています。また、スライディングウィンドウ注意機構の効果で、下書きモデルを併用した構成のGPUメモリのピークは、入力が1,000から12万トークンに増えても59.42GBから63.50GBの増加にとどまりました。
なお原文は、これらの数値はこのQ2-XSとDFlash2の特定の構成についてのもので、異なる提供条件に一般化すべきではないと明記しています。
「ビット数」から「トークン効率」へ
原文は結びで、精度を下げることはモデルを小さくする以上の意味を持つと述べています。空いたメモリと帯域は、より高性能なモデル、長い文脈と大きなKVキャッシュ、投機的デコーディング、同時処理数の拡大に振り向けられます。そのため最適化の目標は、ビット数単体から「トークン効率」、つまり決まった計算資源とメモリの中でシステムが届けられる有用な知能の量へと移るとしています。
また、低ビット推論は開発者のデータやツールの近くでより多くの作業をこなす余地を生む一方、より高い能力が必要な作業にはクラウド規模のモデルも引き続き使えるとし、ローカルとクラウドを補い合う使い方を想定しています。次の目標として、同じデバイス資源の中で、より速く応答し、より長いコーディング作業を続けられるローカルのコーディングエージェントを挙げています。
本稿としては、この記事の価値は「どの数字を達成したか」以上に、量子化、投機的デコーディング、KVキャッシュ管理を1台のメモリ予算の中でどう組み合わせたかを具体的に示した点にあると思います。一方で、前提となる128GBの統合メモリを備えたPCは誰もが手にできるものではありません。中小規模のチームにとっては、どの作業をローカルに任せ、どこからクラウドを使うかという線引きを考える材料として読むのが現実的だと考えられます。
まとめ
MicrosoftはMAI-Code-1.1-Flashを、混合精度の量子化、投機的デコーディング、下書きモデルのKVキャッシュ制限を組み合わせて手元のPCで動かしました。ビット数ではなくトークン効率を目標にする考え方が要点です。投機的デコーディングの仕組みは、Gemma 4の高速化を解説した記事もあわせてご覧ください。