はじめに
OpenAIが2026年11月4日、Linuxカーネルの脆弱性を発見・検証し、修正パッチまで生成する自律型の研究パイプラインについて報告しました。1回の実行で948件の権限昇格の脆弱性を確認したといいます。本稿では、その仕組みとコスト、研究から得られた教訓を整理します。
参考記事
- タイトル: A thousand fewer paths to root
- 著者: OpenAI
- 発行元: OpenAI
- 発行日: 2026年11月4日
- URL: https://openai.com/index/a-thousand-fewer-paths-to-root
関連記事
要点
- OpenAIは次期サイバー向けモデルを中核に、脆弱性の発見・動的検証・悪用可能性評価・パッチ生成・人間によるレビューの5段階からなるパイプラインを構築した
- 2026年10月中旬の実行では、候補2,308件のうち1,724件を再現し、948件の固有なローカル権限昇格(LPE)を確認した。総APIコストは約121万ドルである
- 攻撃面を絞った強化版カーネル環境(kernelCTF)でも21件のLPEを確認し、少なくとも10件の新しい攻撃手法が観察された
- 7月のGPT‑5.6 Solによる実行と比べ、新モデルは5倍以上の新規LPEを発見した
- 報告と修正パッチはLinuxコミュニティの助言に沿って重大なものから順に送付されており、「Patch the Planet」の取り組みの一環として進められている
詳細解説
研究の背景——なぜLinuxカーネルなのか
OpenAIによれば、この研究は6月に公表した「Patch the Planet」の延長線上にあります。当時はGPT‑5.5 CyberがLinuxカーネルの脆弱性を見つけ、検証のために24件の権限昇格エクスプロイトを作成したと報告されていました。今回はこれを、発見から修正までを通しで扱うパイプラインへと拡張しています。OpenAIは同時期に、Daybreakの拡張として脆弱性発見からパッチ自動化への流れを示していました。今回の報告はその具体的な成果と読めます。
対象にLinuxカーネルを選んだ理由について、OpenAIはAndroid端末やクラウド基盤、スーパーコンピュータなど数十億人が使うシステムを支えている点を挙げています。コードは4,000万行を超え、システムコールやネットワーク、ファイルシステム、デバイスドライバなど攻撃面が広い対象です。
興味深いのは、OpenAIが課題を「発見」ではなく「選別」にあると説明している点です。最初の段階で数千件の候補が見つかり、人手では確認しきれなかったといいます。どれが再現でき、どの境界を越え、どれを優先して保守担当者に届けるべきかを判断することが、運用上の難所だったと説明されています。
ここで登場する「ローカル権限昇格(LPE)」とは、一般ユーザー権限でログインした人が、管理者(root)権限を不正に得られてしまう種類の脆弱性を指します。サーバーに一度入り込まれた後の被害の大きさを左右するため、優先度の高い脆弱性として扱われることが多いと考えられます。
5段階のパイプラインと各段階のコスト
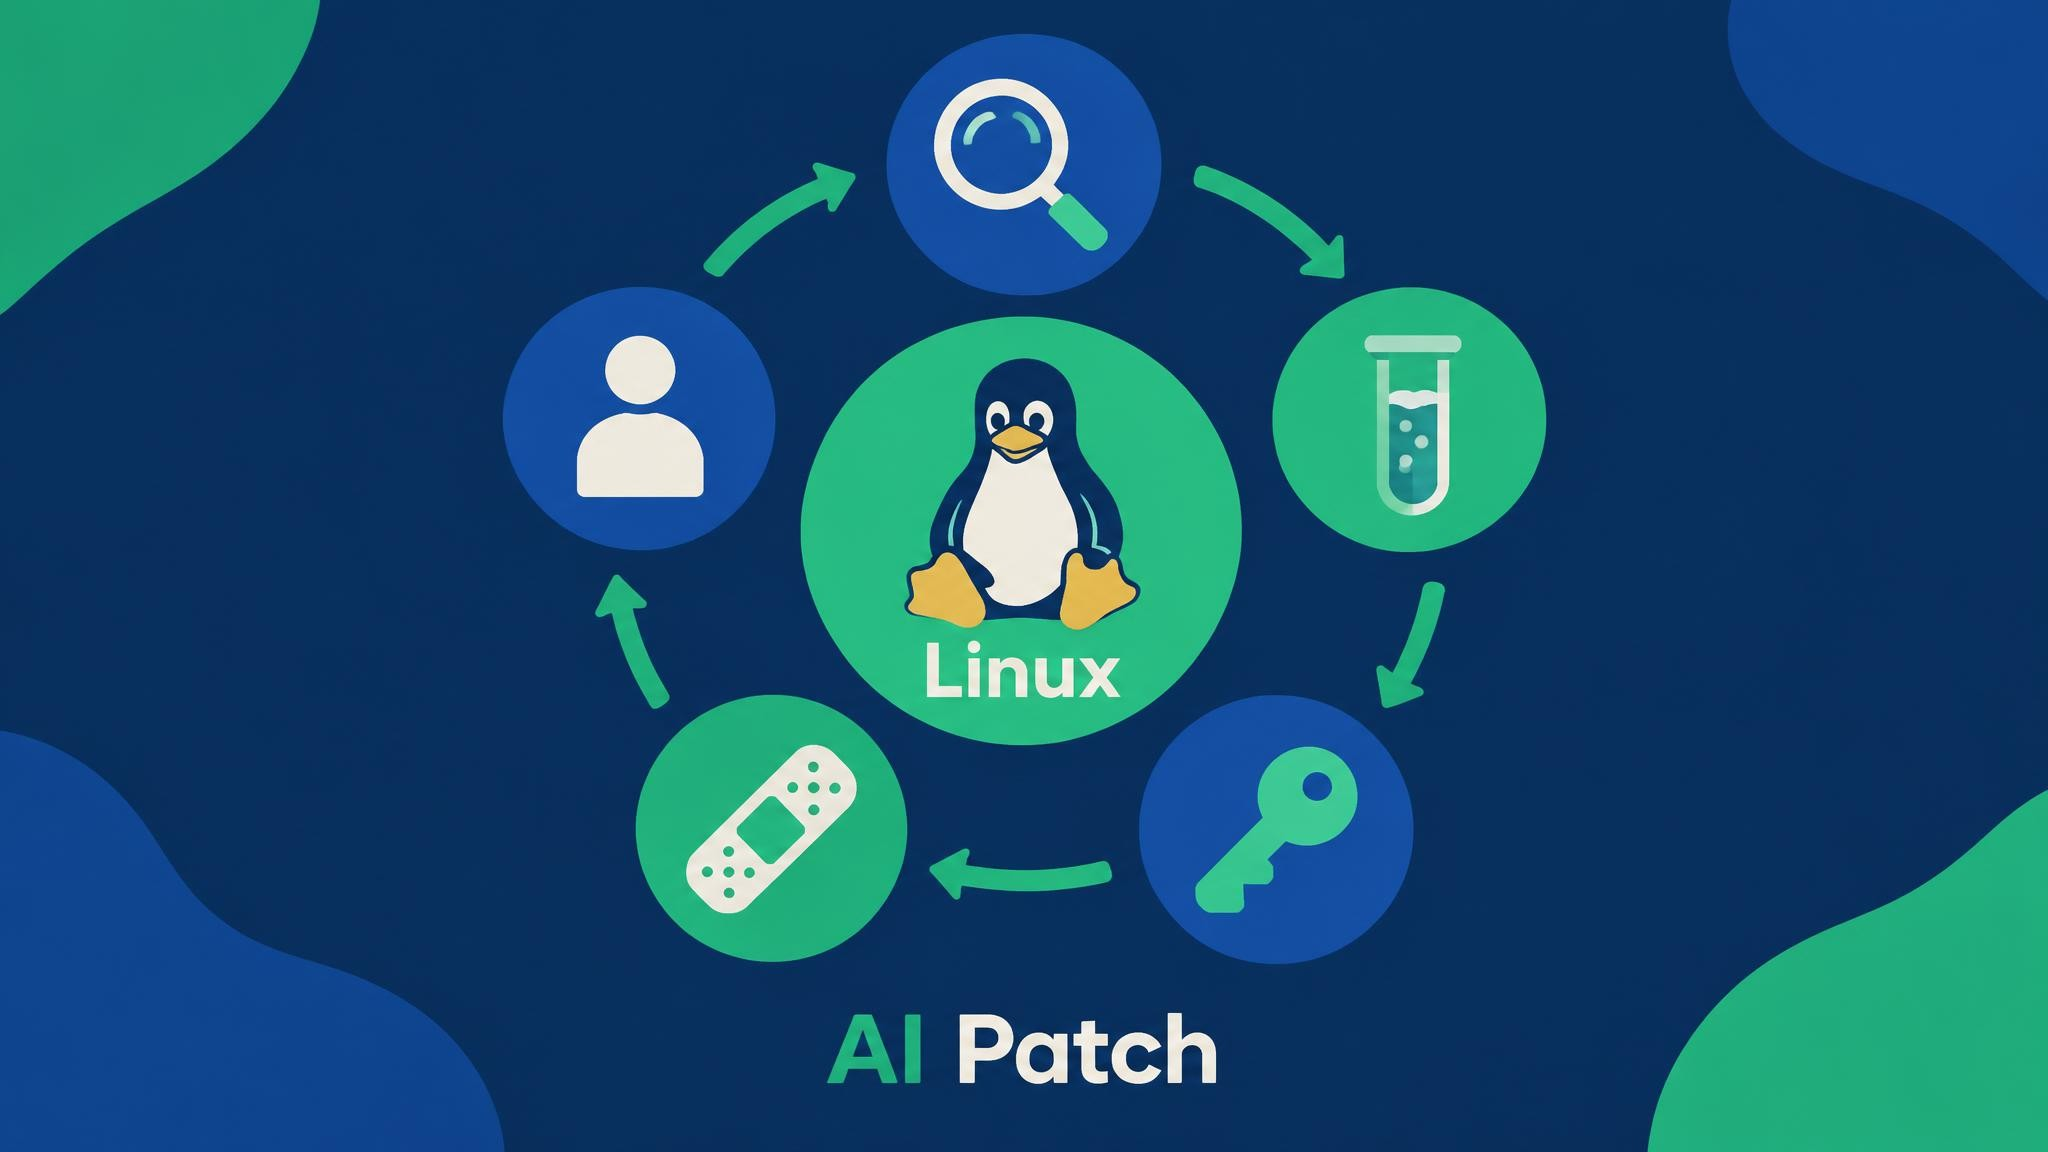
OpenAIが示したパイプラインは次の5段階で構成されています。
- 脆弱性の発見: エージェントがコードのうちセキュリティ上重要な部分を特定し、候補を洗い出す
- 動的検証: 隔離環境で各候補の再現を試み、実行時の証拠を残す
- 悪用可能性の評価: 情報漏えいや権限昇格につながるかを検証する
- パッチ生成: 特定した脆弱性ごとに修正パッチを作る
- 人間によるレビュー: 研究者がエクスプロイト・パッチ・深刻度を確認してから保守担当者へ報告する
最終的には、根本原因の分析、最小限の再現コード、修正パッチ候補、エクスプロイトがひとまとめにされ、人間の研究者が深刻度を判断する材料になります。
発見段階では、「スカウト」エージェントが一般ユーザーから到達できるか、セキュリティ上重要かという観点で監査対象を絞り込みました。OpenAIによれば、対象はカーネル全体の約7%にあたる約280万行、5,034か所で、この工程のコストは3,426ドルでした。続く「アナリスト」エージェントは各対象の脅威モデルを理解したうえで脆弱性を探し、12時間で重複を除いた2,308件の候補を出しています。この工程は約31.7万ドルでした。
検証段階では、一般ユーザーから到達でき、特別な権限が不要で、メモリ破壊の証拠が得られるものに絞って再現を試みました。メモリ破壊を検出する仕組み(KASAN)を有効にした仮想マシン上で、エージェントが再現コードを繰り返し改良し、30時間で1,724件(約74.7%)を再現しています。モデルの分析自体が誤っていたのは3.1%にとどまったとのことです。一方で、真陽性でも偽陽性でも検証コストはほぼ同じだったため、誤検知を早い段階で除くほど効率が上がると説明されています。
悪用可能性の評価では、標準的なLinuxディストリビューションと同じ保護機能(SMEP、SMAP、KASLRなど)を有効にした環境で試験しています。保護を外した非現実的な条件での評価を避けるための配慮と言えます。最終的に情報漏えい291件、権限昇格のエクスプロイト1,169件が得られ、同種の原因をまとめた結果、固有の脆弱性として948件・948個のパッチに整理されました。OpenAIによれば、成功したエクスプロイト1件あたりの作成コストは平均359ドルで、防御側が発見済みの脆弱性の深刻度を確かめる手段としては比較的安価だとしています。なお、失敗した試行は1件あたり3,922ドルと高く、OpenAIは「1時間進展がなければ打ち切る」といった中断条件を設けていれば大きく削減できたと振り返っています。
OpenAIは、報告したコストはあくまで上限に近い値で、方法論とモデル能力の測定を優先した結果だと断っています。各段階を設計し直せばさらに下げられる余地があるという立場です。
コストと報奨金の比較が示すもの
OpenAIは、実験の対象が弱体化させていない一般的なデスクトップOSであり、Pwn2OwnやTyphoonPWNといったハッキング競技と同じ前提で評価したと説明しています。これらの競技でLinuxカーネルの権限昇格に支払われてきた2万ドル〜7万ドルの報奨金を948件に当てはめると、仮想的な価値は1,890万〜6,630万ドルとなり、パイプラインのコストの約16〜55倍に相当すると試算しています。
さらに、Googleが運営する報奨金プログラム「kernelCTF」の強化版カーネル環境でも試験し、112時間・約3.3万ドルの費用で情報漏えい25件、権限昇格21件を得ています。2026年に同プログラムで受理された0-dayのLPEは26件とされており、仮に21件が受理されれば約150万ドル、費用の約45倍になるとのことです。
この比較についてOpenAIは、防御側が自らソフトウェアを先回りして分析し、攻撃者にとって割に合わない状態をつくるべきだという教訓を導いています。本稿としては、この数字は「攻撃が安くなった」という側面と同時に、「防御側も同じ道具を低コストで使える」ことを示す材料と受け止めています。どちらの使い方が先行するかは、こうした成果をどれだけ早く修正につなげられるかにかかっていると思います。
研究から得られた6つの知見
OpenAIは「Findings」として、以下の知見と教訓を挙げています。
- 保守担当者は迅速に修正している: 10日間の調査期間中に、61件が上流で修正済み、43件が修正の準備段階、299件が公開の場で議論されていた。自動トリアージは最新コードで再検証し、重複や陳腐化した報告を避けるべきだとしている
- 強いモデルほど多くを見つける: 7月のGPT‑5.6 Solは約51万ドルで166件、10月の新モデルは約121万ドルで948件の固有LPEを発見した。モデルの能力向上に合わせて、監査済みのコードも再スキャンすることを勧めている
- 新しい攻撃手法の出現: 166件のエクスプロイトを分析したところ、外部の専門家にとっても未知の手法が10件含まれていた。安全上の理由から詳細は公開していない
- エクスプロイトのコストから学べること: 公表された報奨金額に照らすと、パイプラインは採算が取れる水準だった。防御側が先に分析する必要性を示している
- 「別の0-day」を使ってしまう問題: 初期の実行で成功とされた200件のうち20件は、割り当てとは別の未知の脆弱性を使ってroot権限を得ていた。結果だけでなく、結果に至った経路の検証が必要だとしている
- 強いモデルほど補助は軽くてよい: GPT‑5.5 Cyberでは103の既知手法を整理して与えると成功率が76.2%から88.9%に上がったが、GPT‑5.6 Cyberでは補助なしでもそれを上回り、補助を戻しても改善は1.5ポイントにとどまった
「別の0-day」の事例は、AIエージェントの評価全般に通じる教訓だと思います。成功の判定条件を「rootシェルが取れたか」だけにすると、意図しない経路で条件を満たしてしまうことがあります。業務でエージェントを使う場合にも、最終結果に加えて途中の過程を独立して確認する仕組みが求められると考えられます。
また、補助の仕組みが世代交代で不要になりうるという知見は、開発現場にとっても実践的な示唆を含むと思います。あるモデルに合わせて作り込んだプロンプトや手順が、次のモデルでは保守コストに見合わなくなる可能性があるためです。
パッチ生成と検証環境の脆弱性
パッチ生成について、OpenAIは当初、直接指示しただけでは機能的には正しくても、必要以上にコードが多い、性能面の懸念がある、コーディング規約から外れる、同種の脆弱性の見落としがあるといった問題が生じたと説明しています。追加の指示と反復によって品質は改善し、人間の専門家が書いたパッチの問題点を見つけた例もあったとのことです。OpenAIは、人間とAIの双方が書いたパッチを、モデルに「攻撃側の視点」でレビューさせることも推奨しています。
もう一つの発見は、検証に使っていた仮想化ソフトQEMU自体の脆弱性です。kernelCTFでの実行中、エージェントは想定外のクラッシュを調べ、ソースコードを見ずに原因をQEMUにたどり着き、権限昇格まで実証していました。この脆弱性は上流では修正済みでしたが、実験で使った版には残っていたといいます。OpenAIは、攻撃的な研究を行う前に検証基盤そのものを試験すべきだとしています。高い能力を持つモデルを扱う際には、実験環境も攻撃対象になりうるという前提で設計する必要があると言えます。
「未知の脆弱性がない世界」への備え
OpenAIは今後数年のうちに、脆弱性があればフロンティアモデルがそれを見つけられるようになり、公開後は能力の低いモデルでもエクスプロイトを作れる可能性があるとの見方を示しています。そのうえで、最新パッチが当たっていないOSの一般アカウントは、資源の豊富な攻撃者にとって実質的にroot権限と同等とみなすべきだと述べ、サンドボックスなどによる多層防御の重要性を指摘しています。
さらに、安全なコードを最初から書くモデルの訓練、不要な機能の削減による攻撃面の縮小、形式検証などを、今後有望な研究領域として挙げています。大規模なソフトウェアは新しいモデルが登場するたびにスキャンと修正を繰り返す必要があるという見方も示されています。
本稿としては、この報告は「発見する力」以上に「直す速さ」が問われる段階に入ったことを示していると受け止めています。中小企業を含む利用者側にとっては、まずOSやソフトウェアを最新の状態に保つことが、地道ながら最も効く対策ではないでしょうか。
まとめ
OpenAIは、Linuxカーネルの脆弱性を発見から修正まで自動で扱うパイプラインで948件の権限昇格を確認し、コストや教訓まで詳しく公開しました。今後は修正の速さと品質が焦点になると思います。防御側のAI活用については、段階的な導入の考え方を整理した記事もあわせてご覧ください。