はじめに
Googleリサーチが2026年3月24日、大規模言語モデル(LLM)とベクトル検索エンジン向けの量子化アルゴリズム群「TurboQuant」を発表しました。本稿では、TurboQuantの仕組みと性能評価の結果を中心に、KVキャッシュ圧縮とベクトル検索への応用可能性を解説します。
参考記事
- タイトル: TurboQuant: Redefining AI efficiency with extreme compression
- 著者: Amir Zandieh(Googleリサーチ、研究科学者)、Vahab Mirrokni(Googleリサーチ、VP・Google Fellow)
- 発行元: Google Research Blog
- 発行日: 2026年3月24日
- URL: https://research.google/blog/turboquant-redefining-ai-efficiency-with-extreme-compression/
要点
- TurboQuantは、KVキャッシュ圧縮とベクトル検索の両方に対応した量子化アルゴリズムであり、追加の学習・ファインチューニングなしに精度を維持したまま大幅な圧縮を実現する
- PolarQuant(高品質圧縮)とQJL(ゼロオーバーヘッドの1ビット誤差補正)の2段階で構成され、従来の量子化手法が抱えていたメモリオーバーヘッドの問題を解消する
- GemmaおよびMistralを用いたLongBenchなど複数の標準ベンチマークで評価され、KVキャッシュを3ビットまで圧縮しても精度の劣化がなく、メモリを少なくとも6分の1に削減できる
- Googleリサーチによれば、H100 GPU上で4ビット構成を使用した場合、32ビット未量子化比で最大8倍の処理速度向上を達成した
- TurboQuantとPolarQuantはそれぞれICLR 2026・AISTATS 2026に採録されており、理論的な下限値に近い効率を達成することが数学的に証明されている
詳細解説
ベクトル量子化とKVキャッシュの課題
LLMの処理効率化において、「KVキャッシュ」は欠かせない仕組みです。これは、モデルが推論時に頻繁に参照する中間計算結果(キー・バリューのペア)をメモリ上に保持することで、同じ計算の繰り返しを回避する高速参照テーブルです。長文コンテキストを扱うモデルほどKVキャッシュのサイズが肥大化し、メモリのボトルネックが顕著になる傾向があります。
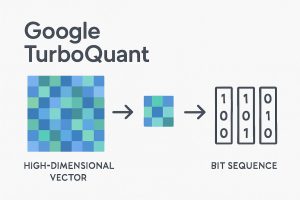
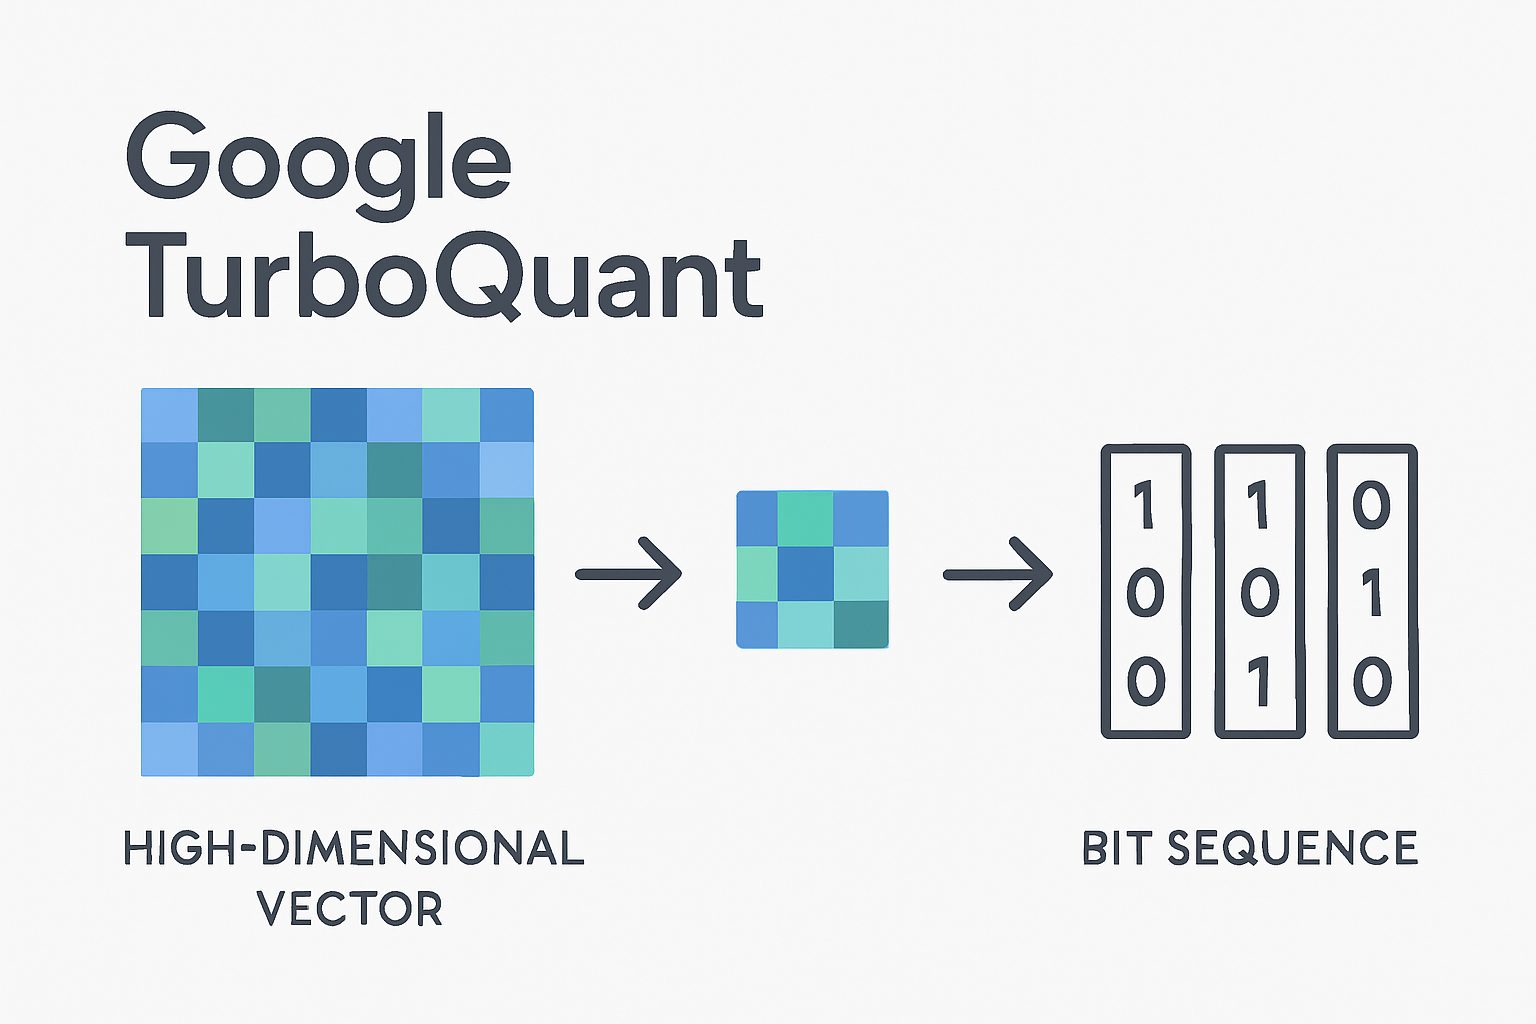
このボトルネックへの対処として、ベクトル量子化——高次元の数値ベクトルを少ないビット数で近似的に表現するデータ圧縮技術——が有効な手段として知られています。しかし、Googleリサーチによれば、従来の量子化手法のほとんどは「量子化定数」と呼ばれる補正値を別途フル精度で保存する必要があり、数値1個あたり1〜2ビットのメモリオーバーヘッドが生じます。このコストが圧縮の効果を部分的に相殺してしまうことが、長年の課題とされてきました。
TurboQuantの2段階アルゴリズム
TurboQuantはこの課題に対し、PolarQuantとQJLという2つのサブアルゴリズムを組み合わせることで対応しています。
第1段階のPolarQuantは、ベクトルデータをデカルト座標(X・Y・Z軸方向の距離)から極座標(距離と角度の組み合わせ)に変換します。「東に3ブロック、北に4ブロック進む」という表現を「北東方向37度の角度で5ブロック進む」と言い換えるイメージです。極座標変換後の角度の分布は既知の集中した形状に従うため、従来の量子化で必要だったデータ正規化のステップを省略できます。その結果、追加のメモリオーバーヘッドなしに高品質な圧縮を実現します。この第1段階に圧縮能力の大部分(ビット数の大半)を集中させる構造になっています。
第2段階のQJL(Quantized Johnson-Lindenstrauss)は、第1段階で生じたわずかな残差誤差を補正します。ジョンソン・リンデンシュトラウス変換と呼ばれる数学的手法を用いて高次元データの本質的な距離関係を保ちながら次元を圧縮し、各ベクトル成分を符号ビット(+1または-1)だけに変換します。この操作は1ビットしか消費せず、追加のメモリオーバーヘッドもゼロです。高精度のクエリと低精度の圧縮データを組み合わせる特殊な推定量を用いることで、アテンションスコア——モデルがどの入力部分に注目すべきかを決定する計算——の精度を維持します。
この2段階の分業構造により、TurboQuantは従来手法が避けられなかったオーバーヘッドをゼロに抑えながら、高い圧縮率と精度を両立しています。
評価実験と主な結果
Googleリサーチは、GemmaとMistralという2つのオープンソースLLMを使い、LongBench・Needle In A Haystack・ZeroSCROLLS・RULER・L-Evalという標準的な長文コンテキストベンチマーク群でTurboQuantを評価しました。これらは質問応答・コード生成・要約・長文からの情報抽出など多様なタスクを含む、LLMの総合的な性能を測る指標です。
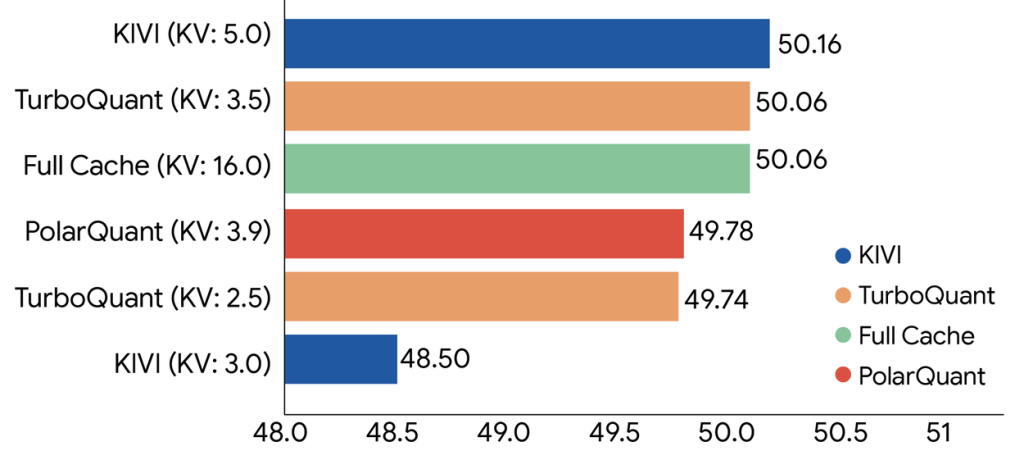
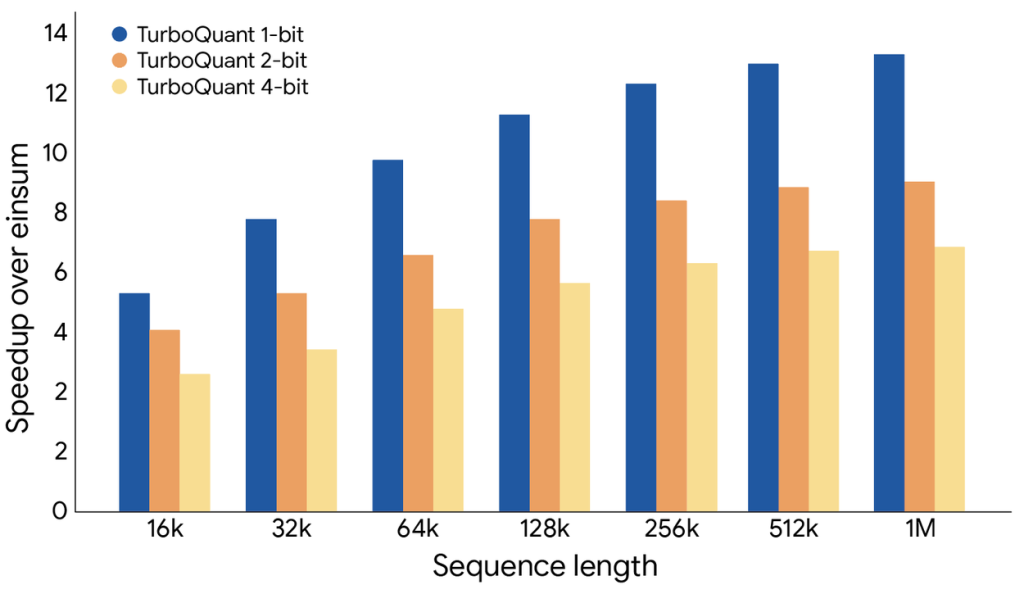
評価の結果、TurboQuantはKVキャッシュを3ビットまで量子化しても精度の劣化がなく、KVメモリフットプリントを少なくとも6分の1に削減できることが示されました。また、H100 GPU上での4ビット構成では、32ビット未量子化の場合と比べて注意スコア計算で最大8倍の処理速度向上を達成しています。学習やファインチューニングを必要とせず、実装時の追加コストも小さい点も報告されています。
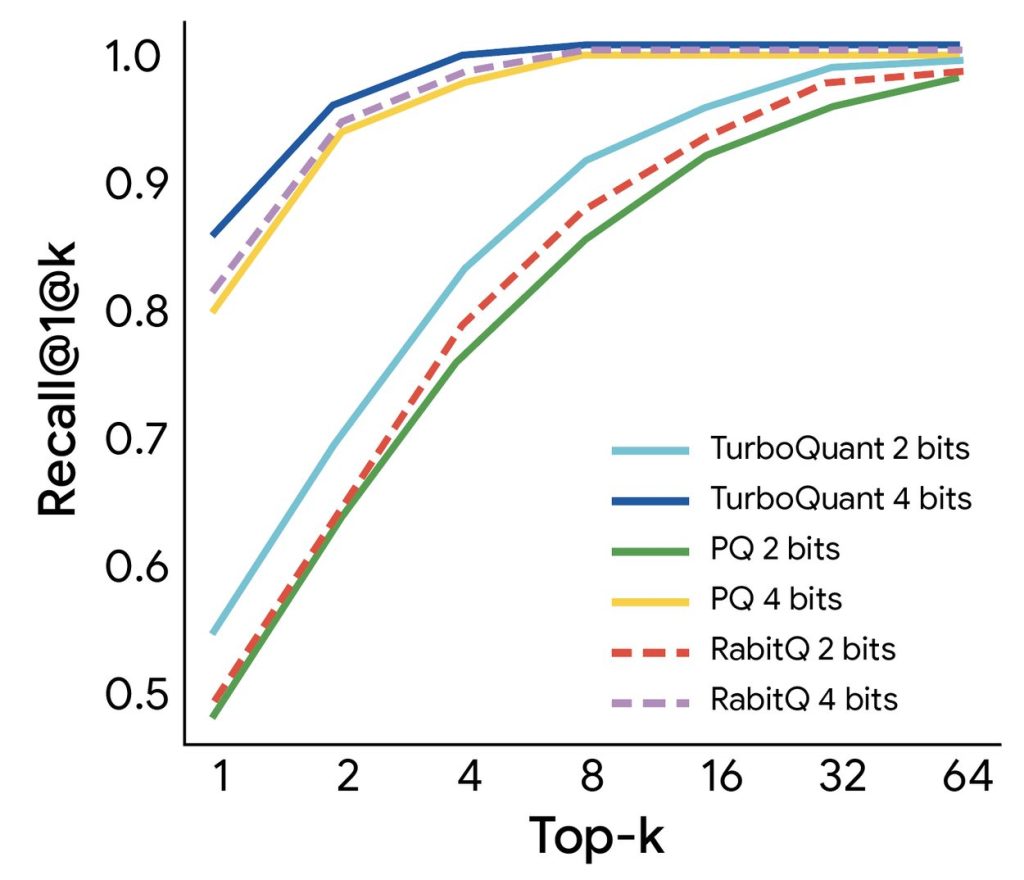
さらに、高次元ベクトル検索の評価では、大規模なコードブックとデータセット固有のチューニングを必要とする既存手法(PQおよびRabbiQ)と比較しても、GloVeデータセット(d=200)上でより高い1@k再現率を達成しました。1@k再現率とは、アルゴリズムが上位k件の近似結果の中に真の最近傍を含む頻度を示す指標です。事前のデータ依存処理なしにこの水準を達成する点は、実運用での適用しやすさという観点からも注目に値すると考えられます。
ベクトル検索と今後の展望
Googleリサーチは、TurboQuantの応用先として長文コンテキストLLM(Geminiなど)のKVキャッシュ効率化に加え、セマンティック検索の高速化を挙げています。現代の検索エンジンはキーワードマッチングを超え、文章の意味や文脈の類似性に基づいて結果を返す「ベクトル検索」へと進化しており、数十億規模のベクトルデータベースを効率的に扱う圧縮技術が不可欠になっています。
TurboQuant・QJL・PolarQuantの3手法は、単なる実装上の工夫にとどまらず、理論的な下限値に近い効率を達成することが数学的に証明されたアルゴリズムです。TurboQuantはICLR 2026、PolarQuantはAISTATS 2026への採録が確定しており、学術的な信頼性も担保されています。LLMの長文対応や大規模検索インフラの効率化を検討する際、参照する価値のある成果と言えます。
まとめ
GoogleリサーチのTurboQuantは、PolarQuantとQJLの2段階設計によってKVキャッシュを3ビットまで圧縮しながら精度を維持し、H100上で最大8倍の処理速度向上を実現します。学習不要かつ実装コストが低い点も特徴であり、LLMの長文処理とセマンティック検索の効率化に向けた実用的な選択肢として、今後の応用展開が注目されます。