はじめに
MetaのAI研究部門が2026年3月27日、画像・動画向けセグメンテーション基盤モデル「Segment Anything Model 3(SAM 3)」と、その更新版「SAM 3.1」を公開しました。本稿では、SAM 3の新機能と性能、SAM 3.1で導入された高速化技術、そして実際の活用事例について解説します。
参考記事
メイン記事:
- タイトル: SAM 3.1: Faster and More Accessible Real-Time Video Detection and Tracking With Multiplexing and Global Reasoning
- 著者: Meta AI
- 発行元: Meta AI Blog
- 発行日: 2026年3月27日
- URL: https://ai.meta.com/blog/segment-anything-model-3/
関連情報:
- タイトル: SAM 3: Segment Anything with Concepts(GitHub README)
- 発行元: Meta / facebookresearch
- 発行日: 2026年3月27日
- URL: https://github.com/facebookresearch/sam3
- タイトル: SAM 3.1 Model Checkpoint
- 発行元: Hugging Face / facebook
- 発行日: 2026年3月27日
- URL: https://huggingface.co/facebook/sam3.1
要点
- SAM 3は、テキスト・サンプル画像・視覚プロンプトを使って画像と動画のオブジェクトを検出・セグメント・追跡できる統合基盤モデルである
- SAM 3.1はオブジェクトマルチプレクシングを導入し、1回の推論パスで最大16オブジェクトを同時処理することで動画処理速度を16fpsから32fpsに向上させた
- 独自ベンチマークSA-Coでは270K以上のユニークなコンセプトを扱い、Gemini 2.5 Proなどを上回る性能を記録した
- Segment Anything Playgroundを新たに公開し、技術的な専門知識なしでモデルを試せる環境を提供している
- Facebook Marketplaceの「View in Room」機能や野生動物保護データセット構築など、実用応用が始まっている
詳細解説
SAM 3とは何か
SAM 3(Segment Anything Model 3)は、Metaが開発した画像・動画向けの統合基盤モデルです。Metaによれば、テキストプロンプト(短い名詞句)、サンプル画像(エグザンプラー)、点・ボックス・マスクといった視覚プロンプトを組み合わせて、画像や動画内のあらゆるオブジェクトを検出・セグメント・追跡できます。
従来のセグメンテーションモデルは固定されたラベルセットに依存しており、「縞模様の赤い傘」のように細かい概念を扱うことが困難でした。SAM 3はこの制約を克服し、オープン語彙のコンセプトを柔軟に認識できるプロンプタブルコンセプトセグメンテーション機能を実装しています。GitHubのドキュメントによれば、モデルのパラメータ数は848Mで、DETRベースの検出器とSAM 2から継承したトラッカーコンポーネントで構成されています。
SAM 3.1:マルチプレクシングによる高速化
Metaが2026年3月27日に公開したSAM 3.1は、SAM 3のドロップイン置き換えとして設計されています。最大の変更点はオブジェクトマルチプレクシングの導入です。
従来のSAM 3では、追跡する各オブジェクトに対して個別の推論パスが必要でした。SAM 3.1では最大16オブジェクトを1回の推論パスでまとめて処理できるようになり、冗長な計算とメモリボトルネックが解消されています。Metaによれば、この改善により中程度のオブジェクト数の動画では処理速度が16fps(フレーム毎秒)から32fpsに倍増します。Hugging Faceのリリース情報では、128オブジェクト時には単一H100 GPU上で約7倍の推論速度向上を実現しているとされています。
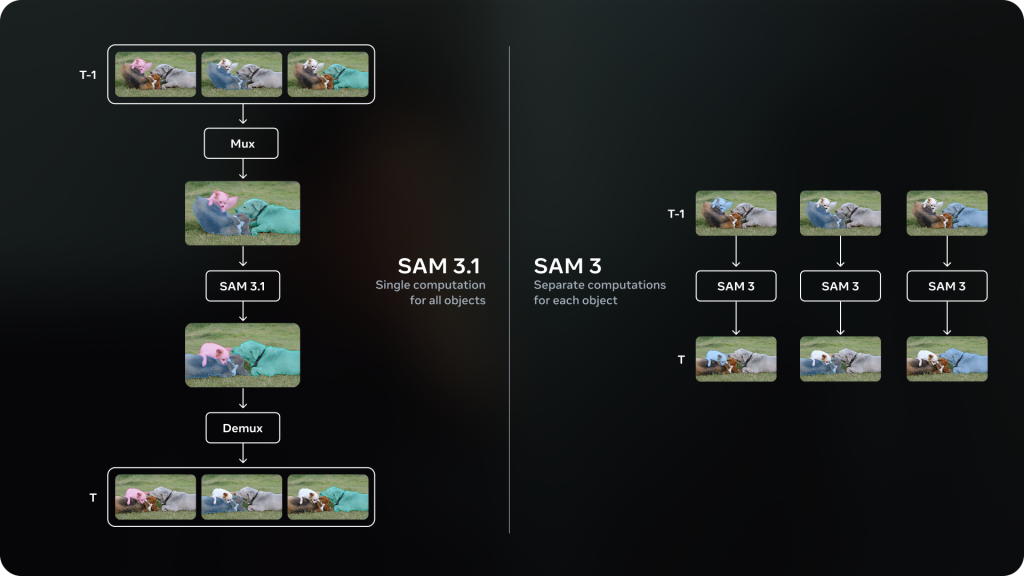
この「グローバル推論」アプローチは複数オブジェクトの情報を共有メモリで一括処理するため、混雑したシーンでの精度向上にも貢献すると考えられます。また、GPUリソースの要件が下がることで、大規模なインフラを持たない開発者にとっても高性能なオブジェクト追跡が現実的な選択肢になると思います。
性能評価:SA-Coベンチマーク
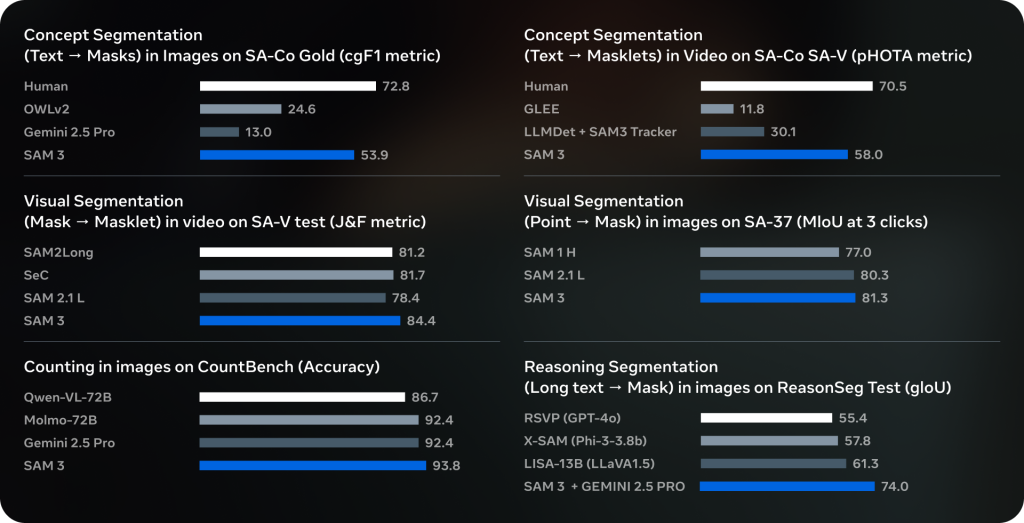
SAM 3の性能評価には、Meta独自のベンチマーク「SA-Co(Segment Anything with Concepts)」が用いられています。このベンチマークには270Kを超えるユニークなコンセプトが含まれており、GitHubのドキュメントによれば既存のベンチマークと比較して50倍以上の語彙数を扱います。
SA-Co Goldサブセットでの画像評価(インスタンスセグメンテーション)では、SAM 3のcgF1スコアが54.1を記録しています。比較対象として掲載されているOWLv2が24.6、Gemini 2.5が13.0であることを踏まえると、大幅な性能差が確認できます。人間のパフォーマンス(72.8)の75〜80%に相当する水準に達しているとされており、この差分がモデルのさらなる改善余地と言えます。
Metaによれば、単一H200 GPU上での推論速度は100以上のオブジェクトを含む1枚の画像で30ミリ秒を実現しています。
データエンジンとアーキテクチャ
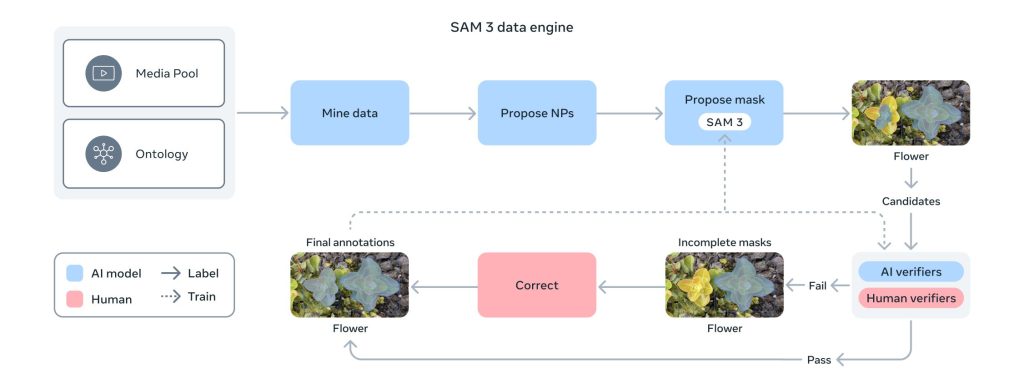
高品質なセグメンテーションデータの収集は、コンピュータビジョン分野における長年の課題です。SAM 3の開発では、SAM 3自身・Llamaベースのキャプションモデル・人間のアノテーターを組み合わせたハイブリッドデータエンジンが採用されています。Metaによれば、このアプローチにより否定プロンプト(画像に存在しない概念)のアノテーションでは人間単体と比較して約5倍、肯定プロンプトでも36%高速化を実現し、400万以上のユニークなコンセプトを含む学習データセットが構築されています。
アーキテクチャ面では、テキストエンコーダと画像エンコーダにMeta Perception Encoder、検出器にDETRベースのモデル、トラッカーにSAM 2のメモリバンク・メモリエンコーダが活用されています。DETRはトランスフォーマーを初めてオブジェクト検出に適用したモデルとして知られており、その後の物体検出研究に大きな影響を与えてきました。
実用応用:クリエイティブツールと科学分野
SAM 3はすでに複数の実用環境に展開されています。Facebook Marketplaceでは「View in Room」機能にSAM 3が組み込まれており、家具や照明器具などの商品を購入前に自宅空間でシミュレーションできるようになっています。また、Instagramの動画編集アプリ「Edits」では、動画内の特定の人物やオブジェクトに動的エフェクトを1タップで適用できる機能が近く追加される予定とされています。
科学分野での活用も始まっています。Conservation X LabsおよびOsa Conservationとの連携で構築された「SA-FARI」データセットには、100種以上の野生動物を含む1万本以上のカメラトラップ動画が収録されており、バウンディングボックスとセグメンテーションマスクでアノテーションされています。海洋研究向けにはFathomNetとの連携で水中映像向けのセグメンテーションデータと評価ベンチマークも提供されています。
開発者向け:利用環境と導入手順
SAM 3.1はSAM 3のGitHubリポジトリのコードとHugging FaceからSAM 3.1チェックポイントを組み合わせて利用できます(Hugging FaceのSAM 3リポジトリへのアクセスリクエストが必要)。動作環境はPython 3.12以上、PyTorch 2.7以上、CUDA 12.6以上に対応したGPUが必要です。
基本的な使用パターンとしては、build_sam3_image_model()でモデルを読み込み、set_text_prompt()でテキストプロンプトを指定するだけで画像のセグメンテーションが実行できます。動画向けにはセッションベースのAPIが用意されており、フレームを指定してプロンプトを追加する形式になっています。SAM 3.1のチェックポイントを使用する際は、最新のリポジトリコードへの更新(git pull)と再インストールが必要な点に注意が必要です。
また、Segment Anything Playgroundでは、コードを書かずにブラウザ上でSAM 3の機能を試すことができます。顔や車のナンバープレートのモザイク処理、スポットライト効果の追加など、実用的なテンプレートが用意されています。
まとめ
MetaのSAM 3は、オープン語彙のテキストプロンプトによるセグメンテーション能力を大幅に向上させた統合基盤モデルです。SAM 3.1ではマルチプレクシングにより動画処理の実用性が高まり、より小さなハードウェアでのリアルタイム追跡が現実的な選択肢になりつつあると思います。コミュニティによるファインチューニングや応用事例の広がりが楽しみなところです。