はじめに
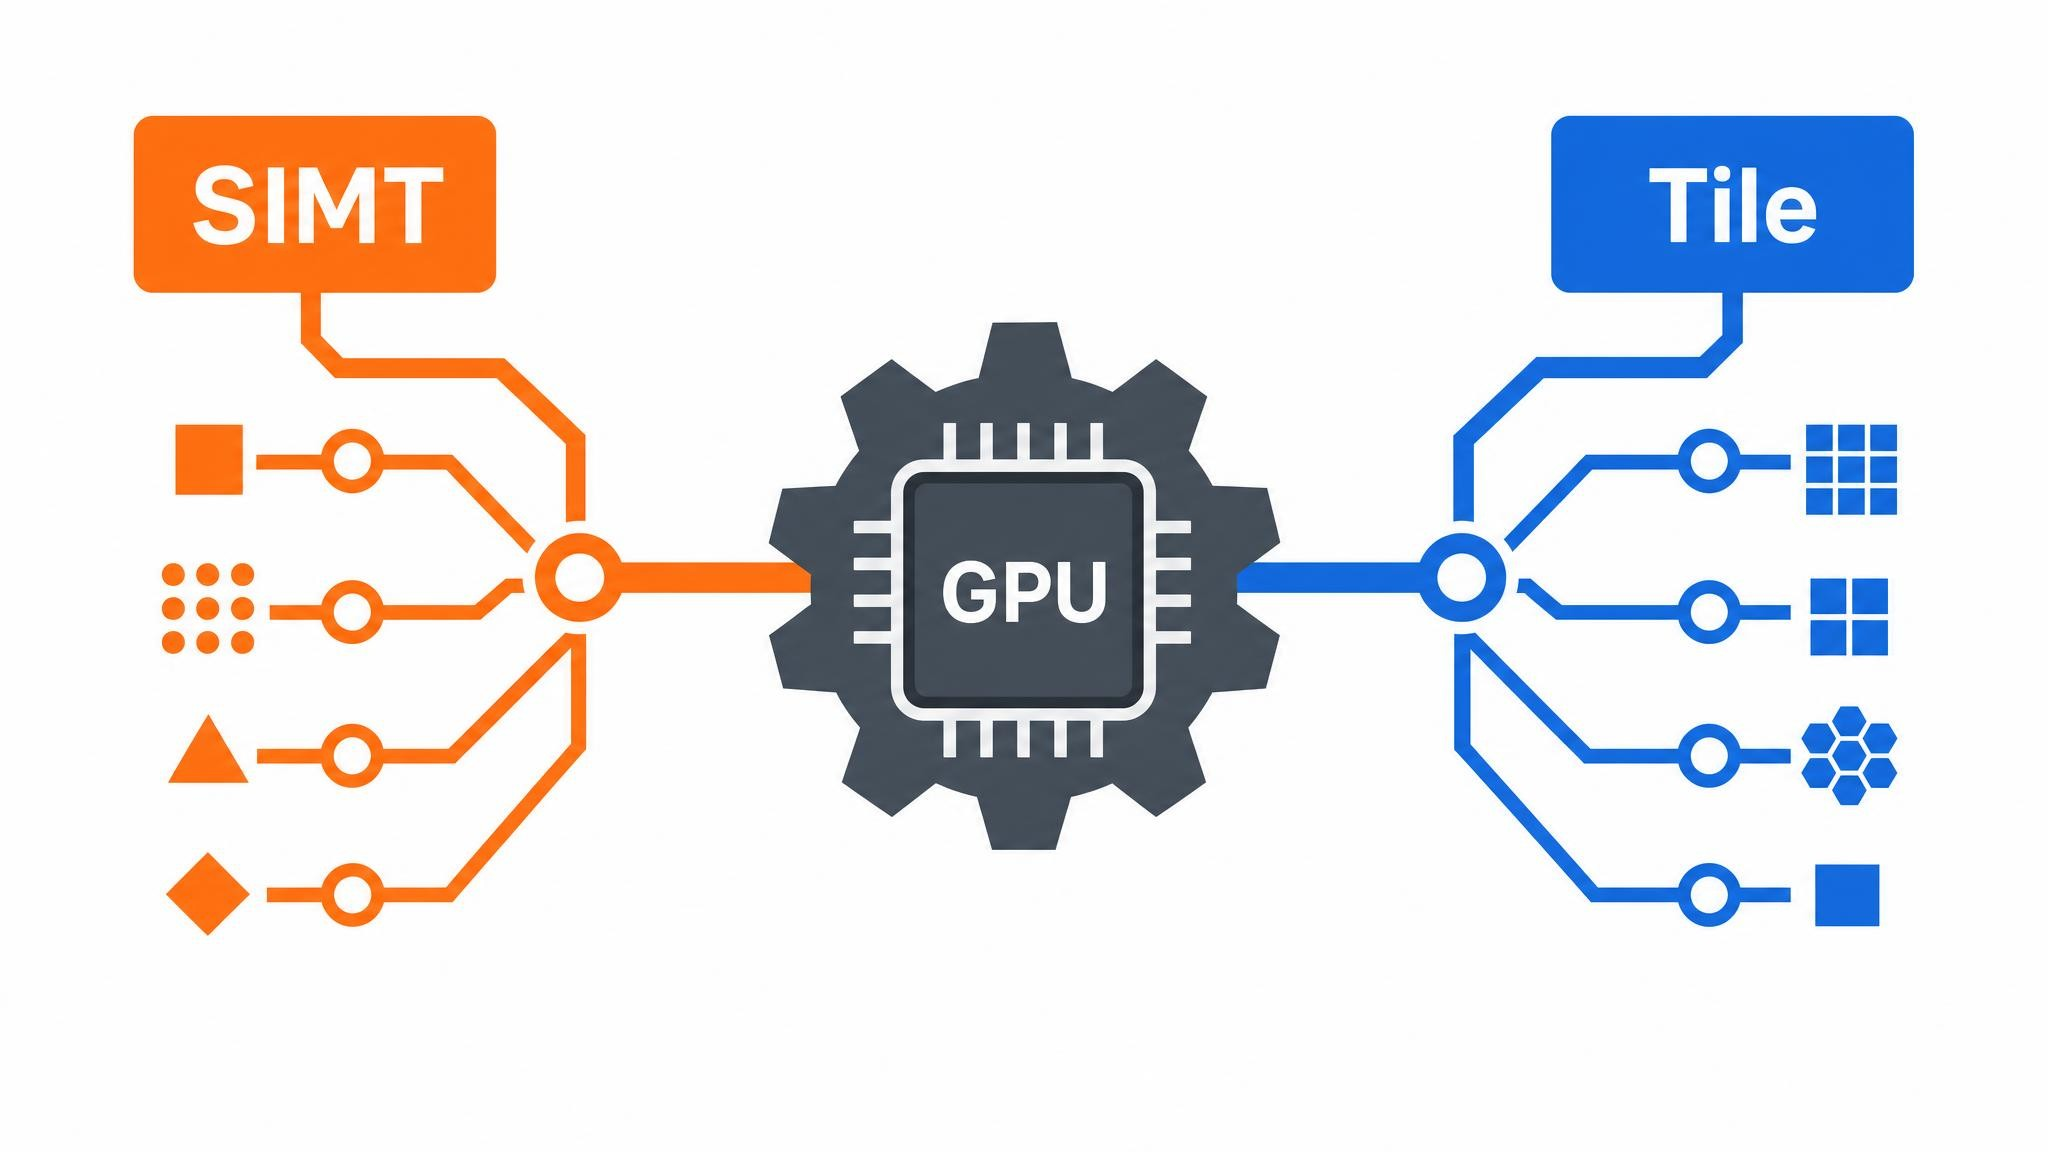
NVIDIAは2026年9月8日、GPUカーネルをRustで直接記述できる新プロジェクト「CUDA Rust」を発表しました。SIMT向けの「cuda-oxide」とTile向けの「cutile-rs」という2つのツールを公開しています。本稿では、両ツールの仕組みと実装方法を解説します。
参考記事
- タイトル: Introducing CUDA Rust: Two Tracks for Writing GPU Kernels
- 著者: Sri Koundinyan、Melih Elibol、Jonathan Bentz
- 発行元: NVIDIA Technical Blog
- 発行日: 2026年9月8日
- URL: https://developer.nvidia.com/blog/introducing-cuda-rust-two-tracks-for-writing-gpu-kernels/
関連記事
要点
- NVIDIAは2026年9月8日、GPUカーネルをRustで書ける「CUDA Rust」を発表した。SIMT向けの「cuda-oxide」とTile向けの「cutile-rs」という2つのトラックで構成される。
- cuda-oxideは独自のrustcコード生成バックエンドを備え、Rustの中間表現(MIR)からPliron IR、LLVM IRを経てPTXへコンパイルする。ピン留めされたnightlyツールチェインとLLVMが必要である。
- cutile-rsはCUDA Tile IRによるJITコンパイルを採用し、安定版Rust 1.89以降とCUDA 13.3で動作する。nightlyツールチェインは不要である。
- 両ツールとも、排他アクセスを型で保証する仕組み(cuda-oxideのDisjointSlice、cutile-rsのテンソルパーティショニング)によってコンパイル時にメモリ安全性を強制する。
- cutile-rsはcrates.ioで公開済みで、HuggingFaceの推論エンジンGroutやmistral.rsで既に使われている。cuda-oxideは初期アルファ版である。
詳細解説
CUDA Rustとは——SIMTとTile、2つのプログラミングモデル
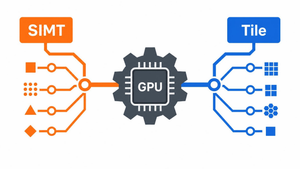
CUDAには従来から2つのプログラミングモデルがあります。ひとつはCUDA C++やnumba-cudaで使われている「SIMT」(Single Instruction, Multiple Threads、単一命令複数スレッド)で、1つのスレッドが何をするかを記述し、それを数千個並行して起動する方式です。もうひとつは、C++やPythonでも利用できる新しいモデル「Tile」で、データの「タイル」1つに対する処理を記述し、実際にどれだけのスレッドを割り当てるかはTile IRコンパイラに委ねます。CUDA Rustは、この2つのモデルをそれぞれRustで書けるようにする取り組みです。
NVIDIAによれば、どちらを選ぶか迷う場合はTileを先に検討するのがよいとされています。コンパイラがアーキテクチャごとのタイル割り当てを決めるため、ソースコードにアーキテクチャ固有の判断が入り込みにくく、メモリやスレッドを自分で管理したい場合や、より細かな制御が必要な場合にSIMTへ切り替える、という位置づけです。
SIMTトラック: cuda-oxideの実装
cuda-oxideは、rustcのコンパイルを横取りする独自のコード生成バックエンドです。#[kernel]が付いた関数を、Rustの中間表現(MIR)、コミュニティ主導のIRフレームワーク「Pliron」、LLVM IR(コンパイラ基盤LLVMの中間表現)の順に経由してPTX(GPU向けの中間アセンブリ言語)へ変換し、それ以外は標準のバックエンドに渡します。
動作にはLinux、Compute Capability 8.0以上のGPU、CUDA Toolkit 12.x以降、clangとlibclangヘッダー、そしてピン留めされたnightlyツールチェインが必要です。cargo oxide doctorでこれらの要件を一括確認できます。以下のコマンドでcargo-oxideをインストールし、プロジェクトを作成して実行します。
# cargo-oxide(ビルドを駆動するCargoサブコマンド)をインストール
cargo +nightly-2026-04-03 install --git https://github.com/NVlabs/cuda-oxide.git cargo-oxide

# プロジェクトを作成し、環境を確認してから実行
cargo oxide new vecadd_demo
cd vecadd_demo
cargo oxide doctor
cargo oxide run
cargo oxide newが生成するテンプレートは、1,024個のfloatを要素ごとに加算する完全なプログラムです。参考記事によれば、初回のcargo oxide runはコード生成バックエンド自体をビルドするため時間がかかりますが、以降はキャッシュが使われます。
use cuda_device::{kernel, launch_bounds, launch_contract, thread, DisjointSlice};
use cuda_host::cuda_module;
use cuda_core::{CudaContext, DeviceBuffer, LaunchConfig1D};

// === デバイス側コード。ここに書いた内容がPTXにコンパイルされる ===

#[cuda_module]

mod kernels {
    use super::*;
    #[kernel] // GPUのエントリーポイント
    #[launch_bounds(256)] // 1ブロックあたりの最大スレッド数
    #[launch_contract(domain = 1, block = (256, 1, 1))] // 1次元・256スレッドブロックで起動
    pub fn vecadd(a: &[f32], b: &[f32], mut c: DisjointSlice<f32>) {
        let idx = thread::index_1d();
        let idx_raw = idx.get();
        if let Some(c_elem) = c.get_mut(idx) {
            *c_elem = a[idx_raw] + b[idx_raw];
        }
    }
}

fn main() -> Result<(), Box<dyn std::error::Error>> {
    // === ホスト側セットアップ ===
    let ctx = CudaContext::new(0)?;
    let stream = ctx.default_stream();

    const N: usize = 1024;

    let a_host: Vec<f32> = (0..N).map(|i| i as f32).collect();
    let b_host: Vec<f32> = (0..N).map(|i| (i * 2) as f32).collect();
    let a_dev = DeviceBuffer::from_host(&stream, &a_host)?;
    let b_dev = DeviceBuffer::from_host(&stream, &b_host)?;
    let mut c_dev = DeviceBuffer::<f32>::zeroed(&stream, N)?;

    // === ロード・準備・起動 ===
    let module = unsafe { kernels::load(&ctx)? };
    let prepared = module.prepare_vecadd(LaunchConfig1D::new((N as u32).div_ceil(256), 256, 0))?;
    module.vecadd(&stream, &prepared, &a_dev, &b_dev, &mut c_dev)?;

    // === 結果の読み出しと検証 ===

    let c_host = c_dev.to_host_vec(&stream)?;
    let errors = (0..N)
        .filter(|&i| (c_host[i] - (a_host[i] + b_host[i])).abs() > 1e-5)
        .count();

    if errors == 0 {
        println!("PASSED: all {} elements correct", N);
    } else {
        eprintln!("FAILED: {} errors", errors);
        std::process::exit(1);
    }
    Ok(())
}
参考記事のサンプルコードをもとにしていますが、実行するとPASSED: all 1024 elements correctと表示されるとのことです。カーネルの引数に注目すると、aとbは全スレッドから読み取れる通常のスライスですが、出力用のcはDisjointSlice<f32>という型です。すべてのスレッドが同じ&mut [f32]を要求するとRustのコンパイラは通常これを許可しませんが、DisjointSliceはその1つの可変参照をスレッドごとの専有領域に分割し、get_mutが返すOptionによって範囲外アクセスも実行前に処理させる仕組みになっています。また#[launch_contract]で宣言した起動条件は、prepare_vecaddの時点で実際の設定やデバイスの上限と照合されるため、起動そのものも検証を経てから行われます。
Tileトラック: cutile-rsの実装
cutile-rsは、スカラーではなくタイル単位で計算を記述するツールです。1つのタイルブロックがカーネル本体を「単一の論理スレッド」として1回実行し、実際に何個のGPUスレッドを割り当てるかはコンパイラが決めます。#[cutile::module]マクロがカーネルの構文木をホスト側バイナリに埋め込み、そのカーネルが初めて呼ばれた時点でCUDA Tile IRを経てJITコンパイル(実行時にコンパイルする方式)されます。
cutile-rsはcrates.io(Rustのパッケージレジストリ)で公開されているため、必要な要件はSIMTトラックより軽く、Compute Capability 8.0以上のGPU、CUDA 13.3、安定版Rust 1.89以降、Linuxのみで、nightlyツールチェインや自前のLLVMは不要です。
# 新規プロジェクトを作成し、cutileクレートを追加

cargo new vecadd_demo

cd vecadd_demo
cargo add cutile

use cutile::prelude::*;

// このモジュールの構文木はホストバイナリに埋め込まれ、カーネルが
// 初めて起動される時点でCUDA Tile IRを経てJITコンパイルされる

#[cutile::module]

mod kernel {
    use cutile::core::*;
    #[cutile::entry()]
    fn add<const B: i32>(
        z: &mut Tensor<f32, { [B] }>,      // 排他的な出力。B個の要素からなるサブテンソル
        x: &Tensor<f32, { [-1] }>,          // 共有される入力。-1は起動時に解決される動的な次元
        y: &Tensor<f32, { [-1] }>,
    ) {
        // このボディは1つのサブテンソルにつき1回、単一の論理スレッドとして実行される
        let tx = load_tile_like(x, z);
        let ty = load_tile_like(y, z);
        z.store(tx + ty); // タイル全体に対する要素ごとの加算
    }
}

fn main() -> Result<(), Error> {
    let device = Device::new(0)?;
    let stream = device.new_stream()?;

    // ここではまだGPUに何も触れていない(遅延評価)
    let x = api::ones::<f32>(&[1024]);
    let y = api::ones::<f32>(&[1024]);

    // partitionは3つの役割を同時に持つ。各タイルに128要素分の専有領域を割り当て、

    // グリッドを1024/128=8タイルに固定し、Bの値を供給する
    let z = api::zeros::<f32>(&[1024]).partition([128]);
    let c: Vec<f32> = kernel::add(z, x, y)
        .first()
        .unpartition()
        .to_host_vec()
        .sync_on(&stream)?; // ここで初めて実際の処理が実行される

    let errors = c.iter().filter(|&&v| (v - 2.0).abs() > 1e-5).count();
    if errors == 0 {
        println!("PASSED: all {} elements correct", c.len());
    } else {
        eprintln!("FAILED: {errors} errors");
    }
    Ok(())
}
参考記事のサンプルコードをもとにしていますが、こちらも実行するとPASSED: all 1024 elements correctと表示されるとのことです。TileトラックにはDisjointSliceに相当する専用の型は登場しません。ホスト側で行う.partition([128])が、各タイルブロックに重複しない128要素分の書き込み領域を割り当てる役割を担っており、これはRustの&mutがもともと保証する排他性を、ホスト側のテンソル操作として表現し直したものと考えられます。出力側のzはpartitionを呼ぶまでタイル幅Bを持たないため、可変な出力は必ずパーティション済みでなければ関数に渡せない、という制約になっています。
コンパイラが検出するメモリ安全性
両トラックとも、共有される入力と、1人の書き手だけが持つ出力という同じ主張をしていますが、それを表現する階層と、専用の型が必要かどうかが異なります。多数のスレッドが同じバッファに同時アクセスする際、書き込みタイミングの順序次第で結果が変わってしまう競合状態は、テストでは再現しにくく、本番環境で初めて表面化しやすい種類のバグです。
SIMTトラックで、出力バッファを入力としても渡そうとすると、実際に競合が起きるかどうかに関わらずコンパイルが失敗します。
module.vecadd(&stream, &prepared, &c_dev, &b_dev, &mut c_dev)?;参考記事によれば、これはerror[E0502]: cannot borrow ‘c_dev’ as mutable because it is also borrowed as immutableというエラーになるとのことです。Tile側でも同種のエイリアシングは同様にコンパイルが通りません。
let z = api::zeros::<f32>(&[1024]);

kernel::add(z.partition([128]), z, y)
こちらはerror[E0382]: use of moved value: ‘z’として検出されます。cuda-oxideは起動呼び出しごとにチェックする一方、cutile-rsの所有権はテンソルが起動境界を越えても追跡され続けるため、後者の方がより強い制約になっていると本稿としては見ています。なおTileトラックにはスレッドという概念自体が存在しないため、共有メモリの扱いに関する不安全な操作は原則発生しませんが、その分SIMTトラックが持つような細かな制御は手放すことになります。共有メモリはSIMTカーネルの性能を左右する要素であるため、そこを安全に扱えるようにする作業は現在も進められているとのことです。
両プロジェクトの現状と今後
cuda-oxideは初期アルファ版で、cutile-rsはより開発が進んでおり、crates.ioで公開済みのうえHuggingFaceの推論エンジン「Grout」やmistral.rsといった外部プロジェクトでも既に使われています。いずれもカバレッジは未完成でAPIは今後変わる可能性があり、SIMTトラックについては、ピン留めされたnightlyツールチェインを必要としない形にすることが今後の課題として挙げられています。
NVIDIAは、CUDA Rust・CUDA C++・CUDA Python間の相互運用にも対応する計画を明らかにしています。どのフロントエンドを選んでも他の言語のエコシステムから閉じ出されないようにする、という位置づけです。またRust向けGPUプログラミングにはRust-GPUやrust-cuda、CubeCLといった既存プロジェクトもあり、NVIDIAはrust-cudaのメンテナーとも協力しながら両プロジェクトを開発しているとのことです。
まとめ
CUDA Rustは、cuda-oxide(SIMT向け)とcutile-rs(Tile向け)の2トラックで、RustによるGPUカーネル記述を可能にする取り組みです。cutile-rsは既に外部の推論エンジンで使われています。NVIDIAの開発者向けツールは、NeMo Guardrailsの実装ガイドでも紹介していますので、あわせてご覧ください。