はじめに
OpenAIが2026年5月5日、スーパーコンピュータのGPU間通信を刷新する新プロトコル「MRC(Multipath Reliable Connection)」を公開しました。AMD・Broadcom・Intel・Microsoft・NVIDIAとの2年間の共同開発成果として、Open Compute Project(OCP)経由でオープン標準化されています。本稿では、その設計思想と実際の運用成果を解説します。
参考記事
- タイトル: Supercomputer networking to accelerate large scale AI training
- 著者: N/A(OpenAI Scalingチーム)
- 発行元: OpenAI
- 発行日: 2026年5月5日
- URL: https://openai.com/index/mrc-supercomputer-networking/
関連記事

要点
- MRC(Multipath Reliable Connection)は、OpenAIがAMD・Broadcom・Intel・Microsoft・NVIDIAと約2年かけて共同開発したGPUネットワークプロトコルである
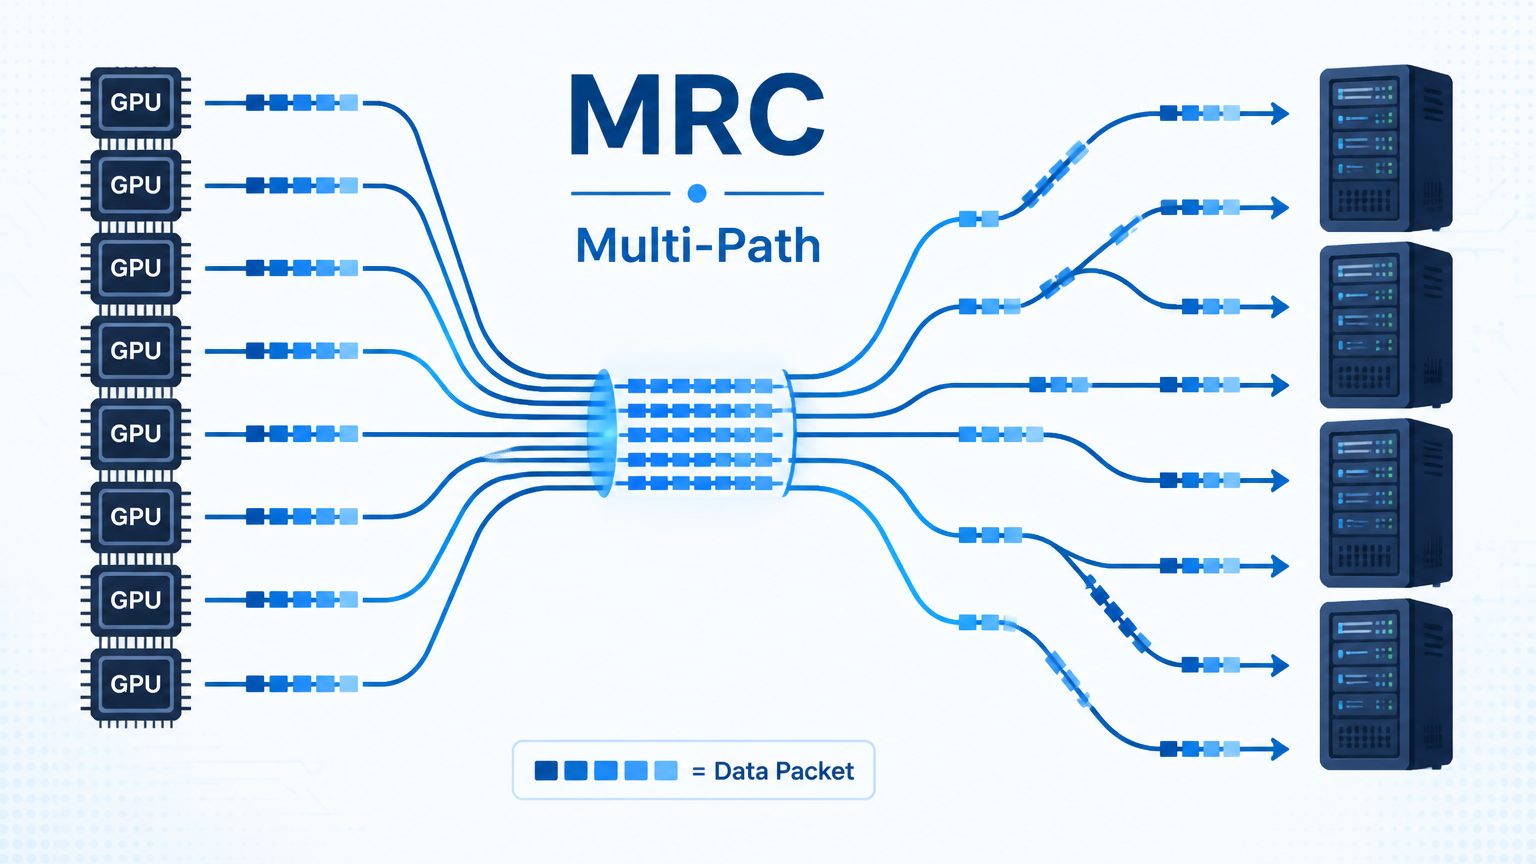
- 単一転送のパケットを数百の経路に同時分散する「パケットスプレイ」方式により、コアネットワークの輻輳をほぼ解消している
- SRv6(IPv6セグメントルーティング)による静的ソースルーティングを採用し、障害発生時にマイクロ秒単位で迂回路へ切り替えられる
- マルチプレーン構成により、10万基超のGPUをスイッチ2層のみで接続でき、従来の3〜4層構成より消費電力・コストを抑えられる
- OpenAIの大規模NVIDIA GB200スーパーコンピュータ群に既に展開済みで、OCP(Open Compute Project)を通じてオープン標準として公開された
詳細解説
なぜGPUネットワークの再設計が必要だったのか
大規模AIモデルの学習では、1ステップあたり数百万件ものデータ転送が発生します。1件でも到着が遅れると、GPUが待機状態に陥り、学習全体の進捗が止まります。リンク障害やスイッチ障害は、クラスタが大規模になるほど頻度が増し、影響も深刻になります。OpenAIはこのメカニズムを「障害増幅器」と表現しており、同期型事前学習(多数のGPUが一体となって1モデルを学習する方式)では特に顕著だとしています。
Stargateプロジェクトの大規模化にともない、既存のネットワーク設計では2つの課題が浮上しました。1つは輻輳(データが特定のリンクに集中すること)の最小化、もう1つは障害発生時にも学習ジョブを継続させる耐障害性の確保です。従来の構成ではスイッチ1台の再起動や1本のリンク障害が学習クラッシュにつながることもあり、オペレーションチームとの慎重な調整が不可欠でした。
マルチプレーン構成とパケットスプレイ
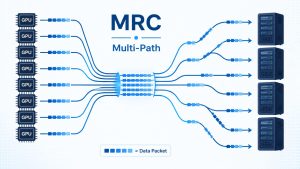
OpenAIの発表によれば、MRCの基盤となるのは「マルチプレーン構成」です。従来は800Gb/sのネットワークインターフェースを1本として扱っていましたが、MRCではこれを8本の100Gb/sに分割し、互いに独立した8つのネットワーク面(プレーン)として構築します。64ポートスイッチを例に挙げると、800Gb/sで接続すれば64台分の接続になりますが、100Gb/sに細分化すると512台分に相当します。その結果、10万基超のGPUをスイッチ2層のみで全接続でき、従来の単一プレーン構成で必要な3〜4層構成より部品点数・消費電力・コストを抑えられると説明されています。
しかし、経路を多く用意するだけでは輻輳は解消しません。従来のRDMA over Converged Ethernet(RoCE)では1転送を1経路に割り当て、パケットを順番通りに届ける必要がありました。MRCはこの制約を取り払い、1転送のパケットを数百の経路に同時分散する「パケットスプレイ」方式を採用しています。各パケットに最終的なメモリアドレスが付与されているため、到着順序が乱れても受信側が正しくメモリに書き込めます。
負荷分散の精度をさらに高めるのが「パケットトリミング」です。スイッチが輻輳でパケットを廃棄しそうになると、ペイロード部分を削ぎ落としてヘッダのみを転送し、明示的な再送要求を引き起こします。これにより経路障害と輻輳の誤検知を減らし、MRCが不必要にパスを切り替えることを防いでいます。この組み合わせにより、障害発生から迂回ルートへの切り替えまでの時間をマイクロ秒単位に短縮できるとされています。従来の構成では同様の処理に数秒から数十秒かかることもあったと説明されています。
SRv6による静的ソースルーティング
ネットワーク設計のもう一つの変更点はルーティング方式です。従来はBGP(Border Gateway Protocol)などの動的ルーティングプロトコルで各スイッチが経路を計算していました。ただ、スイッチのソフトウェアは複雑であり、微妙な不具合は診断が難しく、接続障害が長引くリスクがありました。
MRCではSRv6(IPv6セグメントルーティング)を採用し、パケットを送り出す時点で全経路情報をパケットのアドレス部に埋め込む「静的ソースルーティング」に切り替えました。スイッチは初期設定時に構成された静的テーブルを参照するだけでよく、動的にルートを再計算する必要がありません。パスで障害が起きても、MRCはそのパスの使用を止めて別の静的ルートを使うだけです。動的ルーティングに起因する障害クラス全体を設計上排除できる点が、このアプローチの利点だと考えられます。
実際の運用成果
OpenAIによれば、MRCはすでにNVIDIA GB200スーパーコンピュータ群に展開済みです。具体的には、Oracle Cloud Infrastructure(OCI)のテキサス州アビリーン施設と、MicrosoftのFairwaterスーパーコンピュータが該当します。実際の学習環境では、ティア0〜ティア1スイッチ間で1分あたり複数のリンクフラップ(リンクの瞬断)が観測されましたが、同期事前学習ジョブへの影響は計測不能なレベルに抑えられたとのことです。
また、ChatGPTおよびCodexの最新フロンティアモデル学習中にティア1スイッチ4台の再起動が必要になった際、学習チームへの事前通知なしで対応できたことも報告されています。MRC以前は、スイッチ再起動やリンクのメンテナンスは学習ジョブを止めるリスクがあり、オペレーションチームとの調整が不可欠でした。インターフェースの1ポートが失われた場合も、MRCは残りのプレーンで学習を継続し、物理的な帯域幅ロス以上の影響を受けにくい挙動が確認されています。
オープン標準化の意義
MRCの仕様はOCPを通じて無償公開されており、業界全体が利用・発展させられます。OpenAIはAMD・Broadcom・Intel・Microsoft・NVIDIAとの共同論文「Resilient AI Supercomputer Networking using MRC and SRv6」も合わせて公開しました。GPUクラスタが数十万基規模に拡大するにつれ、ネットワーク設計が実際に使える計算資源の量を左右する重要な要素になりつつあると考えられます。標準化によって複数のベンダーが対応製品を開発しやすくなれば、AIインフラのコスト・信頼性両面で業界全体にメリットが生まれる可能性があります。
まとめ
OpenAIが公開したMRCは、GPU間通信の輻輳排除・障害耐性・ネットワーク構成の簡素化という3つの課題に同時に対応した設計です。10万基超のGPUをスイッチ2層で接続しマイクロ秒単位の障害迂回を実現したことは、フロンティアモデル学習の安定性を支える基盤になっています。AI学習インフラの効率化に関心のある方は、Googleの「Decoupled DiLoCo」についても過去記事で整理していますので、あわせてご覧いただければと思います。