はじめに
Google DeepMindが2026年4月23日、大規模言語モデルの分散学習を刷新する新アーキテクチャ「Decoupled DiLoCo(Distributed Low-Communication)」を発表し、技術レポートを公開しました。本稿では、この発表内容をもとに、分散学習の課題と新手法の仕組み、実証実験の結果について解説します。
参考記事
- タイトル: Decoupled DiLoCo: A new frontier for resilient, distributed AI training
- 著者: Arthur Douillard and the DiLoCo team
- 発行元: Google DeepMind Blog
- 発行日: 2026年4月23日
- URL: https://deepmind.google/blog/decoupled-diloco/
関連記事
要点
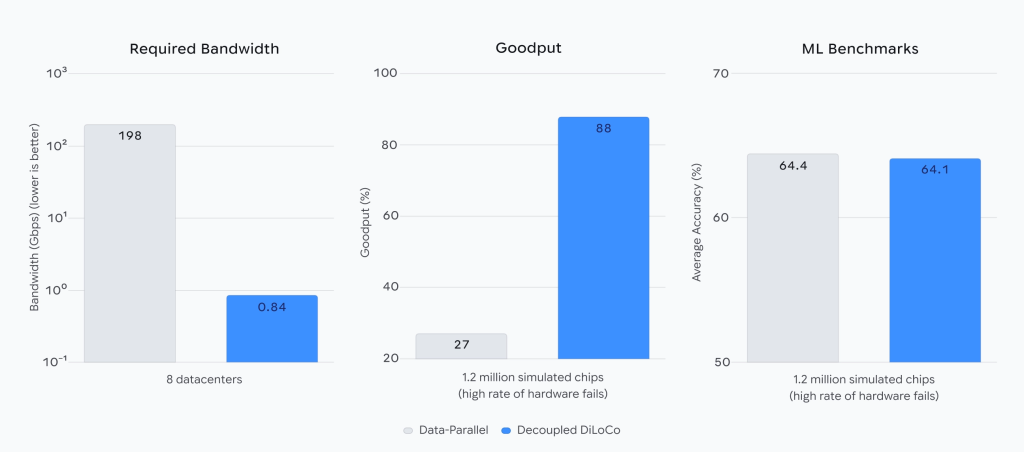
- 従来の分散学習に必要な帯域幅198Gbpsを、Decoupled DiLoCoでは0.84Gbpsまで削減できる(約235分の1)
- ハードウェア障害が多発する環境でも有効学習率(goodput)88%を維持し、従来手法の27%を大きく上回る
- 異なる世代のTPU(v6eとv5pなど)を混在させた学習でも、単一チップ種の学習と同等のMLベンチマーク性能を達成した
- Gemma 4モデルを使った米国内4リージョン間の実証実験で、12億パラメータモデルの学習に成功。通信速度は2〜5Gbpsで実現
- 従来の同期型手法と比べ、同じ学習結果を 20倍以上 高速に達成できることを確認した
詳細解説
課題:同期型分散学習の限界
フロンティアモデルのトレーニングは従来、数千〜数万のチップが密に同期を保ちながら並列動作する「密結合型」の構成を前提としていました。この方式では、1つのチップの障害や遅延が全体の進行を止めてしまうという問題があります。
さらに、データセンターをまたいだグローバルな分散学習では、チップ間の高速通信を維持するために大量の帯域幅が必要となります。Google DeepMindによれば、従来のData-Parallel方式では8つのデータセンターにまたがる構成で198Gbpsの帯域幅が必要であり、これは一般的なデータセンター間の商用ネットワーク回線では実現が難しいレベルです。モデルの規模が拡大するほど、この制約はより深刻になると考えられます。
仕組み:非同期「学習島」アーキテクチャ
Decoupled DiLoCoは、先行研究である「Pathways」と「DiLoCo」の成果を組み合わせたアーキテクチャです。PathwaysはGoogleが開発した非同期データフローに基づく分散AIシステム、DiLoCoはデータセンター間の帯域幅要件を大幅に削減した分散学習手法であり、Decoupled DiLoCoはこれらを土台にしています。
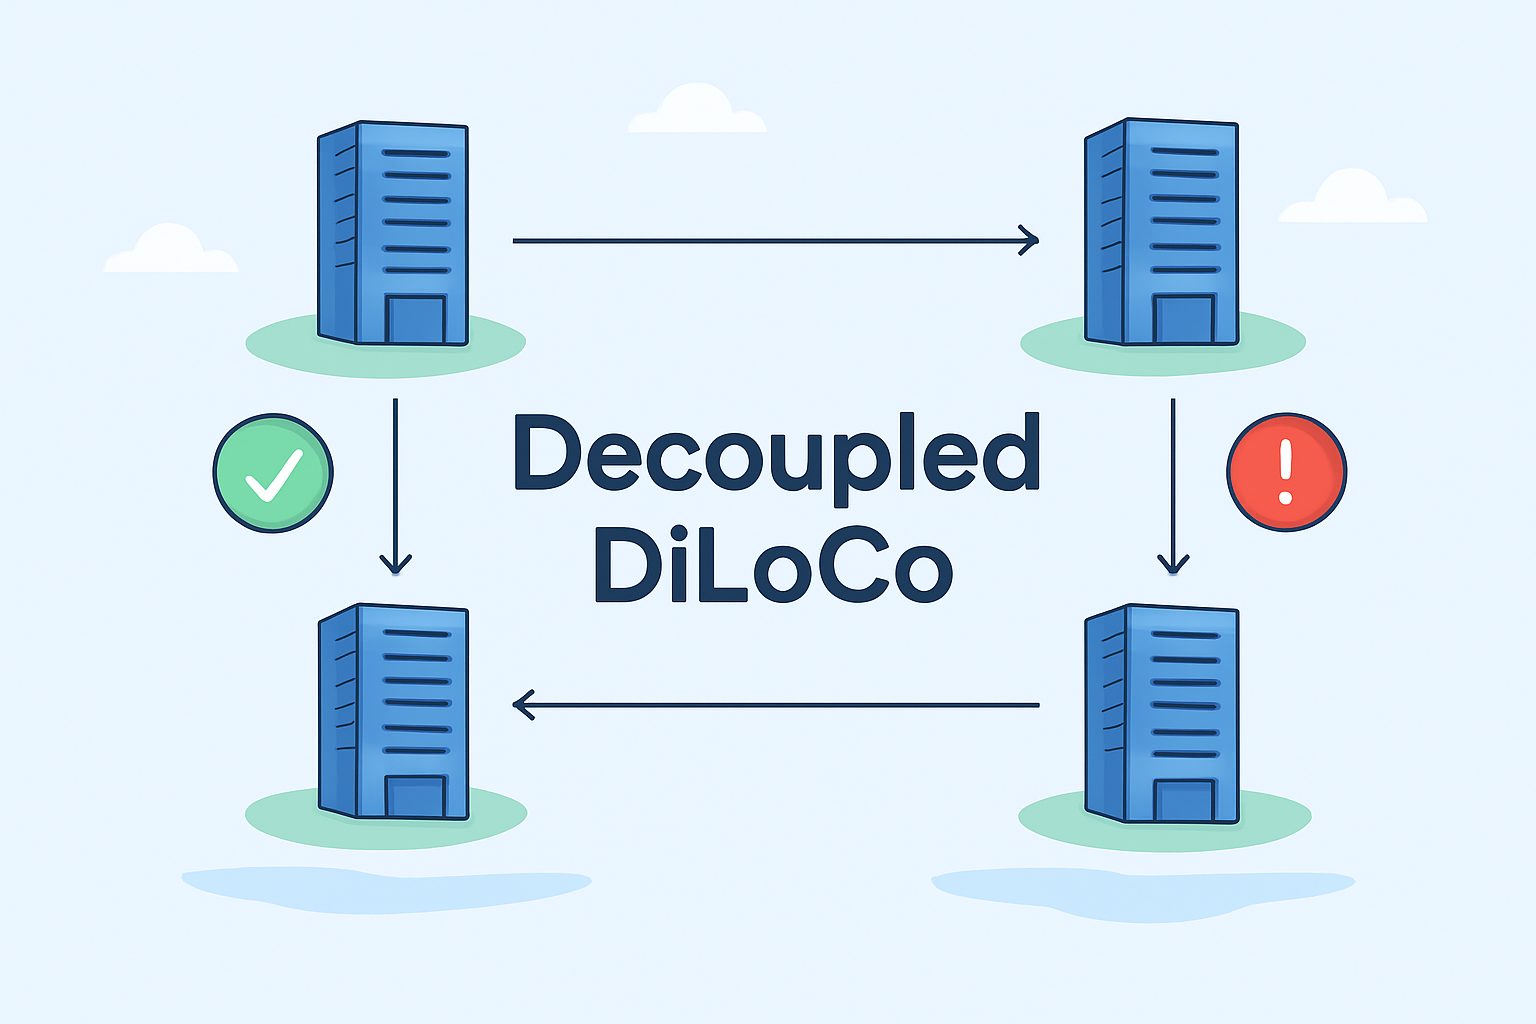
核心となるのは、大規模な学習処理を「learner units(学習ユニット)」と呼ばれる独立した「島(island)」に分割し、それぞれを非同期で動作させるという設計です。各島は独立して学習を続け、島をまたいだデータのやり取りは非同期で行われます。これにより、ある島でハードウェア障害が発生しても、他の島の学習は止まりません。
Google DeepMindはこの耐性を検証するために「カオスエンジニアリング」と呼ばれる手法を採用しました。これは、学習中に意図的にハードウェア障害を発生させてシステムの挙動を確認する手法です。実験では、学習ユニット全体が失われた後も学習が継続し、ユニットが復旧すると自動的に再統合される「自己修復」的な動作が確認されました。
性能検証:帯域幅・耐障害性・精度の三点評価
Google DeepMindが公開したデータによれば、Decoupled DiLoCoの性能は3つの観点で検証されています。
帯域幅については、Data-Parallel方式の198Gbpsに対し、Decoupled DiLoCoでは0.84Gbpsという値が示されています。この差は対数スケールで表示されるほど大きく、既存のデータセンター間商用回線(2〜5Gbps程度)の範囲内で運用可能なレベルです。
耐障害性については、120万チップ規模のシミュレーション環境でハードウェア障害率を高くした条件下で、Decoupled DiLoCoの有効学習率(goodput:実際に有益な学習に費やされた時間の割合)が88%を維持したのに対し、従来のData-Parallel方式では27%にとどまったとされています。
MLベンチマーク精度については、Decoupled DiLoCoを用いてGemma 4モデルを学習させた実験で、平均精度64.1%を記録し、従来方式の64.4%と実質的に同等の結果が得られました。分散化と非同期化によって学習効率を高めても、モデル性能は損なわれないことが示されています。
また、実際の運用環境を模した実証実験では、米国内4リージョンにまたがる構成で120億パラメータモデルの学習に成功しています。従来の同期型手法と比較して 20倍以上 高速に学習を完了させることができたとのことで、これは通信を長い計算ステップの中に組み込み、他の処理が通信を待機するボトルネックを回避する設計によるものと説明されています。
将来展望:ハードウェアの寿命延長と運用柔軟性
Google DeepMindはDecoupled DiLoCoの意義をモデル学習の効率化にとどまらず、より広いインフラ戦略の文脈で説明しています。
第一に、異なる世代のTPU(v6eとv5pなど)を同一の学習ジョブに混在させられることが確認されています。これにより、最新世代のチップが揃うまで旧世代を遊休状態にしておく必要がなくなり、既存ハードウェアの有効活用が可能になります。新チップの世代交代が段階的に行われる現実の運用環境では、これが実際の障害解消につながると考えられます。
第二に、インターネット経由での商用帯域幅で大規模学習が実現できる点は、新たなカスタムネットワーク設備への投資なしに、地理的に分散したコンピュートリソースを活用できることを意味します。今年4月に公開されたGemma 4の学習インフラとして実際に活用されており、研究段階を超えた実用水準にあることが示されています。
まとめ
Decoupled DiLoCoは、帯域幅の大幅削減・障害への高い耐性・既存水準のモデル性能という三点を同時に達成した分散学習アーキテクチャです。従来の密結合型から非同期の「島」分割型への転換は、今後のフロンティアモデル開発における計算インフラのあり方を変える可能性があり、今後の展開が注目されます。