はじめに
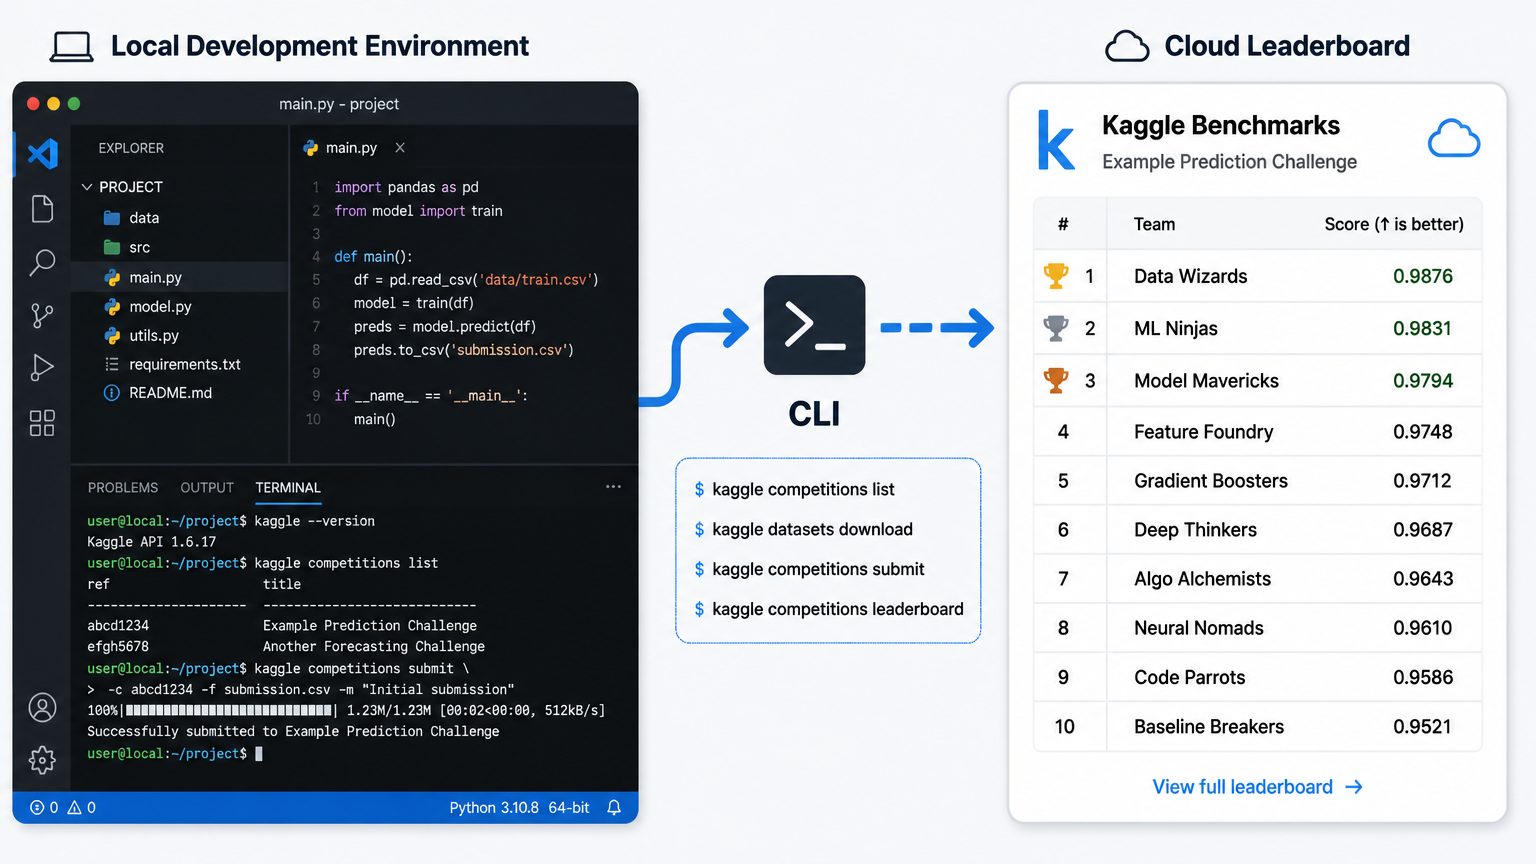
Kaggleが2026年6月4日、AIベンチマーク作成プラットフォーム「Kaggle Benchmarks」のローカル開発対応を発表しました。これまでWebブラウザ上の専用エディタのみで行っていた評価タスクの作成が、VSCodeやCursorなど使い慣れた開発環境やAIコーディングエージェントから直接行えるようになります。
参考記事
- タイトル: Kaggle is making AI benchmark creation effortless
- 著者: Nicholas Kang(Product Manager, Kaggle)、Andrew Wang(Software Engineer, Kaggle)
- 発行元: Google Blog
- 発行日: 2026年6月4日
- URL: https://blog.google/innovation-and-ai/technology/developers-tools/build-kaggle–benchmarks-locally/
関連記事
要点
- Kaggle Benchmarksのローカル開発対応により、評価タスクの作成・検証・プッシュ・実行・ダウンロードがVSCode・Cursorなどのローカル環境から直接行えるようになった
- AIコーディングエージェント向けの「write-kaggle-benchmarks スキル」が公開され、自然言語での指示からベンチマークタスクを構築できる新しいワークフローが登場した
- Kaggle CLIに新コマンドが追加されており、スキルのインストールと組み合わせることで一連の操作をエージェントが自律的に実行できる
- Kaggle Benchmarksはサービス開始以来、グローバルコミュニティによって1万件以上の評価タスクが作成されており、今回の更新でその敷居がさらに下がった
詳細解説
Kaggle Benchmarksとは
Kaggle Benchmarksは、AIモデルの能力を客観的に測定するための評価タスクを、コミュニティが自ら作成・公開できるプラットフォームです。Kaggleの発表によれば、サービス開始以来、世界中のコミュニティが1万件を超える評価タスクを作成しており、透明性の高い公開リーダーボードとして機能しています。
Kaggleがこのプラットフォームを立ち上げた背景には、AIモデルが単純なチャットボットから推論・コード生成・ツール利用をこなすエージェントへと進化したことへの問題意識があります。従来の静的なベンチマークでは、こうした多様な能力を十分に評価しきれないという課題があり、実際の現場でモデルを使う人たちが評価を作れる仕組みが求められていました。
ローカル開発環境への対応
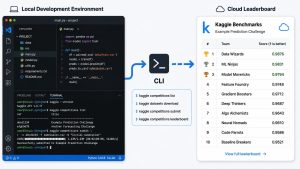
今回の更新の核心は、これまでKaggleのWebベースエディタ上でしか行えなかった評価タスク作成が、開発者が日頃から使う環境に持ち込めるようになった点です。Kaggleの発表では、VSCode・Cursor・Antigravityといったエディタや、AIコーディングエージェントとの連携を明示的に想定しています。
具体的には、Kaggle CLI(コマンドラインインターフェース)に新たなベンチマーク向けコマンドが追加されました。これにより、タスクの作成・検証(バリデーション)・プッシュ・実行・ダウンロードという一連の作業をすべてローカルから実行できます。開発者にとって、「アイデアが浮かんだ環境でそのまま評価を形にできる」という体験の変化は、作業効率の面で大きいと思います。
AIエージェントによる自然言語ベンチマーク作成
今回の発表でとりわけ注目されるのが、AIコーディングエージェントとの統合です。Kaggleは「write-kaggle-benchmarks スキル」をGitHubで公開しており、これをエージェントに読み込ませることで、自然言語の指示だけでベンチマークタスクを構築できます。
スキルのインストールは、エージェントに対して次のように指示するだけです。
“Install the write-kaggle-benchmarks skill: https://github.com/Kaggle/kaggle-skills”
スキルをインストールした後は、たとえば次のように自然言語で指示します。
Using the write-kaggle-benchmarks skill, build a task that asks the model if “300+140=460 is correct?”
この指示に対してエージェントが kaggle-benchmarks SDK と Kaggle CLI を組み合わせて動作し、実際に動くタスクを生成します。スキルとは、エージェントがツールの使い方を学ぶための構造化された指示セットであり、特定のSDKの操作手順やルールをまとめたドキュメントとして機能します。Claude Codeのような対話型コーディングエージェントとの親和性が高い仕組みと言えます。
Kaggleはこの仕組みについて、「誰でも、どこからでも、AIの未来を形作る評価を構築できるようにする」という方針を示しています。評価の多様性がモデル改善の方向性を決めるという考え方は、特定の企業や研究機関だけでなくコミュニティ全体がベンチマーク設計に参加できる環境を目指すものだと考えられます。
評価の民主化という文脈
Kaggle Benchmarksが最初に発表されたとき、コミュニティ主導の評価基準という方向性が示されていました。今回のローカル開発対応はその延長にある取り組みであり、「誰でも評価を作れる」という理念を技術的に実現する一歩と位置づけられます。
AIベンチマークは現状、一部の研究機関や大企業が主導して設計することが多く、特定のユースケースや文化的文脈が反映されにくいという指摘があります。多様な背景を持つ開発者がローカル環境から評価を投稿しやすくなることで、より実世界に即した評価体系が育つ可能性があると思います。
まとめ
KaggleがAIベンチマーク作成のローカル対応とAIエージェント統合を発表しました。CLIの新コマンドと専用スキルを組み合わせることで、自然言語の指示から評価タスクを構築できるワークフローが整い、評価作成のハードルが下がりました。コミュニティ主導のAI評価がどこまで広がるか、今後の展開が注目されます。Kaggle Benchmarksの基本的な仕組みについては、以前の解説記事もあわせてご覧いただければと思います。