はじめに
Google Developers Blogが2026年10月15日、AIエージェントを「なんとなくの目視確認(バイブチェック)」ではなく、再現可能な仕組みで評価するための実践ガイドを公開しました。本稿では、重要ユーザージャーニーによる成功の定義から避けるべき4つの落とし穴、Day 0〜Day 2の段階的な導入手順までを整理して解説します。
参考記事
- タイトル: Evaluating AI agents: moving past the vibe check
- 著者: 記載なし(提供された本文に著者名の表記なし)
- 発行元: Google Developers Blog
- 発行日: 2026年10月15日
- URL: https://developers.googleblog.com/evaluating-ai-agents-moving-past-the-vibe-check/
要点
- Googleは、最終回答だけを目視するバイブチェックでは、リトライのループやトークンの浪費、重複した副作用といったエージェント特有の隠れた失敗を見逃すと指摘している。
- 評価の起点は重要ユーザージャーニー(CUJ)による成功の定義であり、ユーザーシミュレーターで初期データセットを作り、実トラフィックへ段階的に置き換える流れが示されている。
- 落とし穴として、ベースラインの破壊、1〜5段階の曖昧な採点、運用コストの無視、フレームワークごとの評価基盤の作り直しの4つが挙げられている。
- 導入はDay 0の赤ペンによるトレース精読、Day 1の定型実行と50〜60回の小さな調整、Day 2のCI/CDマージゲートと共有ダッシュボードという3段階で進める構成である。
- オープンソースのagent-evalツールキットが、OpenTelemetryトレースの取得とGeminiプラットフォームのAgent Evaluationサービスとの連携を担うと紹介されている。
詳細解説
バイブチェックでは見抜けないエージェントの失敗
Googleによれば、多くのチームはAIエージェントの開発初期に、モデルにいくつかのツールを接続し、ターミナルで3〜4個のプロンプトを試して出力を目で確かめ、妥当そうなら出荷するという進め方をとりがちです。元記事はこうした確認を「バイブチェック(雰囲気で良し悪しを判断する確認)」と呼び、実際にはすぐに破綻すると指摘しています。あるワークフローの例外ケースを直すためにシステムプロンプトを調整したところ、別のワークフローで必須のツールを呼ばなくなる、といった事態が起こり得るためです。
さらに、エージェントは通常のソフトウェアとは異なる形で失敗します。リトライのループに陥り、ツールを何度も呼び出しながら、最終的には丁寧でもっともらしい回答を返すことがあります。元記事では、こうした隠れた失敗が本番環境で次のようなコストを生むと整理しています。
- クラウドの請求額とトークン使用量が、気づかないうちに急増する
- 下流のAPIのレート制限やクォータ(利用上限)を使い切ってしまう
- ユーザーをローディング表示の前で待たせ続ける
- 表面上は「問題なし」に見えたまま、外部システムで重複した副作用を引き起こす可能性がある
- ユーザーの信頼を損ない、一度失った第一印象は取り戻しにくい
一方で元記事は、評価を「段階的に育てていくもの」と位置づけています。単純であっても再現可能な評価の仕組みがあれば、場当たり的なスポットチェックや仕組みがない状態よりも良く、Day 0の時点で精巧な自動採点の仕組みは不要だとしています。まずは単純で繰り返せるチェックから始め、エージェントの機能や本番の要求が増えるのに合わせて、より複雑な自動化フレームワークへと発展させる考え方です。そのための柱として「人間による監督」と「目的に合ったツール」の2つを挙げ、オープンソースのagent-evalツールキットを使って、人が確認したトレース(実行の記録)と自動検証を組み合わせ、気づかれないまま進むデグレード(性能の劣化)を開発の早い段階で検出する方法を紹介しています。
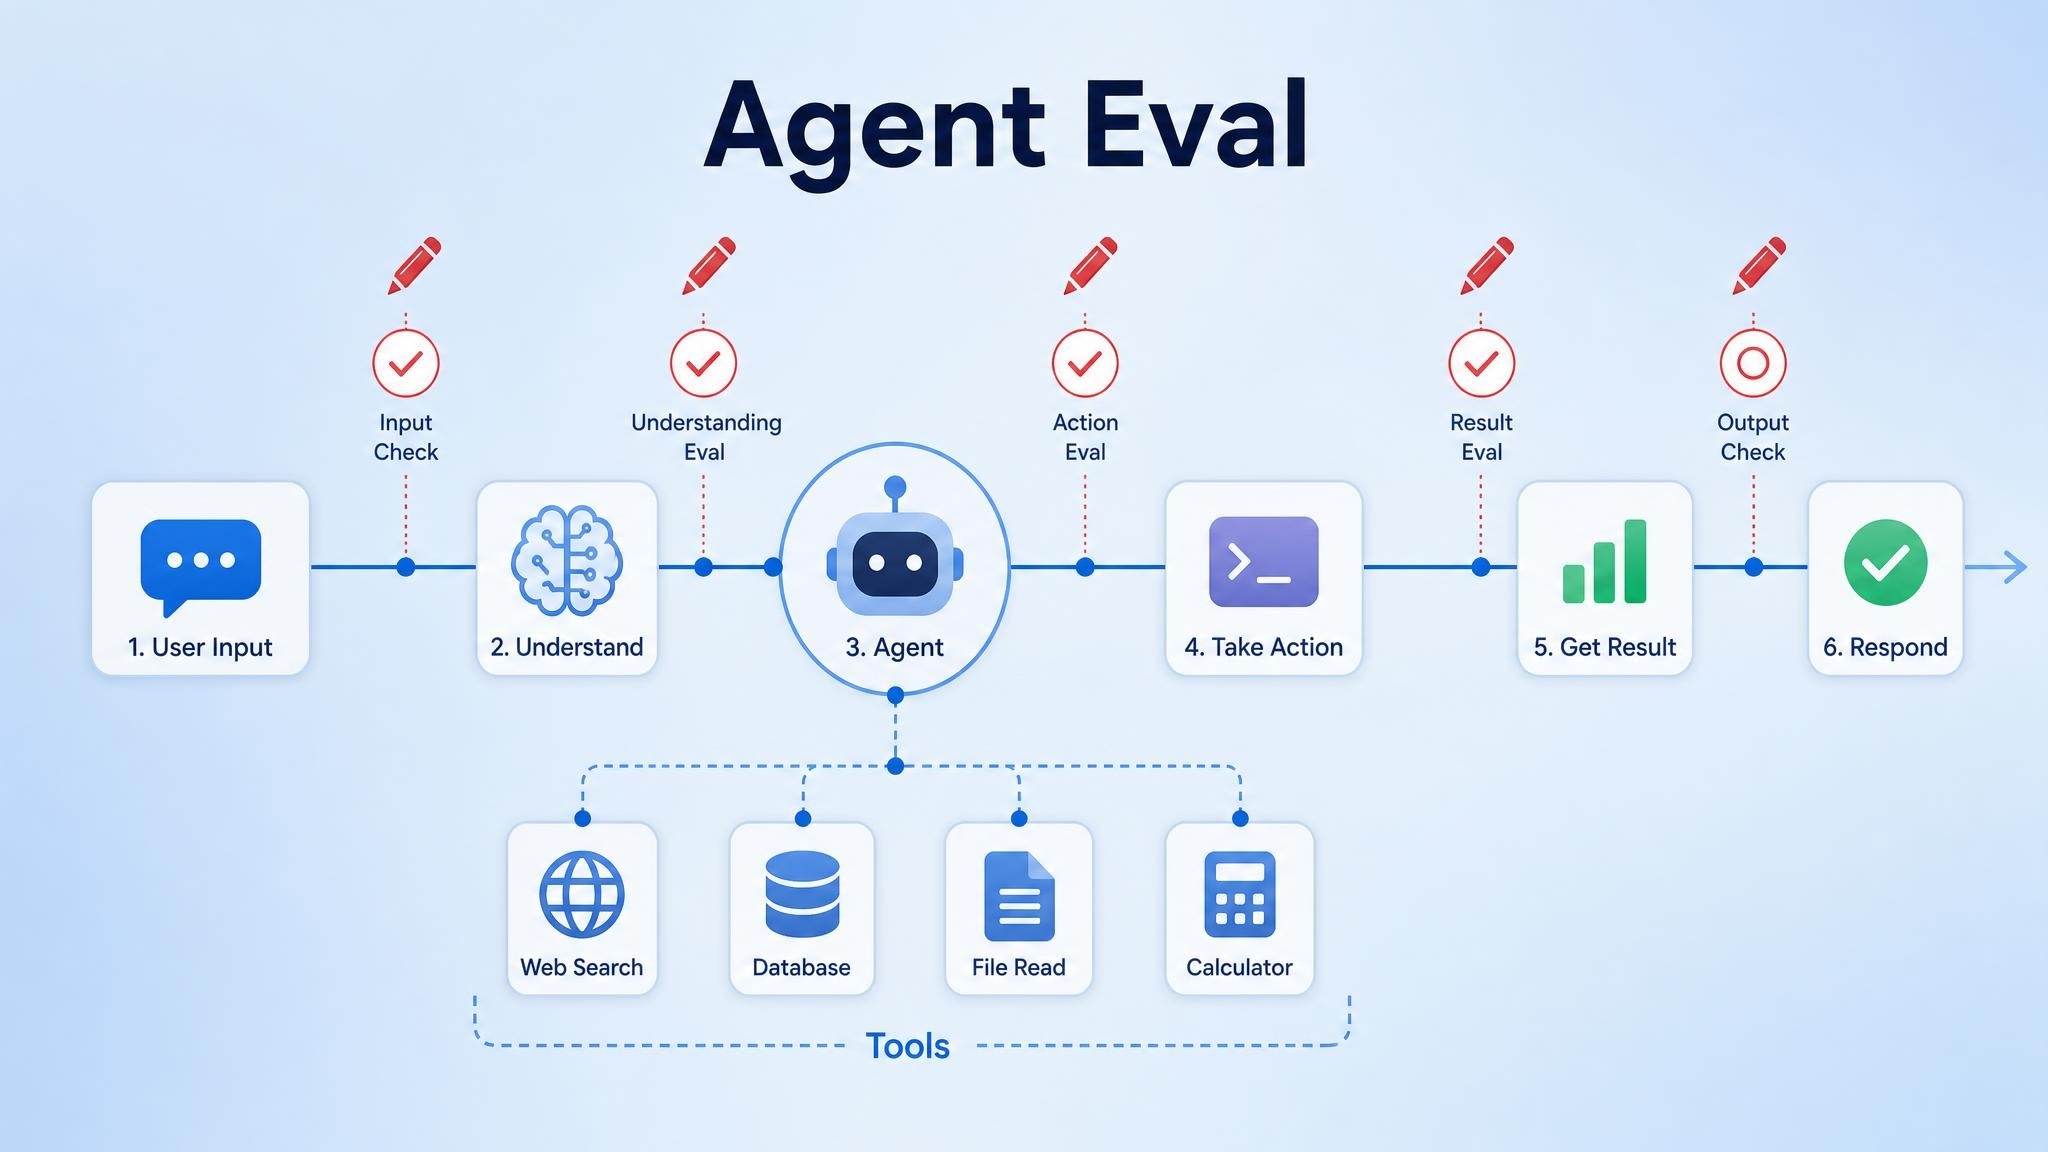
なお、この記事はGoogleのAI Agent Clinicシリーズのエピソード「How to Actually Evaluate (Any) AI Agent: Beyond the Vibe Check」の内容をまとめたもので、元記事によれば、動画ではLangGraphで作られたエージェント向けの評価パイプラインを60分で構築しています。元記事冒頭のTL;DRには全体像を示す図も掲載されています。
本稿としては、エージェントの品質が「最終回答の文面」だけでなく「そこに至る経路」にも左右される点が、従来のソフトウェアテストとの大きな違いだと考えています。入出力の一致だけを確かめる従来型のテストでは、経路上の無駄や誤りが見えにくいためです。
構成要素1:重要ユーザージャーニー(CUJ)で成功を定義する
元記事は、テストコードを書く前に「良い結果とは何か」をチーム内で共有する必要があるとし、抽象的なベンチマークではなく重要ユーザージャーニー(CUJ: Critical User Journey)にテストを結びつけることを勧めています。CUJは、ユーザーのペルソナ、目標、制約、検証条件を軸に「ユーザーがシステムに何を達成してほしいか」を定義したものです。元記事では次のような例が示されています(本稿による訳)。
> 「オペレーションアナリストとして、エージェントには、取引相手から届いた取引の不一致に関するメールを取り込み、争点となっている取引を特定し、30秒以内に社内台帳と照らして取引条件を検証し、社内の取引IDをブローカー側の呼称に逆変換した返信の下書きを、人の介入なしに作成してほしい」
この文の各節が、そのまま評価ポイントになります。元記事が挙げる問いは次のとおりです。
- エージェントは正しい取引IDを特定できたか
- 下書きを作成する前に台帳を確認したか
- 社内IDを外部の呼称へ正しく対応づけたか
期待値を最初に定義しておくことで、プロダクトの関係者、下流のユーザー、エンジニアが「成功をどう測るか」について合意せざるを得なくなる、というのが元記事の主張です。
補足すると、CUJはアジャイル開発でユーザーストーリーに付ける受け入れ条件(アクセプタンスクライテリア)に近い発想と言えます。本稿としては、「30秒以内」「人の介入なし」のように数値や条件を文に含めておくと、後で真偽判定のチェックへ変換しやすくなる点が実務上の利点だと考えています。
構成要素2:シミュレーションユーザーから始め、実トラフィックへ移行する
元記事によれば、最初のゴールデンデータセット(評価の基準として固定して使うテストケース集)を作るのに、6か月分の本番ログは必要ありません。各CUJを具体的なシナリオ(正常系のハッピーパスと例外的なエッジケースの両方)に分解し、ユーザーシミュレーター役のLLMに入力します。元記事ではADKのユーザーシミュレーション機能が推奨されています。シミュレーターにペルソナと振る舞いの制約を与えると、実際のユーザーの崩れた言い回しや誤字、複数ターンにわたる複雑なやり取りを再現できるとしています。制約の例として、元記事は次の2つを挙げています。
- チケット番号を不完全にしか伝えない、せっかちなアナリスト
- 複数の論点を含むデバッグの質問をする開発者
合成ユーザーと現実的なシナリオでテストすることで、実ユーザーが触れる前に、ツールログを含む包括的な実行トレースを記録できます。これによりリリース基準に対する性能のギャップを特定して解消でき、実トラフィックが流れ始めたら、合成のセットアップを本番トレースへ段階的に置き換えていく流れです。元記事にはADKユーザーシミュレーション用のシナリオ例を示す図も掲載されています。
補足すると、シミュレーター自体もLLMであるため、生成される発話には一定の偏りが含まれる可能性があります。本稿としては、元記事が「実トラフィックへの移行」をセットで示している点は、合成データだけでは実際の利用を覆いきれないという限界を踏まえた設計と読めます。
構成要素3:4層のチェックでスタック全体を測る
元記事は、単一の総合スコアではエージェントが「なぜ」失敗したのかは分からないとし、根本原因を切り分けるために次の4種類のチェックを重ねることを勧めています。
- 単体テスト(ユニットテスト)
- 決定論的メトリクス
- LLM-as-a-judgeによるルーブリック評価
- 統合テスト
元記事では4層の名称と図が示されています。各層の一般的な意味合いを本稿で補足すると、単体テストは個々のツール関数などを従来どおり検証するもの、決定論的メトリクスはツール名や引数の一致、呼び出し回数のように毎回同じ結果になる計算で測るもの、LLM-as-a-judgeは別のLLMに評価基準(ルーブリック)を渡して回答を採点させる手法、統合テストはエージェント全体を外部システムとつないだ状態で確かめるもの、と整理できると思います。安価で安定した層から順に積み上げることで、失敗の原因がどの層にあるかを絞り込みやすくなると考えられます。
避けるべき4つの落とし穴(概要)
元記事は、評価の仕組みを作る際に陥りやすい落とし穴として、次の4つを挙げています。
- テストを捨ててベースラインを壊す
- 真偽判定ではなく、曖昧な1〜5段階の採点に頼る
- 文面の品質だけを評価し、運用コストを無視する
- エージェントフレームワークごとに別の評価パイプラインを作る
いずれも「評価結果を比較可能に保つ」「結果を判断に使える粒度にする」という観点に関わるものと読めます。以下で順に見ていきます。
落とし穴1:テストを捨ててベースラインを壊す
評価指標の整備には試行錯誤が伴うため、ノイズの多いテストを削除したり、実行ごとにサンプルクエリを差し替えたりしたくなります。しかし元記事によれば、テストを追加・削除するたびにベースライン(比較の基準となる過去の結果)が無効になり、スコアの変化がエージェントの改善によるものか、テストセットが変わったためかを区別できなくなります。元記事の図でも「テストを消して動くのはベースラインであって、エージェントではない」と示されています。対策として元記事が挙げるのは次の3点です。
- 機能を調整している間はゴールデンデータセットを固定する
- 一度に変更する変数は1つだけにする
- テストを廃止するのは、背後にある要件が変わったと確信できる場合に限る
これは科学実験における対照実験と同じ構造の考え方だと言えます。本稿としては、データセットをバージョン管理し、どの版で測ったスコアかを記録しておくと、この落とし穴を避けやすいと考えています。
落とし穴2:曖昧な1〜5段階の採点に頼る
元記事は、LLMは1〜5段階の定性的な尺度での採点が一貫しないことで知られており、「3」と「4」の境界は曖昧で、実行のたびに揺れることが多いと指摘しています。そのため、可能な限り評価者(ジャッジ)用のルーブリックを、自由度の高い評価尺度ではなく真偽(合格/不合格)で答える問いに変換することを勧めています。
- 避けたい問い:「この回答は1〜5でどの程度役に立ったか」
- 推奨する問い:「エージェントは返金ツールを呼ぶ前にアカウントIDを検証したか(はい/いいえ)」
元記事では、この考え方に沿う仕組みとしてGeminiプラットフォームのAdaptive Rubricsが紹介されています。
補足すると、真偽判定は集計すれば「合格率」という比較しやすい指標になり、どの観点で失敗したかも特定しやすくなります。一方で、品質の多面的な要素を十分に覆うには問いの数を増やす必要があり、問いの設計そのものに手間がかかる点は導入時の考慮点になると思います。
落とし穴3:文面だけを評価し、運用コストを無視する
元記事は、すべての品質チェックを通過した回答であっても、40秒かかり、冗長なツール呼び出しを12回行い、1クエリあたり60セントのコストがかかっていれば本番では失敗だという例を挙げています。最終的なテキストだけでなくシステム全体を評価し、回答品質と並べて次の指標を追跡するよう勧めています。
- レイテンシ(応答までの時間)
- トークン消費量(プロンプト、推論、生成の各トークン)
- APIコスト
- ツール呼び出し回数
1クエリあたりのコストは利用量に比例して積み上がるため、小さな差でも月間では無視できない金額になる可能性があります。本稿としては、品質指標と運用指標を同じレポートで見比べることが、「賢くなったが遅く高くなった」変更を見落とさないための前提だと考えています。
落とし穴4:フレームワークごとに評価パイプラインを作り直す
オーケストレーション(複数のステップやツール呼び出しを制御する仕組み)のフレームワークを切り替えると、テストスイート全体を作り直す羽目になることがよくあります。元記事によれば、多くのフレームワークはOpenTelemetry(分散システムの計測データを扱うオープンな標準)のトレースを出力しますが、ツール呼び出し、ステップ、トークンについて共通のセマンティック規約(どの属性に何を記録するかの取り決め)を使っているわけではありません。そこでOpenInferenceのようなオープンな仕様にトレースを標準化すれば、評価をオーケストレーションフレームワークから切り離せるとしています。元記事では、agent-evalツールキットがこれを最小限の設定でネイティブにサポートしていると説明されています。
補足すると、トレースの形式さえそろっていれば、評価側のコードはフレームワークの内部構造を知らなくて済みます。フレームワークの移行や併用を想定しているチームにとって、評価資産を使い回せるかどうかは長期的な保守コストに影響すると考えられます。
Day 0〜Day 2の段階的導入:全体像と前提
元記事は、可観測性(オブザーバビリティ)基盤をゼロから作る必要はないとしています。OpenTelemetryのトレース取得と、GeminiプラットフォームのAgent Evaluationサービス(旧Vertex AI Evaluation)を組み合わせるagent-evalツールキットのようなオープンソースのユーティリティを使えば、評価パイプライン自体は数時間で立ち上げられるとしています。ただし、実際の評価戦略を組み立てるには、より多くの検討が必要だと付け加えています。
元記事の記述をもとに、導入時にそろえておきたい要素を本稿で整理すると次のとおりです。あくまで本稿の整理であり、詳細な要件はリポジトリ側での確認が必要です。
- 評価対象のエージェント(HTTP経由で呼び出せる状態、またはオフラインで実行できる状態)
- OpenTelemetry形式のトレースを取得できる実行環境(Google ADK、LangGraph、独自ランタイムのいずれか)
- 自動採点にAgent Evaluationサービスを使う場合は、Geminiプラットフォームを利用できる環境
- CUJから作成したシナリオと、それを固定したゴールデンデータセット
注意: 元記事にはインストールコマンドや設定ファイルの具体例、対応バージョンなどは掲載されていません。実際に導入する際は、GitHubリポジトリのドキュメントで最新の手順と要件を確認する必要があります。
Day 0:シナリオ、シミュレーション、そして「赤ペン」
Day 0では、小さく始めて生データの近くにとどまることが求められます。元記事が示す手順は次の3ステップです。
- 主要なCUJをカバーするシナリオを作成し、エージェントでシミュレーションを実行します。
- 集計スコアは見ずに、プロンプト、中間の推論ステップ、ツールの引数、最終出力まで、実際の実行トレースを最初から最後まで読みます。
- 赤ペンで添削するようにトレースを採点し、エージェントがためらった箇所、パラメータを捏造(ハルシネーション)した箇所、誤ったツールを選んだ箇所、冗長に話し続けた箇所をすべて印付けします。
赤ペンが重要な理由について、元記事は次のように説明しています。20件のトレースを手で読むのはグラフを自動生成するより遅く感じますが、結果的に何日分もの無駄な作業を省けます。仮説上の失敗パターンを推測して的外れな汎用ルーブリックを書く代わりに、1時間の赤ペン作業でシステムが実際にどう壊れるかが分かり、そのメモを集約すれば、次に作るべき決定論的なアサーション(検証条件)と真偽判定のチェックの、精度の高いリストが得られるとしています。
この進め方は、機械学習の分野でエラー分析と呼ばれる手法に近いものと考えられます。本稿としては、評価指標を先に設計するのではなく、観察した失敗から指標を逆算する順序がDay 0の要点だと読んでいます。
Day 1:実行の定型化、シグナル、テストフレームワーク
Day 0で最初のチェックリストができたら、agent-evalツールキットのようなツールが実行の負担を引き受け、手順を標準化します。元記事が挙げる支援内容は次のとおりです。
- 雛形作成と実行:ゴールデンデータセットの雛形を作り、複数ターンのシナリオをHTTP経由(`–base-url`オプション)またはオフラインでエージェントに対して実行する
- フレームワークに依存しないトレース取り込み:Google ADK、LangGraph、独自ランタイムのいずれで構築していても、OpenInferenceの規約に沿った構造化されたOpenTelemetryトレースを取得する
- Agent Evaluationとの連携:取得したトレースをGeminiプラットフォームのAgent Evaluationサービスに渡し、独自のAPIコードを書かずに決定論的チェックと真偽判定のルーブリックを実行する
注意: 元記事に記載されているのは`–base-url`というオプション名のみで、コマンド全体の書式や指定する値の例は示されていません。
そのうえで、評価パイプラインを定期的に回すリズムとして、次の2点が示されています。
- 変更のたびに実行する:プロンプトの調整、モデルの差し替え、ツールのdocstring(関数の説明文)の編集を行ったら、まったく同じテスト群を実行し、ベースラインとの差分を比較する。元記事には、agent-evalのHTMLレポートでメトリクスの推移を確認する図が掲載されている
- 評価者をトレースと突き合わせて検証する:新しいLLM-as-a-judgeの指標を盲信せず、Day 0で手作業で採点したトレースと自動スコアを比較する。赤ペンで指摘したトレースに評価者が合格点を付けた場合は、自動評価の結果がエンジニアの判断と一致するまで採点プロンプトを厳しくする
後者は、評価者そのものを評価する「メタ評価」にあたると言えます。本稿としては、人手の採点を正解データとして評価者を較正するこの手順が、LLM-as-a-judgeを信頼して使うための土台になると考えています。
チューニングループ:書き直しではなく、50〜60回のつまみ調整
Day 1の仕組みが動き出すと、最適化は規律ある機械的なループになります。元記事によれば、実際のデプロイで本番品質に達するまでには、小さな反復を50〜60回重ねることが多いとされています。毎朝システムプロンプト全体を書き直すのではなく、個々のつまみを少しずつ回していくイメージで、元記事は次の例を挙げています。
- ツールのパラメータ説明を明確にする
- 否定形の制約(「〜しないこと」)を追加する
- JSON出力のスキーマを調整する
agent-evalフレームワークは評価の実行が終わるたびに、インタラクティブなオールインワンのHTMLレポートを生成します。元記事によれば、このレポートには次の情報がまとめて表示されます。
- 合格/不合格の真偽判定メトリクス
- レイテンシ、トークン使用量、API費用、キャッシュ利用状況などの運用メトリクス
- ツール呼び出しの詳細な実行経路
- 失敗した会話ターンに対する、Geminiによる自動の根本原因分析(失敗を引き起こしたプロンプトの指示やパラメータ設定を特定し、次の調整の手がかりにする)
こうしたデータが勘に取って代わります。元記事では、手作業のスポットチェックではずっと賢くなったように感じたプロンプト変更が、テスト群にかけるとレイテンシが2倍になり、ツール呼び出しのハルシネーションが15%増えていた、という例が示されています。元記事の結論は「小さく測定された変更は、大きな書き直しに毎回勝る」というものです。
なお、50〜60回という回数は元記事が示す目安であり、エージェントの複雑さやCUJの数によって変わると考えられます。本稿としては、回数そのものより「1回の反復で1つの変数だけを変え、同じテスト群で測る」という規律が、落とし穴1の対策とも一貫している点が重要だと思います。
Day 2:マージゲートと共有ダッシュボード
評価パイプラインのシグナルを信頼できるようになったら、それを恒久的なリグレッション(以前できていたことができなくなる不具合)の安全網に変えます。元記事が示す施策は次の2つです。
- ヘッドレスCLIによるCI/CDのプルリクエストゲート:agent-evalのようなツールを、Cloud BuildやGitHub Actionsなどのビルドパイプライン内で画面なし(ヘッドレス)で実行する。プルリクエストのたびにゴールデンデータセットを実行し、次の2つのマージルールを適用する
- 全体の合格しきい値:テスト群が最低限の合格ラインを満たす必要がある(例: 真偽判定の成功率95%)
- コア評価メトリクスのリグレッションゼロ:全体スコアが維持されていても、以前合格していたメトリクスが1つでも後退すればビルドを失敗させる。これにより、重要な能力と引き換えに細かなエッジケースの改善を取り込んでしまう事態を防ぐ
- 共有ダッシュボードと集中ストレージ:評価プロセスの成果物を、BigQueryやCloud Storageといった中央のデータ基盤にエクスポートする。対象は生のトレースJSONL、プロンプトのハッシュ値、モデルのバージョン、レイテンシのプロファイル、スコアカードの要約などである。これらのメトリクスをチームの共有ダッシュボードで公開すれば、リリースをまたいだ正確性、レイテンシのパーセンタイル、トークン予算を全員が把握できる
元記事の図では、ローンチ後に本番のトレースがゴールデンデータセットへ戻っていく循環が示されています。
補足すると、LLMの出力には実行ごとの揺らぎがあるため、「リグレッションゼロ」のルールを厳格に運用すると、実際には劣化していない変更でもビルドが失敗する場面が出てくる可能性があります。本稿としては、複数回実行して判定する、揺らぎの大きいメトリクスはゲート対象から外すといった運用上の調整を、導入時に検討しておくとよいと考えています。
実際の様子と関連リソース
元記事では、内容を実際に確認するための次のリソースが紹介されています。
- 解説動画:How to Actually Evaluate (Any) AI Agent: Beyond the Vibe Check。実在のLangGraphエージェントを対象に、このパイプライン全体を60分でライブ構築する内容とされています
- コード:GitHub上のagent-evalツールキット。クローンすれば、データセットの雛形作成、トレースの収集、診断用HTMLレポートの生成をすぐに試せるとされています
- 関連記事:The Outer Loop, Insights First: An Ambient Quality Agent That Diagnoses Your Production Agent.
上記の動画やリポジトリは元記事の説明に基づいて紹介しており、本稿では個別の動作確認は行っていません。
よくある質問から押さえたいポイント
元記事の末尾には、5つのよくある質問(FAQ)がまとめられています。本文の内容を補う記述も含まれるため、問いごとに整理します。
- Q1. AIエージェントを手作業の「バイブチェック」で確かめることの問題は何か:ターミナルで3〜4個のプロンプトを試しても、分かるのは最終的なテキスト回答だけです。エージェントはリトライのループ、ツールパラメータのハルシネーション、トークン予算の浪費、重複した副作用の発生を起こしながらも、丁寧な回答を返すことがあります。自動化されたトレース評価では、中間のツール呼び出し、状態遷移、レイテンシのパーセンタイル、APIコストを回答品質と並べて確認できるため、気づかれないリグレッションの出荷を防げるとしています。
- Q2. AIエージェントをゼロから評価するにはどうすればよいか:評価を「全部か無しか」の一足飛びではなく、Day 0からDay 2への段階的な展開として扱います。Day 0ではCUJを少数のテストシナリオに分解してADKのユーザーシミュレーションで実行し、最初の5〜20件の実行トレースを赤ペンで読みます。Day 1ではそのメモを自動チェックに変え、1つの変数ずつ調整します。合格率が安定したら、Day 2でそれらのチェックをCI/CDのプルリクエストゲートに組み込みます。
- Q3. LLM-as-a-judgeで1〜5段階ではなく真偽判定を使う理由は何か:「3」と「4」の境界が実行ごとに揺れるため、LLMの評価者は1〜5段階を一貫して採点できません。Adaptive Rubricsを使えば、広い品質目標を「返金前にアカウントIDを検証したか」のような厳密な Yes/No の問いに分割できます。元記事は、これらの真偽判定ルーブリックに、ツールパラメータや参照チェックのための決定論的な計算メトリクス(computation metrics)と、レイテンシやトークン予算に関するトレースのアサーションを組み合わせることを勧めています。
- Q4. LangGraph、Google ADK、独自フレームワークで同じ評価パイプラインを使えるか:OpenTelemetryのトレースをOpenInferenceのセマンティック規約で標準化し、評価パイプラインをエージェントフレームワークから切り離せば可能だと回答しています。agent-evalツールキットがトレースをGeminiプラットフォームのAgent Evaluationサービス(旧Vertex AI Evaluation)に直接渡すため、オーケストレーションフレームワークを切り替えても採点コードを書き直す必要はないとしています。
- Q5. エージェントを本番にデプロイした後はどうなるか:Day 2のパイプラインがトレースとスコアカードをBigQueryやCloud Storageにエクスポートしていれば、実トラフィックを本番前のベースラインと比較できます。初期シナリオで想定していなかったエッジケースにユーザーが遭遇した場合は、The Outer Loopのような常駐型の品質エージェントが、失敗した本番トレースの診断を助けます。その実トレースをDay 0のゴールデンデータセットに直接昇格させることで、テスト群を実際の利用とともに進化させられるとしています。
Day 0の説明では「20件」、FAQでは「最初の5〜20件」と、読むべきトレース数の表現にはやや幅があります。本稿としては、厳密な件数よりも、集計値に頼る前に一定数のトレースを人が読むこと自体に重きが置かれていると読んでいます。
まとめ
Googleの記事は、AIエージェントの評価を最終回答の目視から、トレースの精読、真偽判定のチェック、運用指標の計測、CI/CDのマージゲートへと段階的に移す道筋を示しています。本稿としては、赤ペンレビューから小さく始められる点が導入しやすさにつながると考えており、本番トレースを評価データへ戻す運用の事例に今後注目しています。