はじめに
Mistral AIは2026年10月20日、音声認識と音声合成の新モデル群に音声エージェントSDKを組み合わせた「Voxtral 3」を発表しました。本稿では、この発表内容をもとに、50以上の言語に対応する文字起こし、感情や方言を表現する音声合成、リアルタイムの音声エージェントの仕組み、料金体系について解説します。
参考記事
- タイトル: Voxtral 3
- 著者: 記載なし
- 発行元: Mistral AI
- 発行日: 2026年10月20日
- URL: https://mistral.ai/news/voxtral-3/
要点
- Mistral AIはVoxtral 3として、文字起こしモデル、音声合成モデル、音声エージェントSDKを同時に発表した。
- 文字起こしモデル「Voxtral Small Transcribe 3」は50以上の言語に対応し、話者分離とコンテキストバイアスを備え、Mistral AIは多言語文字起こしで最先端の性能としている。
- 音声合成モデルは35以上の言語と50以上の方言に対応し、文脈に応じて感情や話す速さ、強調を調整する。料金は100万文字あたり13ドルである。
- LiveKit上に構築された音声エージェントSDKは、聞き取り・推論・ツール呼び出し・発話を1つのストリーミング処理で実行し、各ターンを1秒未満で完了するとされる。
- 欧州・米国・グローバルのエンドポイントを持つMistral APIで提供が始まっており、自社インフラへのセルフデプロイにも対応する。
詳細解説
Voxtral 3の全体像と音声エージェントに求められる4つの能力
Mistral AIは、音声の文字起こしや音声生成の技術が大きく進歩した一方で、聞き取り、推論、対話、複雑な業務フローの処理までをこなすエンドツーエンドの音声エージェントの構築は依然として難しいと指摘しています。そのうえで、信頼できる音声エージェントが同時に高い水準でこなすべきこととして、次の4点を挙げています。
- 正確に聞き取る: 言語、アクセント、話者の違いや、会話の割り込みがあっても正確に聞き取る
- 深く推論する: 特定の文脈の中で、ユーザーが何を意図しているかを深く理解する
- 自然に話す: 感情や表現を伴った自然な音声で応答する
- 行動する: 接続されたシステムを通じて、複数のステップにわたる操作を実行する
Mistral AIによれば、この4つをリアルタイムで確実に連携させることが課題であり、Voxtral 3はその解決を目指して開発されました。Voxtral 3は、音声をテキストに変換する音声認識(speech-to-text)モデルと、テキストを音声に変換する音声合成(text-to-speech)モデルの新しいファミリーに、聞き取り・思考・ツール呼び出し・発話を単一のリアルタイムのストリーミング処理にまとめる音声エージェントSDK(ソフトウェア開発キット)を組み合わせた構成です。想定用途として、コンタクトセンターのエージェントやサービスデスク、バーチャルアシスタント、ハンズフリーのコパイロットが挙げられています。発表ページの冒頭には、利用者がフランス語で書かれた紹介状をもとに診察の予約を依頼し、番号を言い直しながらやり取りする通話デモも掲載されています。
また、Voxtral 3は他のMistralモデルと同様に、ソブリン(主権的)なデプロイを前提に設計されているとされます。EU域内でホストされるMistralのAPIか、自社インフラへのセルフデプロイを選択でき、音声をどこで処理するか、データをどう扱うか、会話を保存するかどうかを組織側で管理できる点が強調されています。
本稿としては、この4つの能力の整理は、音声エージェントを評価する際の観点としても使いやすいと考えています。音声認識、言語モデル、音声合成を別々に調達して組み合わせる構成では、各段の遅延が積み重なることや、段の間で話し手の感情などの情報が失われることが課題になりやすいと考えられます。Voxtral 3がこれらを1つのSDKで扱う設計をとった背景には、こうした課題があると読めます。データ主権については、音声に個人情報が含まれやすいことを踏まえると、医療や金融など規制の厳しい業界で導入を検討する際の判断材料になる可能性があります。
発表のハイライト(5項目)
Mistral AIは、今回の発表のハイライトを次の5点にまとめています。
- 50以上の言語で正確な文字起こし: 文字起こしモデル「Voxtral Small Transcribe 3」は多言語の文字起こしで最先端(state-of-the-art)の性能を持つとされます。誰が何を話したかを識別するダイアライゼーション、キーフレーズを与えて精度を高めるコンテキストバイアス、話し終わりを検知してエージェントが遅れずに応答できるようにする発話終了検知に対応します。
- 会話に合わせて変化する自然な音声: 音声合成モデル「Voxtral Mini TTS 3」は、会話の文脈に応じて感情、話す速さ、強調を調整する新しい音声を備え、35以上の言語と50以上の方言に対応します。
- 話し言葉で指示できる人間らしい知能: 新しい音声エージェントSDKは、聞き取り、推論、ツール呼び出し、発話をリアルタイムの体験として統合します。電話やWebでの通話中に、情報の取得、業務システムとの連携、タスクの完了ができます。
- 話者の特徴を再現する「Pro Voice」: 基本的な音声クローンでは足りない業務用途向けに、話者特有の声の特徴、感情の幅、話し方を、言語をまたいで再現できるとされます。必要な音声はわずか30分とされています。
- 自社インフラで動く音声AI: EU域内でホストされるAPIを使うか、自社インフラにVoxtral 3をデプロイでき、機密性の高い会話を自社環境内にとどめ、音声を保存するかどうかを制御できます。
ハイライトに出てくるダイアライゼーションやコンテキストバイアスは、以降の評価結果でも中心的なテーマになっています。なお、音声合成モデルの説明では新機能として「30分以上のサンプル音声からの音声クローン」も挙げられていますが、こちらはPro Voiceとは呼ばれておらず、ハイライトのPro Voiceは基本的な音声クローンでは足りない用途向けと位置づけられています。実際に利用する際の条件は、公式ドキュメントで確認するのが確実だと思います。音声クローンは特定の人物の声を再現する技術であるため、導入時には声の提供者からの同意の取り方や、利用範囲の取り決めも検討事項になると考えられます。
50以上の言語を聞き取る文字起こしモデル「Voxtral Transcribe 3」
Mistral AIによれば、Voxtral Transcribe 3は文字起こし、ダイアライゼーション(いつ誰が話したかの識別)、コンテキストバイアスの各機能で大きな節目となるモデルです。対応言語は50に拡大され、EUの公用語24言語に加え、学習データの少ない低リソースのアジア言語やインドの諸言語が多く含まれます。
上位版のSmallは、英語、フランス語、スペイン語を含む多言語の文字起こしとダイアライゼーションで最先端の結果を達成し、Whisper、Scribe v2、Gemini 3.5 Transcribeを上回るとされています。軽量版のMiniは40億(4B)パラメータのモデルで、毎分0.0035ドルという価格で高速かつ正確な文字起こしができると説明されています。
両モデルとも、コンテキストバイアスに対応しています。重要な用語や自由形式のテキストを与えて文字起こしを誘導し、専門用語の再現率を高める仕組みです。これにより、ファインチューニング(追加学習によるモデルの調整)を行わなくても、分野特有の語彙を扱う本番環境で利用できるとされています。
発表ページでは、文字起こしの評価結果が次の4つのタブに分けて示されています。
- Multilingual Transcription(多言語の文字起こし)
- Diarization(ダイアライゼーション)
- Context Bias(コンテキストバイアス)
- Artificial Analysis(Artificial Analysisによる評価指標)
毎分0.0035ドルを1時間あたりに換算すると約0.21ドルで(本稿による試算)、長時間の通話録音や会議記録をまとめて処理する用途では検討しやすい水準だと思います。コンテキストバイアスについては、製品名、社内用語、顧客名などを事前に渡すだけで認識を改善できる点が、追加学習のためのデータ準備や運用負担を避けたい組織にとって利点になると考えられます。一方で、比較対象のモデルや評価条件はMistral AIが選んだものであり、自社の音声データでも同じ傾向になるとは限らない点には留意が必要だと思います。
多言語文字起こしの評価(FLEURS 45、言語指定と自動判定)
多言語の文字起こしは、FLEURSベンチマークのうち、比較した7つのモデルすべてが対応する45言語を対象に評価されています。指標は単語誤り率(WER: Word Error Rate)のマクロ平均(言語ごとの値を単純平均したもの)で、日本語、韓国語、タイ語、中国語のみ文字誤り率(CER: Character Error Rate)を用いています。いずれも値が低いほど良い指標です。評価は次の2つの条件で行われています。
- Forced: 言語を指定して文字起こしを行う条件
- Inferred: 言語を自動判定させて文字起こしを行う条件
対象の45言語は、言語コードでAR、BN、BG、CA、ZH、CS、DA、NL、EN、ET、FI、FR、DE、EL、GU、HI、HU、IS、ID、IT、JA、KN、KO、LV、LT、MK、MS、ML、MR、NO、FA、PL、PT、RO、RU、SK、SL、ES、SV、FIL、TE、TH、TR、UK、VIです。日本語(JA)も含まれています。各モデルの値はグラフで示されているため、本稿では評価条件の整理にとどめます。
WERは、正解の文と比べて単語の置き換え・脱落・挿入がどれだけ発生したかの割合を示す指標で、日本語や中国語のように単語の区切りが空白で示されない言語では、文字単位のCERが使われるのが一般的です。FLEURSは多数の言語の読み上げ音声を集めた公開ベンチマークとして広く使われています。本稿としては、言語指定と自動判定を分けて示している点に実務上の意味があると考えています。コンタクトセンターのように相手の言語が事前に分からない場面では自動判定(Inferred)側の結果が、言語が決まっている社内会議の記録などでは言語指定(Forced)側の結果が参考になると思います。
話者分離(ダイアライゼーション)の評価
ダイアライゼーションの評価には、連結最小順列単語誤り率(cpWER: concatenated minimum-permutation WER)が使われています。対象は次の公開ベンチマークで、そのマクロ平均が示されています。
- AMI-IHM
- AMI-SDM
- Switchboard
- Switchboard CallHome
- AISHELL-4
Mistral AIによれば、API経由で提供される比較対象との互換性を最大限に保つため、AMIとAISHELLは30分の版を使っています。値は低いほど良い指標です。
cpWERは、話者ごとの発言をつなげたうえで、推定した話者と正解の話者の対応づけが最も有利になる組み合わせでWERを計算する指標です。このため、文字起こしの誤りと話者の取り違えの両方が数値に反映されると考えられます。AMIは会議(IHMは各参加者のヘッドセットマイク、SDMは離れた位置の単一マイクでの収録条件とされます)、SwitchboardやCallHomeは電話での会話、AISHELL-4は中国語の会議を収録したデータセットとして一般に知られており、議事録作成や電話応対の記録といった実際の用途に近い条件を幅広く含んでいると読めます。一方で、30分の版を用いているため、それより長い録音での性能はこの評価からは判断しにくいと思います。
キーフレーズ再現率とコンテキストバイアスの効果
キーフレーズの再現率(重要な語句を正しく書き起こせた割合)は、Earnings 22ベンチマークで、文脈を与える場合と与えない場合を比較しています。
- Without Context: 文脈情報を与えない条件
- With Context: 分野特有の語彙や話者名を文脈として与えた条件
与える文脈には、実際のキーワードに加えて、0〜100個の範囲でランダムに選ばれたダミーの語句(ディストラクター)が含まれます。グラフは2本の棒を重ねた表示で、外側の棒が文脈ありの再現率、内側の棒が文脈なしの再現率を示し、その差がコンテキストバイアスによる上積みを表します。値は高いほど良く、Voxtral Small Transcribe 3はブランドカラーで強調表示されています。
Earnings-22は企業の決算説明会の音声を集めたデータセットとして知られ、企業名や金融用語など、一般的な音声認識が苦手としやすい固有名詞を多く含むと考えられます。ダミーの語句を混ぜて評価している点は、通話に出てくるかもしれない語句をまとめて渡すという実運用のケースを想定していると読めます。渡した語句の一部しか実際には話されない状況でも誤認識を増やさずに機能するかを確かめる設計と考えられ、製品名や顧客名のリストを登録して使う場合の参考になると思います。
Artificial Analysisベンチマーク
独立系のAI評価サイトとして知られるArtificial Analysisの「WER Index」による比較も掲載されています。これは次の3つのデータセットの加重平均で、値は低いほど良い指標です。
- VoxPopuli
- Earnings-22
- AgentTalk
発表ページのこの付近には動画も2本掲載されていますが、内容の説明は付いていません。
ここまでの評価の多くは公開ベンチマークをMistral AI自身が集計した結果ですが、この指標は外部の評価サイトによる点で性格が異なります。VoxPopuliは欧州議会での発言を収録したデータセットとして知られ、決算説明会のEarnings-22と組み合わせることで、性質の異なる音声をまとめて評価する構成になっていると読めます。第三者の指標は比較の公平性を確かめる材料になる一方、重みづけや対象データは評価サイト側の設計に依存するため、自社の用途に近いデータでの確認と併用するのがよいと思います。
リアルタイム文字起こしの評価(FLEURS 35)と発話終了検知
Voxtral Realtime Transcribe 3(料金表やモデル紹介での名称はVoxtral Mini Transcribe Realtime 3)は、エージェント用途向けに作られたリアルタイム文字起こしモデルです。Mistral AIによれば、35以上の言語で500ミリ秒未満の遅延による高品質な文字起こしを実現し、ダイアライゼーションとコンテキストバイアスにも対応します。なお、発表末尾のモデル紹介では「40以上の言語」と記載されており、対応言語数の表記が本文と異なります。
リアルタイム性能は、FLEURSベンチマークの35言語でのWERのマクロ平均(日本語、韓国語、中国語はCER)で評価されています。比較対象のうちVoxtral Mini Transcribe 3はオフライン(非リアルタイム)処理の基準値として掲載され、それ以外のモデルはリアルタイムのモデルです。対象言語は、言語コードでAR、BN、BG、CA、CS、NL、EN、ET、FI、FR、DE、EL、GU、HI、ID、IT、JA、KN、KO、LV、MK、MS、ML、MR、NO、FA、PL、PT、RO、RU、SK、ES、FIL、TE、TRです。
また、発話終了の予測(end-of-turn prediction)にネイティブで対応しています。音響的な情報と意味的な情報の両方を使って、ユーザーが話し終えたかどうかを予測する仕組みで、低遅延の音声エージェントを実現しつつ、ユーザーの発話を途中で打ち切ってしまう誤りを抑えるとされています。
従来の音声エージェントでは、一定時間の無音を検知して話し終わりと判断する方式が多く使われてきたと考えられます。この方式では、冒頭のデモにあるように番号を言いかけて言い直す場面や、考えながら話す場面で、エージェントが早まって応答してしまうことがあります。意味的な情報も使って判断するという設計は、こうした誤った割り込みを減らす狙いがあると読めます。会話の応答では数百ミリ秒単位の遅延の差でも体感に影響しやすいため、500ミリ秒未満という水準は音声エージェントでの利用を意識した設定だと思います。
感情と方言を表現する音声合成モデル「Voxtral Mini TTS 3」
音声合成モデルのVoxtral Mini TTS 3.0は、バッチ処理とリアルタイム処理の両方で利用でき、35以上の言語と50以上の方言で、最先端の表現力と指示追従性能を達成したとMistral AIは説明しています。料金は100万文字あたり13ドルで、OpenAI TTS-1、Deepgram、ElevenLabs Flash、Gemini Flashの同等モデルよりも低いコストで運用できるとされています。なお、発表内ではこのモデルが「Voxtral Mini TTS 3」「Voxtral Speech 3」「Voxtral TTS」とも表記されており、料金表では「Voxtral Speech 3」の名称が使われています。
この音声モデルは文脈の意味をより的確に読み取り、多様な感情や言語で自然な音声を生成するとされます。新たに追加・改善された機能は次のとおりで、いずれも実運用での音声の信頼性を高めることを目的としています。
- 30分以上のサンプル音声からの音声クローン
- カスタムプロンプトによる指示追従(IF: instruction following)
- 文脈を踏まえた音声合成(contextual TTS)
- 語彙ライブラリ
明示的な指示追従(Explicit IF)で指定できる変数として、次の3つが挙げられています。
- `emotion`: 感情
- `pacing`: 話す速さ
- `emphasis`: 強調
Mistral AIは、自然に聞こえる音声はすべて感情に支えられており、感情が韻律(抑揚やアクセント)、リズム、話す速さ、強調、つなぎ方を決めると説明しています。Voxtral TTSはプロンプトのテキストの文脈から感情と声のスタイルをネイティブに判断するため、追加の指示や声のプロンプトがなくても自然な音声を生成しやすいとされています。
発表ページでは、英語、フランス語、イタリア語、ドイツ語の4言語で、通常の読み(Default)と、標準とは異なる読みを音素ヒント(IPAによる発音記号の指定)で与えた場合を聞き比べるデモが掲載されています。
| 言語 | プロンプト(原文) | 対象の語 | 音素ヒント |
| 英語 | Let’s end the debate here: it’s GIF. | GIF | dʒ ɪ f |
| フランス語 | Attends… Ce n’est pas possible. Ce tableau vient de Reims ? Mais alors… C’est celui que ma grand-mère cherchait depuis cinquante ans ! | Reims | ʁ e i m s |
| イタリア語 | Il nostro nuovo assistente si chiama Quivello. | Quivello | tʃ i v ɛ l l o |
| ドイツ語 | Hallo! Ich bin Xyra, deine persönliche Assistentin. | Xyra | z aɪ ɹ ə |
読み方が分かれる略語や、ブランド名・造語のように辞書にない語は、音声合成で誤読が起こりやすい部分だと考えられます。音素ヒントで発音を固定できれば、自社のサービス名やアシスタント名を一貫した読みで案内できるため、ブランドの声を設計するうえで有用な機能だと思います。
音声合成の評価結果は、次の4つのタブに分けて示されています。
- Voice Code Bench
- Pronunciation control(発音制御)
- Multilingual(多言語)
- Expressiveness(表現力)
Voice Code Benchによる価格あたりの品質評価
Voice Code Benchは、BeSimple AIが作成したベンチマークで、企業のカスタマーサポートにおいて数字や固有名詞の読み上げで起こる失敗に焦点を当てています。グラフは価格あたりの品質を比較しており、左上ほど良いとされています(低価格で高品質な位置と読めます)。評価条件は次のとおりです。
- 凡例: Mistral / Other TTS(他社の音声合成)
- 英語のプロンプト300件
- 各システムにつき女性・男性の2音声
- 判定モデル: gemini-3.8-flash
- 価格: 各社の料金ページに基づく
- 生成日: 2026年10月20日
カスタマーサポートでは、口座番号や予約番号、日時、金額を誤って読み上げると業務上の問題に直結しやすく、この観点を独立した評価として扱っている点は実務に近いと考えています。Mistral AI以外の企業が作成したベンチマークを使っている点も、評価の位置づけを判断する材料になると思います。
発音制御の価格あたりの品質評価
発音制御の評価では、狙った語が音素で指定したとおりに発音されたクリップの割合を指標としています。評価条件は次のとおりです。
- 凡例: Mistral / Other TTS
- 英語の文300件で、それぞれに珍しい語または造語を1つ含む(易しい150件、難しい150件)
- 各システムにつき2音声
- 判定モデル: gemini-3.8-flashが、その語の意図したIPA表記とともにクリップを聞いて判定
- 価格: 各社の料金ページに基づく
- 生成日: 2026年10月20日
多言語音声の価格あたりの品質評価
多言語の評価は、11言語での判定スコアの平均を指標とし、各言語・各システムでネイティブの音声を1つずつ使っています。社内評価で、左上ほど良い結果です。11言語未満にしか対応していないシステムは、データには記載されていますが、グラフには描画されていません。評価条件は次のとおりです。
- 凡例: Mistral / Other TTS
- 公開用に選定した377件のプロンプト、11言語
- 言語ごとの平均判定スコアを、重みをつけずに平均
- 1〜5の5段階評価
- 判定モデル: gemini-3.8-flash
- 価格: 各社の料金ページに基づく
- 生成日: 2026年10月20日
言語ごとの平均を単純平均しているため、特定の言語での大きな差が全体の値に埋もれる可能性もあると考えられます。対象の11言語は本文中に明記されていないため、日本語での品質を確かめたい場合は、実際の文章で試すのが確実だと思います。
表現力のある英語音声の価格あたりの品質評価
表現力の評価は、英語の評価セット「one_eval」から公開用に選定した237件のプロンプトでの平均判定スコアを指標としています。社内評価で、左上ほど良い結果です。評価条件は次のとおりです。
- 凡例: Mistral / Other TTS
- 公開用に選定した237件のプロンプト
- 各システムにつき2音声(Voxtral TTSはSarahとJames)
- 1〜5の5段階評価
- 判定モデル: gemini-3.8-flash
- 価格: 各社の料金ページに基づく
- 生成日: 2026年10月20日
ここまでの4つの評価のうち3つは社内評価で、判定にはいずれもAIモデル(gemini-3.8-flash)が使われています。AIによる自動判定は大量の音声を一定の基準で採点できる一方、人間の聞き手の受け止め方と必ずしも一致しない可能性があります。本稿としては、これらの結果は限られた条件での比較として受け止め、価格あたりの品質という観点の目安として参照するのがよいと考えています。
Voxtral 1との比較に見る改善点(表現力・数字・固有名詞)
発表ページでは、表現力、数字、固有名詞の読み上げについて、Voxtral 1とVoxtral 3の出力を聞き比べるデモが4つのシナリオで掲載されています。
| シナリオ | プロンプト(原文) | 主な確認点 |
| Customer Support | Thank you for calling Mistral! I understand you’re having difficulty logging into AI Studio. Can I confirm your email address? I have here [email protected], is that correct? | メールアドレスの読み上げ |
| Personal agent | Gosh that was quick, I’ve found a flight for your upcoming travel. How about the Emirates flight at 21:00pm on 10/10 returning 10/25 at 22:00pm for £1881? Say the word, and I’ll book a window seat now. | 時刻・日付・金額の読み上げ |
| Excited | Wow I can’t believe you’re pregnant! This is so exciting, congratulations Corina, I’m so happy for you! | 喜びの感情表現 |
| Angry | What do you mean my passport won’t be finished this week — I’ve told you several times how I need to go to Paris for work. This is ridiculous. I can’t even begin to describe how infuriating this has been. | 怒りの感情表現 |
各プロンプトには、出力音声を書き起こしたと見られるテキストが2つずつ添えられています。たとえば航空券のシナリオでは、一方が「21,000pm」「10 over 10」のように時刻や日付を誤って読み上げているのに対し、もう一方は「October 10th」「October 25th」のように日付として読み上げています。掲載順からは、前者がVoxtral 1、後者がVoxtral 3の出力と読めます。メールアドレスのシナリオでは、どちらも「elena.vance82 @ yahoo.com」と書き起こされており、句読点の扱いなど細部に差が見られます。
プロンプト自体も「21:00pm」のように24時間表記と午前・午後の表記が混在しており、不自然な入力に対する頑健さも試す内容になっていると考えられます。言語モデルが出力する文章には、数字や記号、略記がそのまま含まれることが多いため、音声エージェントでは「10/10」を日付として読むといった読み上げ前の解釈が品質を左右しやすいと思います。
35言語・50以上の方言でのローカルな発話
Mistral AIによれば、Voxtral TTSは35以上の言語と地域の方言に対応しています。多言語の評価では、方言ごとの次のような違いに沿って評価しているとされます。
- 発音
- 丁寧な言い方とくだけた言い方の使い分け
- 綴り
- 言葉数の多さ(冗長さ)
- 地域の慣習(時刻、日付、気温、住所、通貨の表記)
発表ページの「Voxtral 3 multilingual library」では、Europe、Americas、Middle East and Africa、Asia-Pacificの4地域に分けて対応言語が紹介されています。掲載されている言語名と方言のラベルは次のとおりです。
- 言語: English、French、Spanish、Catalan、Dutch、German、Hungarian、Italian、Norwegian、Polish、Romanian、Russian、Turkish、Ukrainian、Portuguese、Arabic、Chinese、Hindi、Japanese、Korean、Vietnamese
- 方言のラベル: British、France、Spain、American、Brazilian、Beijing、Sichuan
また、ボイスプリセット(あらかじめ用意された音声)は18言語で提供されるとされ、次の言語が列挙されています。
- Arabic(Emirati、Modern Standard)
- Brazilian(Portuguese)
- Catalan
- Chinese(Mandarin)
- Dutch
- English(American、British)
- French(France)
- German
- Greek
- Hindi
- Italian
- Korean
- Norwegian
- Russian
- Spanish(Spain)
- Vietnamese
日本語は対応言語のライブラリには含まれていますが、ボイスプリセットの列挙には含まれていません。また、列挙されている項目は16件で「18言語」という表記と数が一致しないため、日本語で利用する際の音声の選択肢は公式ドキュメントで確認するのが確実だと思います。日付や通貨の読み方といった地域の慣習まで評価対象にしている点は、日本語のように元号表記や助数詞の読み分けがある言語でも重要な観点だと考えています。
会話全体を制御する音声エージェントSDK
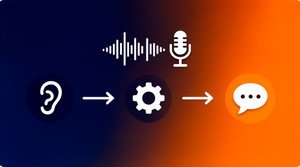
Voxtral 3では、LiveKit上に構築された音声エージェントSDKが導入されました。音声の入力、推論、音声の出力を1つのストリーミング処理として実行する仕組みで、各段の役割は次のとおりです。
- 聞く: Voxtral Mini Transcribe Realtime 3が音声を聞き取り、話し手が話し終えたことを検知する
- 考える: Mistral Smallのような汎用モデルが推論し、ツールを呼び出す
- 話す: Voxtral Speech 3が、それまでの会話のトーンに合わせて応答する
Mistral AIによれば、どの段も前の段の完了を待たずに処理を進めるため、各ターンは1秒未満で完了し、相手が話をさえぎるとエージェントは話すのを止めます。通話中には、関数呼び出し(Function Calling)、Web検索、自社システムに対する検索(リトリーバル)を使って、本人確認、請求内容の確認、予約といった操作ができるとされています。外部との接続方法は次のとおりです。
- SIP: 電話の着信に応答し、発信も行う
- WebRTC: ブラウザやアプリ上で動作する
- 既存のシステム: すでに利用している電話システム、IVR、コンタクトセンター向けソフトウェアと接続する
各段は独立したモデルで構成されているため、エージェントを作り直すことなく、LLM、音声、言語を個別に変更できます。また、スタック全体を欧州のMistral API上でも、自社インフラ上でも実行できるとされています。
LiveKitは、音声や映像のリアルタイム通信アプリケーションを構築するためのオープンソースのフレームワークとして知られています。SIP(Session Initiation Protocol)はIP電話で通話を確立するための標準的な仕組み、IVR(自動音声応答)は番号入力などで用件を振り分ける電話の自動案内、WebRTCはブラウザ間でリアルタイムに音声や映像をやり取りする技術を指します。
音声を直接入力して音声を直接出力する単一モデルの方式と比べると、聞く・考える・話すを別々のモデルで構成する方式は、遅延が増えやすい代わりに、推論モデルの差し替えやツール連携の自由度が高いという特徴があると考えられます。Voxtral 3は、各段を待たせない設計で遅延の課題を抑えようとしていると読めます。本人確認や請求確認のように個人情報を扱う操作をエージェントに任せる場合は、ツールに与える権限の範囲や、人間の担当者へ引き継ぐ条件を事前に設計しておくことが重要だと思います。
提供開始と料金体系
Voxtral 3は、発表当日からMistral APIを通じて提供されており、欧州、米国、グローバルのエンドポイントでホストされています。Studioのプレイグラウンドでは、次の機能を試せます。
- 音声エージェント
- 音声の文字起こし
- 音声の生成
- 音声クローン
料金は次のとおりです。
| モデル | 料金 |
| Voxtral Mini Transcribe 3(バッチ) | 毎分0.0035ドル |
| Voxtral Mini Transcribe Realtime 3 | 毎分0.008ドル |
| Voxtral Small Transcribe 3 | 毎分0.0040ドル |
| Voxtral Speech 3(バッチ・リアルタイム共通、同一API) | 100万文字あたり13ドル |
| 音声エージェントAPI(推論にMistral Small 4を使用) | 毎分0.04ドル |
| 音声エージェントAPI(その他の推論モデルを使用) | 毎分0.08ドル |
オンプレミスやプライベートクラウドでスタック全体を運用したい場合は、Mistral AIのチームへの問い合わせが案内されています。発表ページ末尾のモデル紹介では、各モデルが次のように位置づけられています。
| モデル | 位置づけ | 区分 | 料金 |
| Voxtral Small Transcribe 3(New) | 最も高精度な文字起こしモデル。50以上の言語での多言語文字起こしとダイアライゼーションで最先端とされ、コンテキストバイアスに対応 | Transcription / Audio | 毎分0.004ドル |
| Voxtral Mini Transcribe 3(New) | 効率的で低遅延な文字起こしモデル。50以上の言語で多言語文字起こし、ダイアライゼーション、コンテキストバイアスに対応 | Transcription / Audio (Batch) | 毎分0.0035ドル |
| Voxtral Mini Transcribe Realtime 3 | エージェント用途向けのリアルタイム文字起こしモデル。40以上の言語で500ミリ秒未満の遅延 | Transcription / Audio | 毎分0.008ドル |
| Voxtral Speech 3 | 35以上の言語と50以上の方言で最先端の表現力と指示追従 | Voice / Input | 100万文字あたり13ドル |
料金表をもとに1時間あたりに換算すると(本稿による試算)、文字起こしはMiniのバッチ版で約0.21ドル、Smallで約0.24ドル、リアルタイム版で約0.48ドル、音声エージェントAPIはMistral Small 4を使う場合で約2.4ドル、その他の推論モデルを使う場合で約4.8ドルです。音声合成は1,000文字の応答で約0.013ドルの計算です。ただし、料金表からは音声エージェントAPIの料金に文字起こしや音声合成の費用が含まれるかどうかが読み取れないため、見積もりの際は公式の料金ページで条件を確認する必要があると思います。また、発表ではEU域内でホストされるAPIが強調されていますが、提供開始時点では米国やグローバルのエンドポイントもあるため、データの所在地を重視する場合はどのエンドポイントを使うかが検討事項になると考えられます。
まとめ
Voxtral 3は、50以上の言語に対応する文字起こし、感情を表現する音声合成、LiveKit上の音声エージェントSDKを組み合わせ、聞く・考える・話す・行動するを1つの流れで扱う構成です。性能評価には社内評価も多く含まれるため、本稿としては、日本語を含む自社の用途で試しながら検討するのがよいと考えています。