はじめに
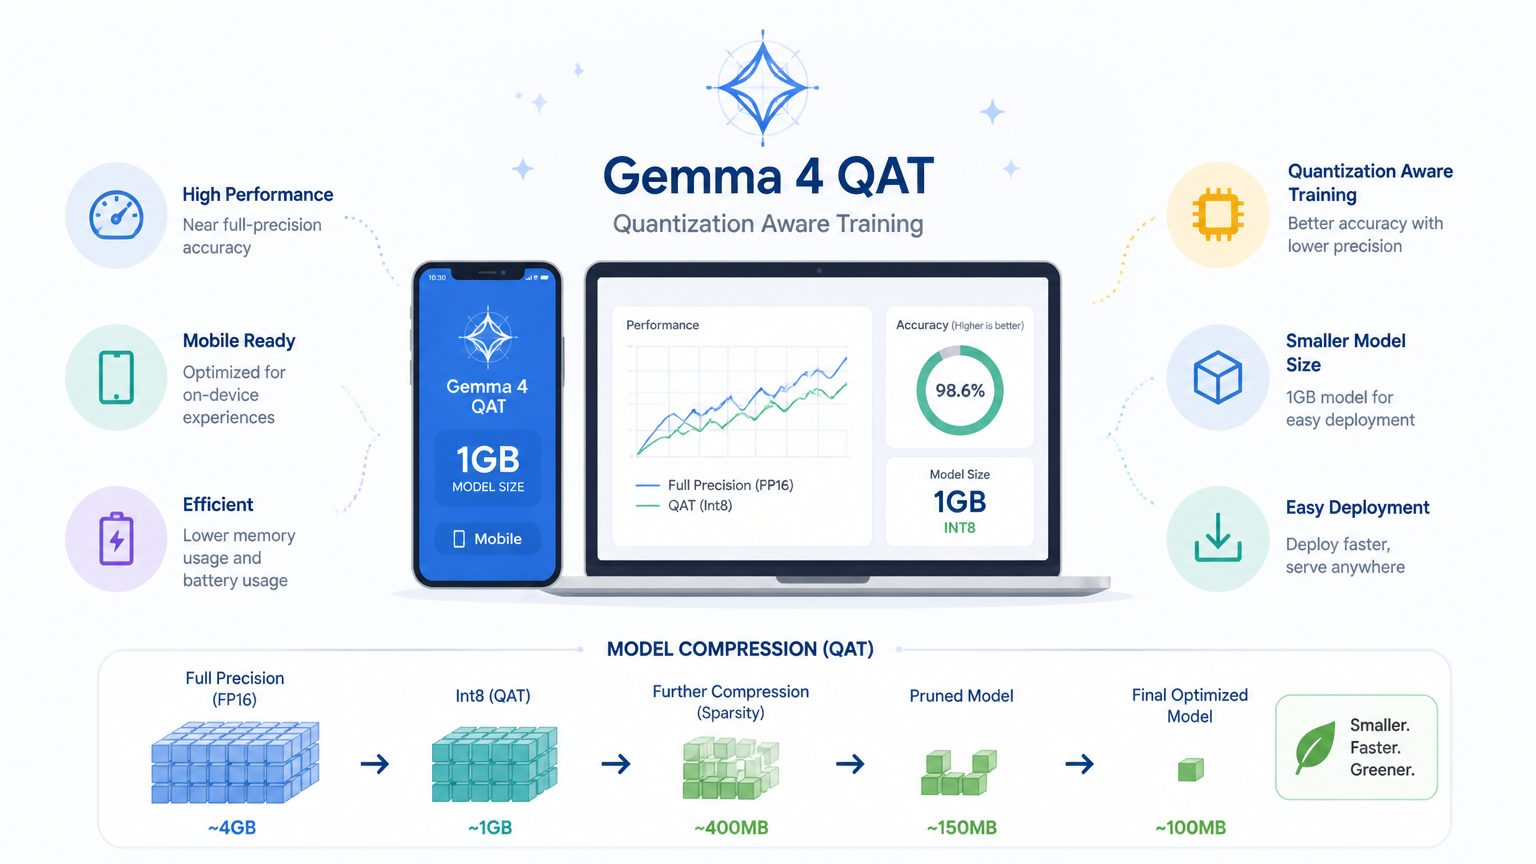
Google DeepMindが2026年6月5日、Gemma 4ファミリーを量子化対応トレーニング(QAT)で最適化した新チェックポイントを公開しました。本稿では、QATがなぜ通常の量子化より優れるのか、モバイル向けに施された工夫の中身、そして各種ツールでの利用方法を解説します。
参考記事
- タイトル: Gemma 4 QAT models: Optimizing model compression for mobile and laptop efficiency
- 著者: Olivier Lacombe / Omar Sanseviero
- 発行元: Google DeepMind Blog
- 発行日: 2026年6月5日
- URL: https://blog.google/innovation-and-ai/technology/developers-tools/quantization-aware-training-gemma-4/
関連記事
要点
- Gemma 4 QATは、量子化をトレーニング中に組み込むことで、事後量子化(PTQ)より高い品質を保ちながらメモリ使用量を大幅に削減したモデルチェックポイントである
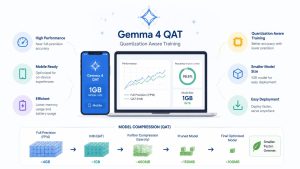
- モバイル向け専用量子化スキーマにより、Gemma 4 E2Bのメモリフットプリントを 1GB未満 に削減することに成功している
- 静的アクティベーション・チャネルワイズ量子化・ターゲット2ビット量子化・埋め込みとKVキャッシュの最適化という4つの技術をモバイル向けに組み合わせている
- Q4_0形式(GGUF)はllama.cpp・Ollama・LM Studioなどのデスクトップ環境で即利用可能であり、モバイル形式はLiteRT-LMやTransformers.jsで展開できる
詳細解説
QATとは何か——PTQとの違い
量子化(Quantization)とは、モデルのパラメータを低ビット精度に変換することでメモリ使用量を削減し、推論を高速化する技術です。最も一般的なアプローチは PTQ(Post-Training Quantization:事後量子化) で、学習済みモデルをそのまま圧縮します。手軽に適用できる反面、精度が低下するケースがあります。
今回Google DeepMindが採用した QAT(Quantization-Aware Training:量子化対応トレーニング) は、トレーニングのプロセス自体に量子化のシミュレーションを組み込む手法です。Google DeepMindの発表によれば、QATを適用することで標準的なPTQベースラインよりも高い全体品質が得られたとのことです。圧縮後の挙動を学習段階から考慮しているため、モデルが量子化によるノイズに対して頑健になると考えられます。
なお、Gemma 4ファミリーではこれ以前にも MTPドラフターによる推論高速化 が導入されており、今回のQATはその延長線上にある効率化施策と位置づけられます。
モバイル向け量子化スキーマの4つの工夫
Google DeepMindは、標準的な圧縮フォーマットがモバイルプロセッサでは効率よく動作しにくいという課題に対応するため、エッジハードウェア向けの独自量子化スキーマを設計しました。主な工夫は以下の4点です。
① 静的アクティベーション(Static activations)
通常のモデルは推論中にデータのスケールをその都度計算しますが、この手法ではスケール設定をトレーニング中に事前計算します。モバイルチップの処理負荷が軽減され、応答速度の向上につながります。
② チャネルワイズ量子化(Channel-wise quantization)
圧縮データをモバイルアクセラレータの設計に合わせて構造化します。これにより、低速な変換処理を挟まずにネイティブで計算を実行できます。
③ ターゲット2ビット量子化(Targeted 2-bit quantization)
トークンを生成する部分(ここは非常に容量を占める)を2ビットまで強く圧縮しつつ、コアとなる推論レイヤーは高い精度を維持します。ストレージを削減しながらモデルの「考える力」を保つ設計です。
④ 埋め込みとKVキャッシュの最適化(Embedding and KV cache optimization)
KVキャッシュとは、会話の文脈を保持するための短期メモリにあたる仕組みです。語彙リスト(埋め込み)とこのKVキャッシュに圧縮を集中させることで、アクティブメモリのフットプリントを大幅に削減しています。長い会話でもメモリ不足になりにくくなります。
これらを組み合わせることで、Gemma 4 E2Bのテキスト専用モデル(Per-Layer Embeddingsなし)は 1GB未満 のメモリで動作するとのことです。また、音声・ビジョンエンコーダは用途に応じて省略できるため、必要なモダリティだけを展開してさらにメモリを節約することも可能です。
対応フォーマットと入手方法
今回のQATチェックポイントはHugging Faceで公開されており、用途に応じて2種類が提供されています。
Q4_0形式(デスクトップ・サーバー向け)
GGUF形式で提供されており、llama.cppと組み合わせてすぐに利用できます。以下のツールで手軽に試せます。
- llama.cpp : GGUF形式をそのまま利用可能
- Ollama : ollama pull gemma4 でモデルをローカルに取得できます
- LM Studio : GUIでモデルを選択してダウンロードするだけで動作します
- vLLM / SGLang : サーバー側での大規模モデル配信に対応
注意: 各ツールのバージョンによってはQAT対応の最新版が必要な場合があります。ollama –version や各ツールのリリースノートを確認してください。
モバイル形式(エッジ・オンデバイス向け)
- LiteRT-LM : GoogleのエッジAIランタイムLiteRTのLLM向けランタイムです。LiteRTは2026年1月に正式リリースされており、GPUやNPUを活用した最適化が施されています。
- Transformers.js : ONNX形式でウェブブラウザ上でも動作可能です。Hugging Faceの onnx-community/gemma-4 コレクションから取得できます。
その他の開発ツール
- Hugging Face Transformers + Unsloth : QATチェックポイントをそのまま使ったファインチューニングが可能です
- MLX : Apple Siliconに最適化されたフォーマットが提供されています
- MTP + QAT組み合わせ : MTPドラフターのQATチェックポイントも提供されており、推論高速化と量子化の両方を同時に享受できます
Ollama・LM Studioでの基本的な使い方
最も手軽に試すにはOllamaが便利です。以下の手順で動作確認ができます。
前提条件
- Ollama がインストール済みであること(ollama –version で確認)
- 十分なディスク容量(Q4_0形式のE2Bモデルで数GB程度)
# Gemma 4 QATモデルをダウンロードして起動するコマンドです
# gemma4 タグが最新のQATチェックポイントに対応しています
ollama run gemma4
注意: モデル名・タグはOllamaの公式ライブラリページ(https://ollama.com/library/gemma4)で最新情報を確認してください。リリース直後はタグが更新途中のことがあります。
LM Studioの場合は、GUIの検索バーで「Gemma 4 QAT」と入力してモデルを選択し、ダウンロードボタンを押すだけで利用できます。VRAM量の表示がモデル選択の参考になります。
まとめ
Gemma 4 QATは、量子化をトレーニング段階から組み込むことで品質を保ちつつ、モバイル向けの独自スキーマでメモリを1GB未満まで圧縮した点が特徴です。llama.cppやOllamaなど使い慣れたツールからすぐに試せます。オンデバイスAIの実装を検討している方は、LiteRTの概要についても整理していますので、あわせてご覧いただければと思います。