はじめに
IBMのSanchita Chakraborti氏が2026年5月1日に公開した記事で、高速リリースを続けるエンジニアリングチームが陥りやすい「レジリエンスの断片化」と、それを解消する新しい考え方「レジリエンスポスチャー」が解説されています。本稿では、その概念と実践的な意味を紐解きます。
参考記事
- タイトル: From reactive to engineered: Resilience posture for teams that ship fast
- 著者: Sanchita Chakraborti
- 発行元: IBM Think
- 発行日: 2026年5月1日
- URL: https://www.ibm.com/think/insights/resilience-posture-for-teams-that-ship-fast
関連記事

要点
- 継続的デリバリーやマイクロサービスの普及により、リリースサイクルが短縮される一方でシステムの複雑性が増し、レジリエンス(障害耐性・回復力)の管理が後回しにされやすい構造的課題がある
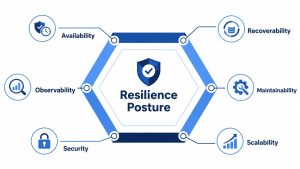
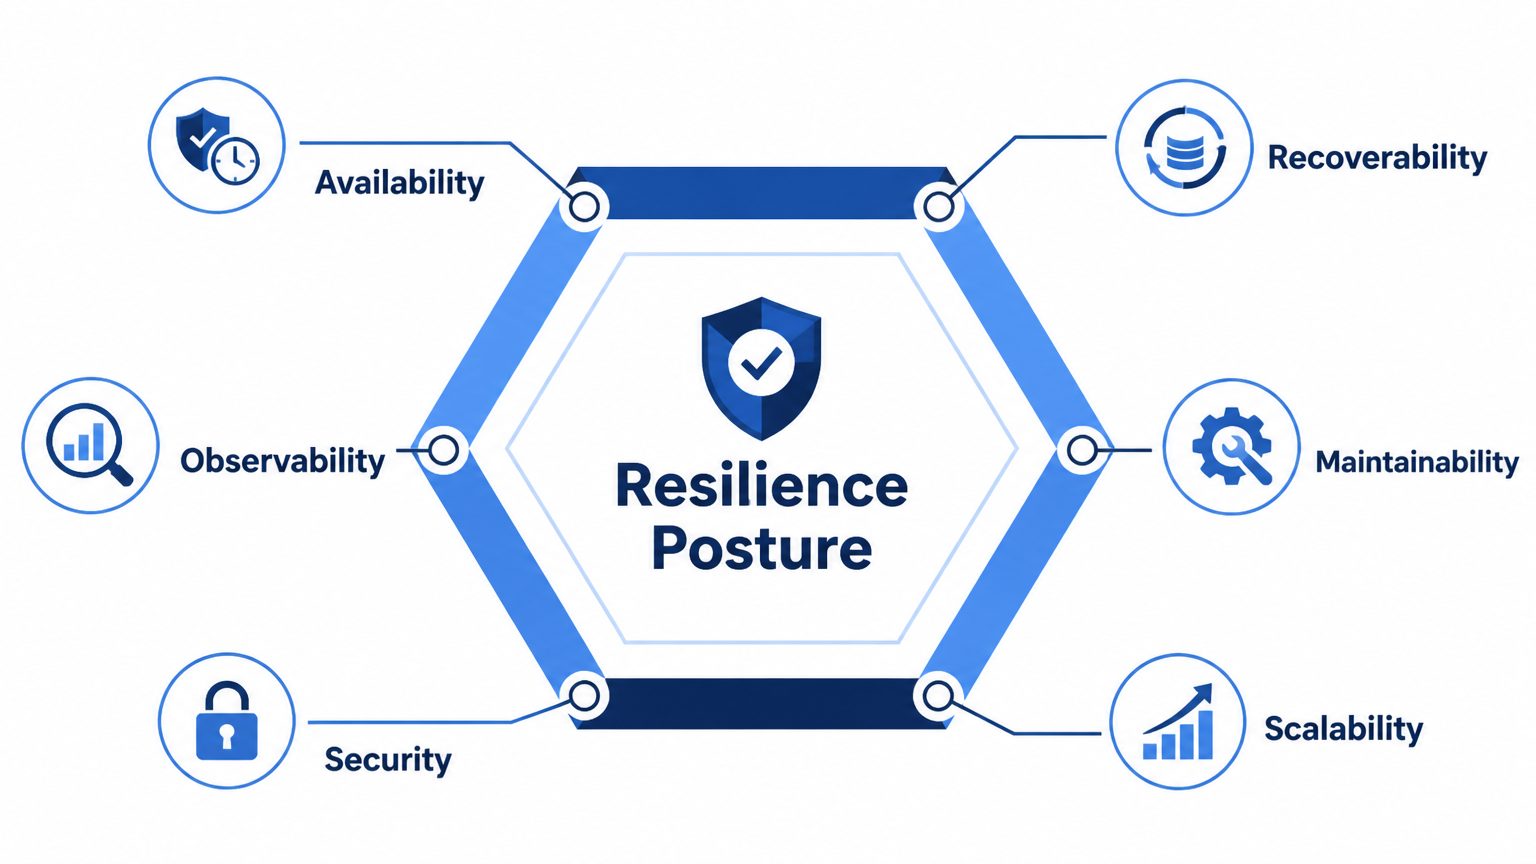
- IBMは「レジリエンスポスチャー」という概念を提唱し、可用性・回復性・可観測性・保守性・セキュリティ・スケーラビリティの6軸でシステムを継続的に評価するフレームワークを示している
- 各チームが個別のメトリクスで動いている「断片化」状態では、インシデント発生時に原因の特定が遅れ、対応が属人化するリスクが高まる
- IBMのツール「IBM Concert」は複数の環境からデータを収集・統合し、単一のレジリエンスポスチャースコアとして可視化・自動評価することを目的としている
- レジリエンスポスチャーの導入により、「壊れていないが脆い」状態をインシデント発生前に検出し、先手を打った対策が可能になると説明されている
詳細解説
なぜ速いチームほど壊れやすいのか
現代のエンジニアリングチームは、継続的デリバリー(CD)パイプラインやマイクロサービス、ハイブリッドクラウドを活用して、かつては数ヶ月かかっていたリリースサイクルを数日・数時間単位まで短縮しています。速度はもはや競争優位ではなく、前提条件となっています。
IBMによれば、このスピードの代償として、各リリースが新たな依存関係と障害点を積み重ねる構造が生まれています。チームは速度を最優先に最適化し、レジリエンス(障害耐性・回復力)は後回しになりがちです。インシデントが起きて初めて、その問題が表面化します。
さらに深刻なのは「断片化」の問題です。開発者はコードと依存関係に集中し、SRE(サイト信頼性エンジニア)は稼働率を、インフラチームはリソース管理を、セキュリティチームは脆弱性をそれぞれ別々に監視しています。各チームが価値あるシグナルを出しているにもかかわらず、それらは別々のシステムに存在し、個別に解釈されます。この結果、インシデント発生時には「何が変わったのか」という基本的な問いへの回答に、複数のチームが数時間を費やすことになります。
AIによるアラート管理でこの課題を整理した記事でも触れましたが、問題の本質はデータ量ではなく、システム全体を横断した統合的な視点の欠如にあります。
「レジリエンスポスチャー」とは何か:6つの評価軸
IBMが提唱する「レジリエンスポスチャー」は、レジリエンスを単発のチェック活動から、継続的に評価・改善する「ケイパビリティ(組織能力)」へと転換する概念です。
IBM Concertはこのモデルを以下の6つの軸で評価します。
- 可用性(Availability):必要なときに稼働しているか
- 回復性(Recoverability):障害から迅速に回復できるか
- 可観測性(Observability):内部で何が起きているかを理解できるか
- 保守性(Maintainability):安全に変更を加えられるか
- セキュリティ(Security):脅威から保護されているか
- スケーラビリティ(Scalability):需要の急増に対応できるか
この6軸の枠組みにより、チームごとにバラバラだった「レジリエント(障害に強い)」の定義が統一されます。「稼働しているか?」という断片的な問いに代わり、「このアプリケーションはエンドツーエンドでどれほど障害に強いか?」という包括的な問いが持てるようになります。
特に興味深いのは「壊れていないが脆い」状態の可視化です。記事中の例として、決済サービスのダッシュボードが99.9%の稼働率を示し、すべてのモニタリングがグリーンである状況が挙げられています。しかしレジリエンスポスチャーで評価すると、45秒の回復時間、未パッチの依存関係、未テストのフェイルオーバーというリスクが露わになります。従来の監視ツールでは見えなかった「潜在的脆弱性」を事前に検出できる点が、この概念の核心だと思います。
断片化から統合へ:チームをつなぐ「単一の真実源」
レジリエンスポスチャーの実装において中心的な役割を果たすのが、「単一の真実源(Single Source of Truth)」の構築です。IBMによれば、IBM Concertはパブリッククラウド、プライベートデータセンター、エッジ環境など複数の環境からデータを収集・統合し、単一のレジリエンスビューとして提示します。
これにより、開発者・SRE・運用チーム・ビジネスリーダーが共通の理解のもとで意思決定できるようになります。判断の根拠が個別のメトリクスや主観的な解釈ではなく、共有されたデータ駆動の基盤となります。
また、標準化の観点も重要です。チームごとに異なる閾値や優先順位が設定されると、時間とともに一貫性が失われます。IBMは、レジリエンス要件を一度定義してすべてのアプリケーションに適用することで、「誰が構築・運用しても同じ基準をクリアしている」状態を実現できると説明しています。速度と一貫性はトレードオフではなく、相互に強化し合う関係になると考えられます。
自動化がレジリエンスを現実のものにする
断片化したデータを手動で統合する評価プロセスは、高速リリース環境では現実的ではありません。IBM Concertはデータの収集・統合・分析を自動化し、リアルタイムのインサイトを継続的に提供します。これにより、定期的なスポットチェックではなく、常時評価が可能になります。
この自動化の恩恵は、シグナルから意思決定への橋渡しにも表れます。従来のオブザーバビリティツールはメトリクス・ログ・トレースといったシグナルを生成しますが、それをどう解釈してどう行動するかはエンジニアに委ねられていました。レジリエンスポスチャーは、シグナルを標準化されたフレームワーク内で文脈付けすることで、「何が起きているか」だけでなく「なぜ重要で、何をすべきか」という優先付きアクションとして提示します。意思決定の認知負荷を下げ、対応速度を高める効果が期待できます。
ビジネスへの影響:インシデント対応から先手の投資へ
IBMによれば、レジリエンスはもはや技術的な問題ではなく、ビジネス上の必須事項です。ダウンタイムはカスタマーエクスペリエンスを損ない、収益を失わせ、ブランドの信頼を傷つけます。
記事中では、ブラックフライデーのEコマースを例に挙げています。決済依存関係に問題が発生してチェックアウトが機能しなくなり、複数チームがサイロ状態で対応に追われ、数時間後には収益と信頼の両方が失われるシナリオです。これに対してレジリエンスポスチャーが整備されていれば、ピークトラフィック前の段階で依存関係のパッチ適用・フェイルオーバーの強化・回復の自動化が完了しており、問題は「発生しなかった」イベントになります。
ビジネスリーダーにとっての実用的な意味は、「稼働しているか?」から「ストレス下でどれだけ耐え、どれだけ早く回復できるか?」へと問いが変わることです。スコア化されたポスチャーは投資の優先付けを可視化し、レジリエンスを収益保護・顧客体験・ブランド資産と直接結びつけた経営指標として機能すると思います。
まとめ
IBMが提唱するレジリエンスポスチャーは、高速リリース環境における「断片化した監視」の限界を乗り越えるための概念的・技術的枠組みです。6軸評価・単一真実源・自動化の組み合わせにより、レジリエンスを事後対応から継続的なエンジニアリング能力へと転換することを目指しています。「壊れてから直す」ではなく「壊れる前に測って投資する」文化への移行が、今後の開発組織の競争力に直結する可能性があります。DevOpsの速度と安定性をどう両立させるかという問いについては、AIエージェントがDevOps全体を最適化するアプローチもあわせてご覧いただければと思います。