はじめに
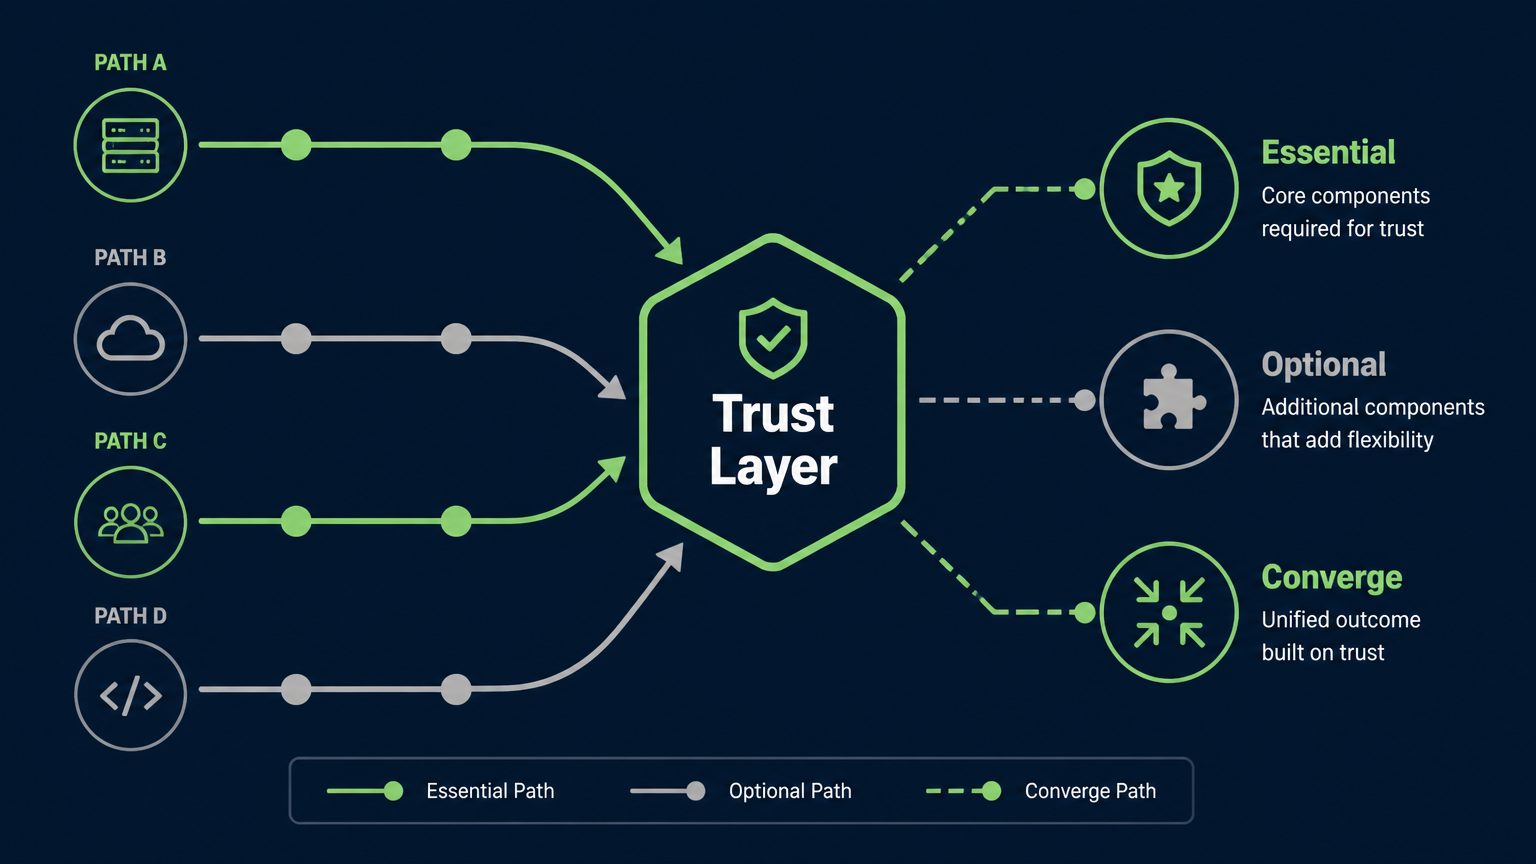
GitHub BlogでGaurav Mittal・Reshabh Kumar Sharmaが2026年5月6日に公開した技術記事では、GitHub Copilot Coding Agentのような自律エージェントを対象とした新しいテスト検証フレームワーク「Trust Layer」が紹介されています。本稿では、その設計思想と精度評価の結果を中心に解説します。
参考記事
- タイトル: Validating agentic behavior when “correct” isn’t deterministic
- 著者: Gaurav Mittal, Reshabh Kumar Sharma
- 発行元: GitHub Blog
- 発行日: 2026年5月6日
- URL: https://github.blog/ai-and-ml/generative-ai/validating-agentic-behavior-when-correct-isnt-deterministic/
関連記事
要点
- 従来のアサーションベース・リプレイ型テストは「実行経路が固定」という前提に依存しており、正しく完了したエージェント実行でもテストが失敗する「偽陰性」問題が構造的に発生する
- コンパイラ理論の「ドミネータ解析」を応用することで、すべての成功実行が必ず通過する「必須状態」と、ローディング画面などの「任意の変動」を自動的に区別できる
- 実行トレースをPTA(接頭辞木アクセプタ)グラフとして表現し、2〜10件の成功例から「正解モデル」を自動構築する。手動仕様の記述もMLモデルの大規模学習も不要である
- 精度評価では、エージェント自己評価(CUA)の正解率82.2%・再現率60.0%に対し、ドミネータツリー手法はすべての指標で100%を達成した
- GitHub Actions・回帰テスト・UIオートメーション等に統合可能で、「必須マイルストーンを達成したか」を外部構造から説明可能な形で検証できる
詳細解説
従来テストが「エージェント」に対して機能しない理由
自律エージェントが広く使われるようになった現在、テスト設計の根本的な前提が問われています。GitHub Blogの記事では、GitHub Copilot Coding Agentを例として、従来のテスト手法が抱える4つの限界が整理されています。
アサーションベースのテストは、あらかじめ定義したチェック項目をすべて手動で記述する必要があり、有効な代替実行経路を考慮できません。リプレイ型ツールは微細なレンダリング差異やタイミングのずれに過敏で、記録時と異なるUIの状態が現れるだけで失敗を報告します。ビジュアルリグレッションテストはスクリーンショットを単独で比較するため、実行フロー全体の意味を捉えられません。そしてMLオラクルはブラックボックスであり、大量の学習データを必要とするうえに判断の根拠を説明できません。
これらに共通するのは「正しさ=特定の状態の連続」という仮定です。しかしエージェントは環境の変化に適応しながら同じ目的を達成するため、実行経路が毎回異なることが本質的な特性です。記事では、ネットワーク遅延によるローディング画面の有無を例に挙げ、「エージェントは成功したが、テストは失敗した」という偽陰性のシナリオを具体的に示しています。
「必須状態」と「任意状態」を分ける概念的転換
GitHubのチームはこの問題を解決するために、まず「正しさの定義」を見直しました。エージェントが行う検索操作を例にとると、ローディング画面が表示されるかどうかは実行環境次第で変わります。しかし検索結果画面は、どの経路をたどっても必ず到達しなければ成功とは言えません。
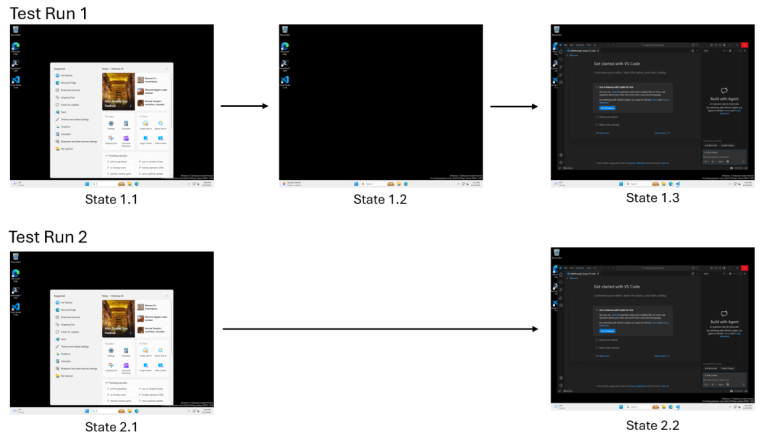
この「必須かどうか」の区別は、コンパイラ理論における ドミネータ関係 で形式的に定義できます。制御フローグラフにおいて、状態Aが状態Bを「支配(dominate)する」とは、スタートから Bへ至るすべての経路がAを通過することを意味します。エージェントの実行トレースにこの概念を適用することで、「必ず通過しなければならない必須状態」と「通過しないこともある任意状態」を数学的に特定できます。
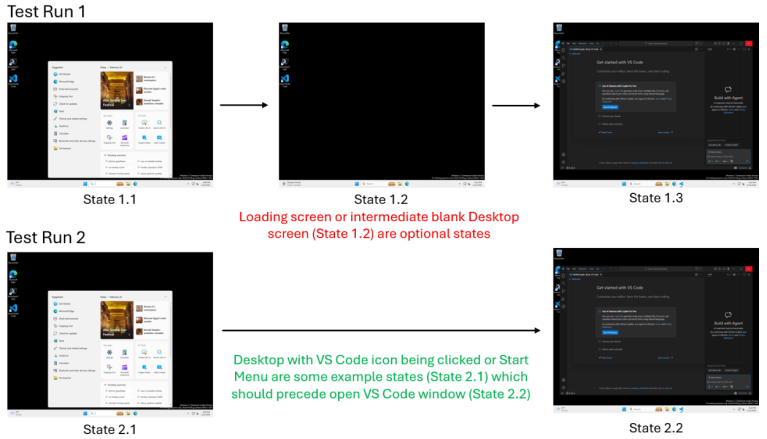
ローディング画面は高速な実行ではスキップされるため、ドミネータではなく任意状態として分類されます。一方、検索ダイアログは検索結果に到達する唯一の入口であるため、必須状態と判定されます。この分類が、Trust Layerの中核的な判断基準になっています。
PTAグラフとセマンティック統合による「正解モデル」の構築
フレームワークの技術的な実装は3段階で構成されます。まず、2〜10件の成功実行を収集し、それぞれをPTA(Prefix Tree Acceptor)と呼ばれる有向グラフに変換します。ノードが「UI状態(スクリーンショット等)」、エッジが「状態遷移(クリック・入力等)」に対応します。
次に、複数のPTAをひとつの統合グラフにマージします。ここで「2つの状態が論理的に同等かどうか」という判断が必要になります。GitHubが採用したのは3段階の等価判定フレームワークです。まず知覚的ハッシュとSSIM(構造的類似度)によるビジュアル類似判定で高速に処理し、視覚的な判断が困難な場合にのみマルチモーダルLLMによるセマンティック分析に委ねます。LLMはタイムスタンプの変化やウィンドウ装飾の差異を無視しつつ、エラーメッセージの変化や欠落したUIコントロールを確実に検出します。状態の同一性が確認できた場合のみマージを行い、経路が実際に分岐している箇所はグラフ上にそのまま保持します。
最後に、マージされたグラフにドミネータ解析を適用し、「本当に必要な状態だけを含んだ骨格」であるドミネータサブツリーを抽出します。これが検証の際の「正解モデル」として機能します。
新しい実行を検証する仕組みと精度評価
正解モデルが構築されると、新しい実行トレースの検証は「トポロジカル部分列照合」で行われます。参照経路A→B→Cに対して、エージェントがA→X→B→Y→Cという経路をたどった場合、追加状態(X・Y)は任意変動として無視され、テストは合格となります。必須状態がスキップされた場合、または順序が乱れた場合にのみ失敗が報告されます。
精度評価では、エージェント自身の自己評価(CUA)とドミネータツリー手法を比較しています。VS Codeの拡張機能テストスイートを対象とした実験の結果は以下のとおりです。
| 指標 | CUA自己評価 | PTA(ドミネータツリー) |
| 正解率 | 82.2% | 100%(+17.8) |
| 適合率 | 83.3% | 100%(+16.7) |
| 再現率 | 60.0% | 100%(+40.0) |
| F1スコア | 69.8% | 100%(+30.2) |
特に注目すべきは「Not a Bug(環境ノイズによる失敗)」の識別です。エージェントの自己評価はこのシナリオをまったく識別できず(F1スコア0%)、ドミネータツリー手法は52.2%のF1スコアで識別に成功しています。これは「エージェントは自分の成否を正確に報告できない」ことを示しており、外部からの構造的検証が不可欠だという根拠になっています。
現在の制約と今後の方向性
記事では、現行フレームワークの限界も率直に示されています。「例から学習する」設計上、2〜10件の成功例がなければ正解モデルを構築できません。また、セマンティック等価判定にマルチモーダルLLMを用いるため、外部API依存と遅延が発生します。さらに、状態の「順序」は検証できますが、ローディング画面が過度に長引くなどの「時間的制約」には現時点で対応していません。
今後の課題としては、タイミング要件の検証(「5秒以内にローディングが解消されること」等)、失敗例からの学習、DOMや accessibility treeなどの非視覚シグナルとの統合、そしてオンライン学習による正解モデルのリアルタイム更新が挙げられています。
まとめ
本記事では、GitHub Copilot Coding Agentの検証フレームワーク「Trust Layer」を紹介しました。ドミネータ解析という古典的なコンパイラ理論を活用し、エージェントが「必須マイルストーン」を達成したかを構造的・説明可能な形で検証する点が特徴です。自律エージェントがCI/CDパイプラインの中核に入り込んでいく局面で、こうした「外部からの構造的保証」の設計がますます重要になると思います。エージェントの評価手法の変遷については、Cursorのエージェントハーネス設計と評価アプローチを取り上げた記事もあわせてご覧いただければと思います。