はじめに
Cursorが2026年4月30日に公開したブログ記事で、AIコーディングエージェントの品質を左右する「エージェントハーネス」の継続的改善プロセスを詳しく解説しています。コンテキスト管理の変遷から2層の評価手法、ツールエラーの系統的監視、モデル別カスタマイズまで、その実態を紹介します。
参考記事
- タイトル: エージェントハーネスを継続的に改善する
- 著者: Stefan Heule & Jediah Katz
- 発行元: Cursor
- 発行日: 2026年4月30日
- URL: https://cursor.com/ja/blog/continually-improving-agent-harness
関連記事
要点
- エージェントハーネスのコンテキスト管理は、静的な大量コンテキスト提供からモデルが自律的に取得する動的コンテキスト方式へと進化している
- 品質評価には独自ベンチマーク(CursorBench)とオンラインA/Bテストの2種類を組み合わせ、コードの「Keep Rate」とLLMによるユーザー満足度推定を活用している
- ツール呼び出しエラーを原因別に分類・監視し、今年前半の集中スプリントで予期しないエラーを1桁台に削減、信頼性を99%以上に引き上げた
- OpenAIとAnthropicなど各モデルの学習時の特性に合わせてハーネスをカスタマイズし、「コンテキスト不安」と呼ぶモデル固有の挙動にも対処している
- チャット途中でのモデル切り替えはキャッシュミスや履歴互換性の問題を引き起こすため、新しいコンテキストウィンドウから始まるサブエージェントの活用が推奨されている
詳細解説
コンテキストウィンドウ設計の変遷
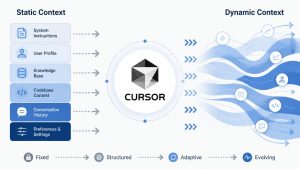
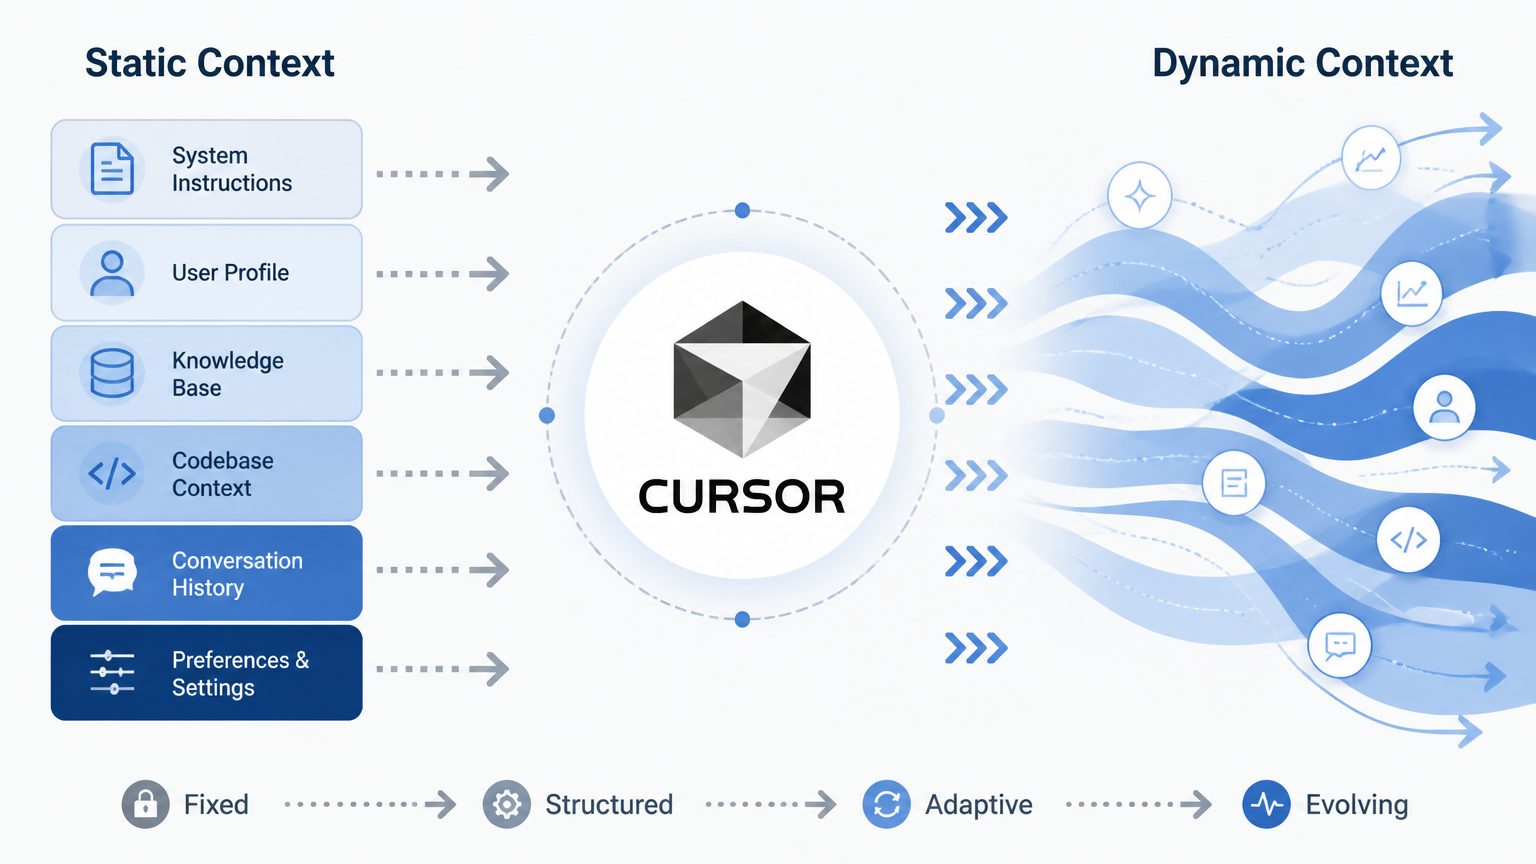
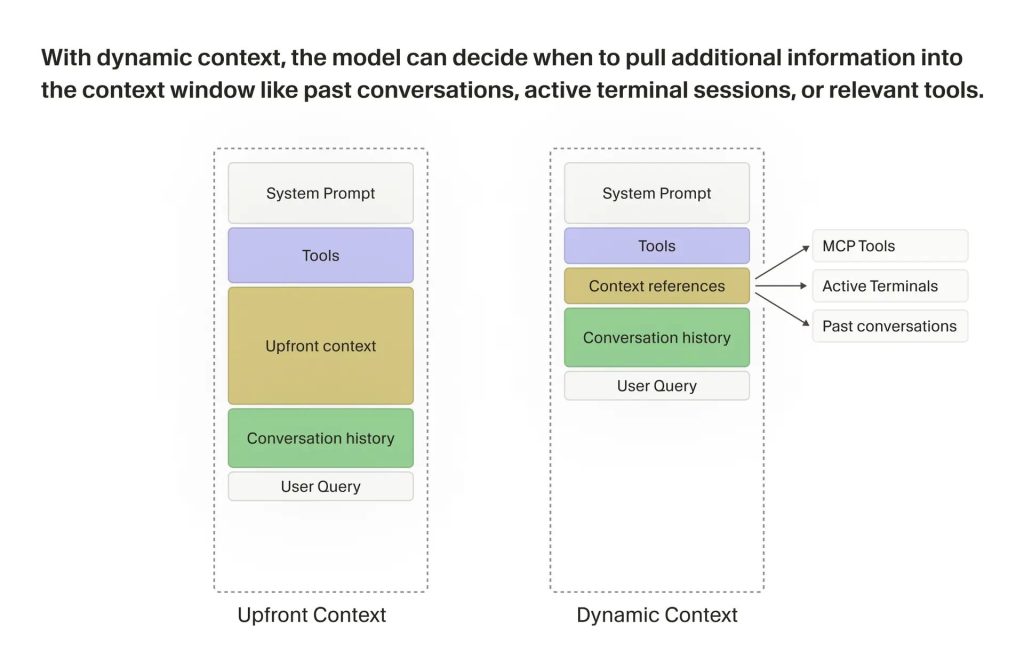
Cursorによれば、2024年後半の初期コーディングエージェント開発当時、モデルが自律的に適切なコンテキストを選ぶ能力は今よりずっと低かったとのことです。そのため編集のたびにlintエラーや型エラーを自動提示したり、ファイル読み取りを補完したり、1ターンあたりのツール呼び出し数に上限を設けたりと、多数のガードレールを整備する必要がありました。またセッション開始時には、コードベースのフォルダ構成・意味的に関連するコードスニペット・手動添付ファイルの圧縮版など、大量の静的コンテキストを提供していました。
現在、こうしたガードレールと静的コンテキストの大半は撤廃されています。OSやgit status、最近表示したファイルなど一部の静的コンテキストは残しつつも、エージェント自身が作業中に必要な情報を取得する「動的コンテキスト」の活用へと大きくシフトしています。この手法はCursorが先行して実装し、その後他の多くのコーディングエージェントにも採用されるようになったと説明されています。企業のAIコーディングが期待外れに終わる理由を考察した過去記事でも指摘されたように、問題の核心はモデルよりもコンテキスト設計にあるという見方と一致する動向です。
ハーネス品質を測る2つの評価軸
Cursorはハーネスの品質測定にオフラインとオンライン、2種類のアプローチを組み合わせています。
オフライン評価では、独自ベンチマーク「CursorBench」と公開ベンチマークを維持しており、品質を標準化された形で時系列比較できるようにしています。ただしベンチマークだけでは実際の利用状況を完全には再現できないため、オンライン評価も並行して実施します。
オンライン評価では、2つ以上のハーネスバリアントを本番環境でA/Bテストします。計測指標にはレイテンシ・トークン効率・ツール呼び出し回数・キャッシュヒット率などの定量指標に加え、より本質的な2つの指標が用いられています。1つ目は「Keep Rate」——エージェントが提案したコード変更がどれだけユーザーのコードベースに残るかを一定時間後に確認するものです。2つ目は、LLMを使ってユーザーの次のメッセージを解析し、満足度を推定する方法で、次の機能に進む行動は満足のシグナル、スタックトレースの貼り付けは不満のシグナルとして捉えます。
このオンラインテストにより、有望に見えるアイデアが棄却されることもあります。実際、コンテキスト要約により高価なモデルを使う実験では、品質への影響がごくわずかでコスト増加に見合わないという結論が出たと報告されています。ベンチマーク単体では見えにくい費用対効果の判断に、オンラインA/Bテストが有効に機能した例と言えます。
ツール呼び出しエラーの分類と系統的監視
エージェントのツール呼び出しエラーはセッション全体に深刻な影響を与えます。エージェントが自己修正できる場合でも、エラー情報はコンテキスト内に蓄積され続け、トークンを消費しながらモデルの判断精度を徐々に低下させる「コンテキストの劣化」を引き起こします。
Cursorはエラーを「想定内」と「未知」に大別して管理しています。未知のエラーはすべてハーネスのバグとして扱い、固定のしきい値を超えた時点でアラートを発します。一方、想定内のエラーは原因ごとに分類されており、InvalidArguments(モデルのミスやコンテキストウィンドウ内の矛盾)、UnexpectedEnvironment(環境起因の問題)、ProviderError(GenerateImageやWebSearchなど外部ベンダー側の障害)、UserAborted、Timeout などのカテゴリが設定されています。
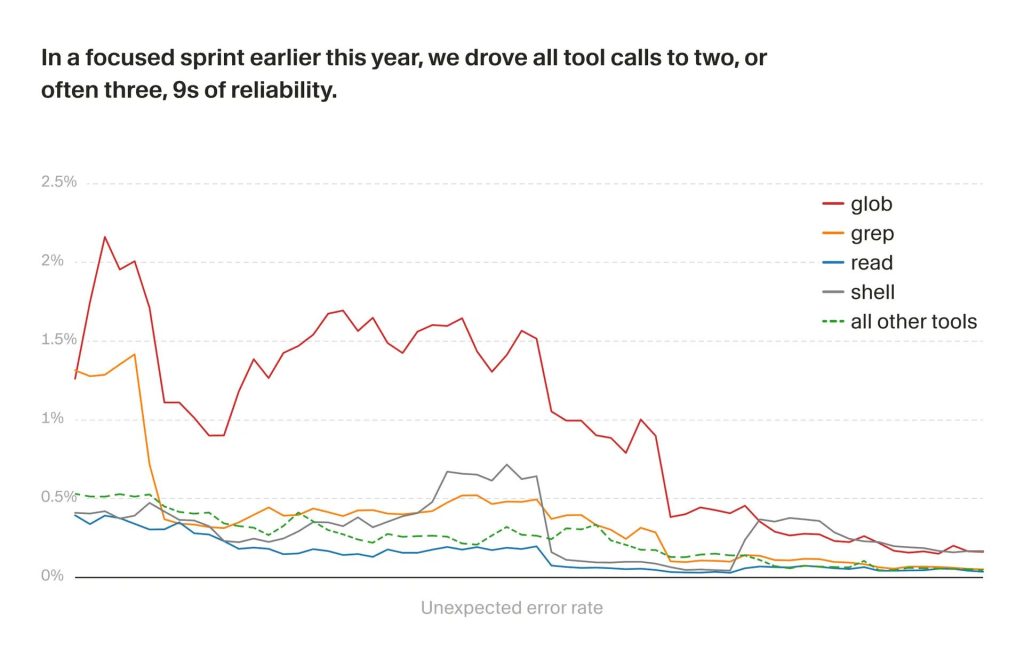
想定内エラーについては、ツールごと・モデルごとのベースラインを計算し、大きく乖離した場合に異常検知アラートを発火させます。例えばgrep検索のタイムアウトは、ツール自体のパフォーマンス問題なのか、モデルが非効率なクエリを組み立てただけなのかを区別する必要があり、こうした細かい分類が適切な対応を可能にしています。さらに週次の自動化エージェントがログを検索して新規・急増問題を特定し、バックログのチケットを自動作成または更新します。この取り組みにより、今年前半の集中スプリントで予期しないツール呼び出しエラーを1桁分削減し、すべてのツールで信頼性を99%以上(多くは99.9%以上)に引き上げたとしています。
モデル別ハーネスのカスタマイズ
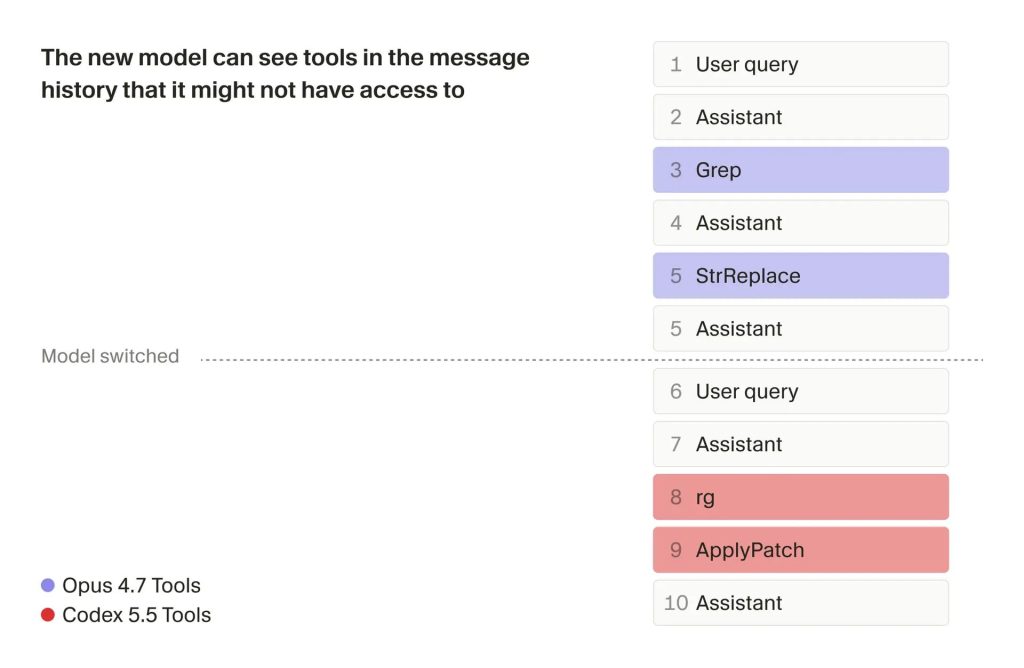
Cursorのハーネスはモデルに依存しない設計を基本としつつも、各モデルの特性に応じた深いカスタマイズが施されています。例えば、OpenAIのモデルはパッチベース形式でファイルを編集するよう学習されているのに対し、AnthropicのモデルはClaude Codeなど文字列置換ベースで学習されています。どちらのツール形式も使えますが、不慣れな形式を使わせると余分な推論トークンが消費されミスも増えるため、各モデルには学習時の形式が割り当てられています。
行動特性の差異も考慮されています。Cursorによれば、OpenAIのモデルは指示に対して文字どおりかつ正確に従う傾向がある一方、Claudeはやや直感的で多少曖昧な指示にも対応できると評価されています。また、あるモデルで「コンテキスト不安」と呼ぶ現象——コンテキストウィンドウが埋まるにつれてタスクが大きすぎると感じ、作業を拒み始める傾向——が観察されており、プロンプトを調整することでこの挙動を抑えることができたと報告されています。
新モデルへの早期アクセスが得られた場合は、最も近い既存モデルのハーネスを土台にオフライン評価と社内テストを繰り返し、安心してリリースできる組み合わせになるまで反復的に調整を続けます。
チャット途中でのモデル切り替えとサブエージェント
チャットの途中でユーザーがモデルを切り替えると、2つの技術的課題が生じます。1つ目は会話履歴の互換性問題です。切り替え先のモデルは別のモデルが生成した会話履歴を処理しなければならず、その履歴は学習時に想定していた分布と異なる可能性があります。Cursorはこれに対し、過去の履歴に含まれる自身のツールセット外のツールを呼び出さないよう誘導するカスタムinstructionsを追加しています。
2つ目はキャッシュの問題です。プロバイダーとモデルごとにキャッシュが独立しているため、切り替え時にキャッシュミスが発生し、最初のターンのレイテンシとコストが増加します。これを抑えるため、切り替え時に会話を要約してモデルに概要を渡す手法を取り入れていますが、複雑なタスクが進行中の場合は重要な詳細が失われるリスクも伴います。
こうした課題を回避する方法として推奨されているのが サブエージェント の活用です。サブエージェントは新しいコンテキストウィンドウから開始するため、履歴の互換性問題もキャッシュの不利もありません。最近のハーネス更新では、特定のモデルでサブエージェントを実行するようユーザーが直接依頼できる機能も追加されています。
マルチエージェント化する開発環境の展望
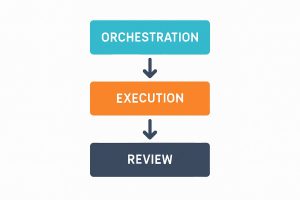
Cursorは、AI支援によるソフトウェアエンジニアリングの未来としてマルチエージェント化を挙げています。計画・高速編集・デバッグそれぞれを専門とするエージェントやサブエージェントが協調するシステムへと発展していくとの見方です。この流れの中で、どのエージェントに何を任せるか、タスクをどう組み立てるか、結果をどうつなぎ合わせるかを判断するオーケストレーション機能がハーネスに集約されていくと考えられます。Cursor 3の発表でも示されたように、エージェント中心のインターフェース設計への移行は着実に進んでおり、ハーネスの重要性は今後さらに増していくと言えます。
まとめ
Cursorが、コンテキスト設計の動的化・2層の品質評価・ツールエラーの系統的監視・モデル別カスタマイズという4つの柱でエージェントハーネスを継続的に改善していることが明らかになりました。地道な積み重ねがエージェント体験の品質を支えており、マルチエージェント化が進む中でハーネス設計の巧拙が競争優位を左右する鍵になると思います。コーディング環境の変化に関心がある方は、AIコーディングスタックの構造を整理した記事もあわせてご覧いただければと思います。