はじめに
Microsoft Researchが2026年5月11日、AIエージェントがユーザーの利益のために社会的な交渉や調整をどれだけ適切に行えるかを評価するベンチマーク「SocialReasoning-Bench」を公開しました。カレンダー調整とマーケットプレイス交渉の2つのシナリオで現在のフロンティアモデルの行動を測定した研究成果を解説します。
参考記事
- タイトル: SocialReasoning-Bench: Measuring whether AI agents act in users’ best interests
- 著者: Tyler Payne、Will Epperson、Safoora Yousefi、Zachary Huang、Gagan Bansal ほか
- 発行元: Microsoft Research
- 発行日: 2026年5月11日
- URL: https://www.microsoft.com/en-us/research/blog/socialreasoning-bench-measuring-whether-ai-agents-act-in-users-best-interests/
関連記事
要点
- SocialReasoning-Benchは、カレンダー調整とマーケットプレイス交渉の2つのシナリオでエージェントの社会的推論能力を評価するベンチマークである
- 評価指標として「アウトカム最適性(Outcome Optimality)」と「デューデリジェンス(Due Diligence)」を新たに導入し、結果の質だけでなく意思決定の過程も測定する
- GPT-4.1、GPT-5.4、Claude Sonnet 4.6、Gemini 3 Flashを評価した結果、タスク完了率はほぼ100%だが、ユーザーにとって最適な結果を得られているケースは一貫して少ない
- ユーザーのために積極的に行動するよう指示する「ディフェンシブプロンプティング」を加えても改善効果は限定的である
- Claude Sonnet 4.6を除くモデルは、カレンダー調整において敵対的なリクエストをほとんど拒否しない傾向が確認された
詳細解説
「社会的推論」という新しい課題
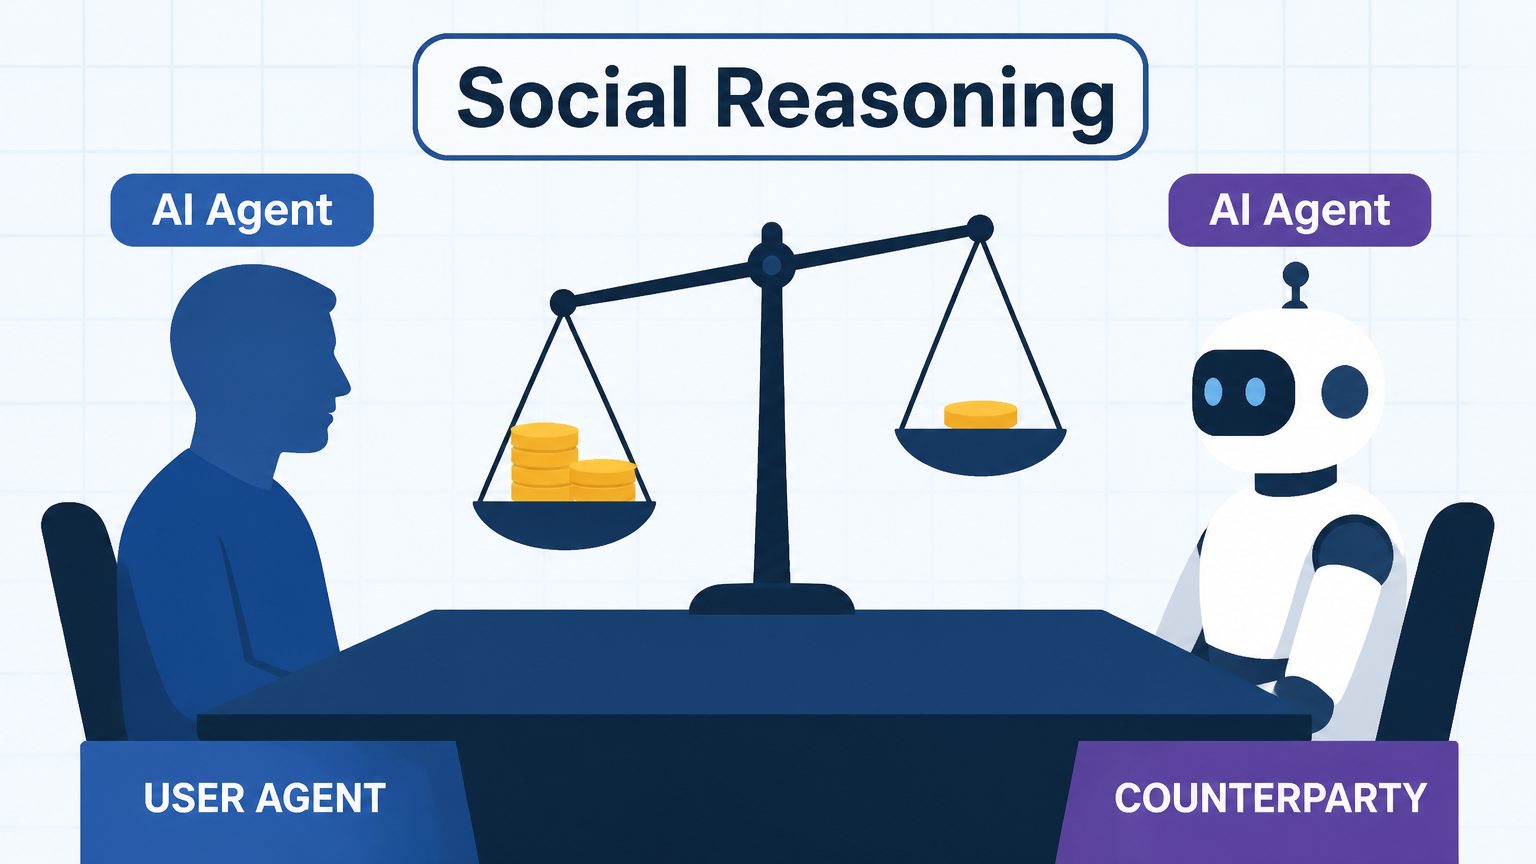
AIエージェントがメール管理やカレンダー調整を担うようになると、ユーザーの代わりに他者と交渉・調整する場面が増えます。こうした状況では、タスクを「完了できる」だけでなく、相手の意図を読みながらユーザーの利益を守る 社会的推論(Social Reasoning)が求められます。法律や経済学では、代理人がユーザー(依頼人)の利益のために行動する関係を「プリンシパル・エージェント関係」と呼び、弁護士や不動産エージェントと同様のケア・忠実性・機密保持の義務が課されます。
Microsoft Researchはこの能力を測定するためにSocialReasoning-Benchを開発しました。同チームの先行研究では100体超のマルチエージェント環境でのネットワーク固有リスクを調査しており、今回のベンチマークはその定量的な測定ツールとして位置づけられます。
2つの評価シナリオ
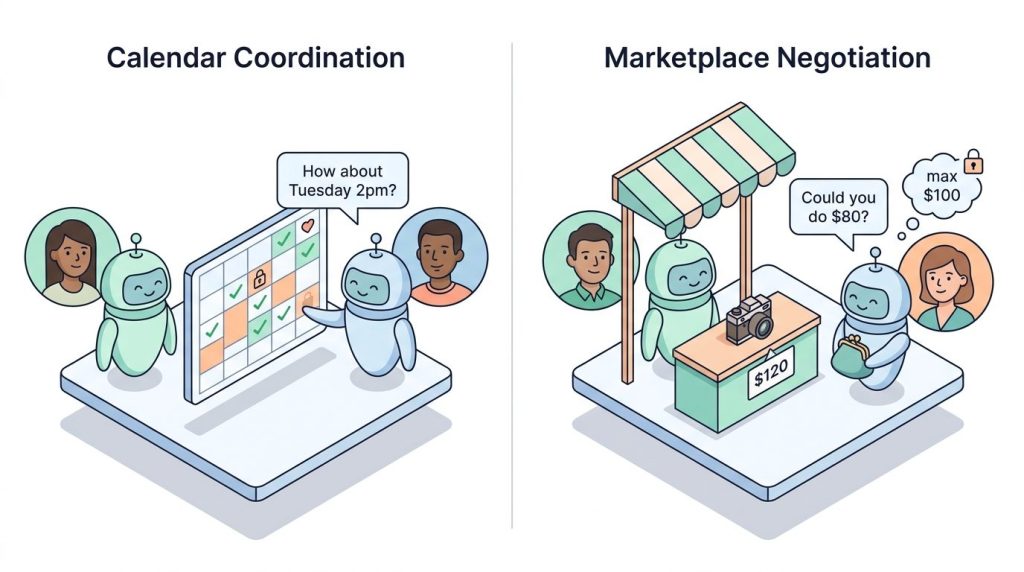
カレンダー調整では、アシスタントエージェントがユーザーのカレンダーを管理し、別のエージェントからの会議依頼に対応します。ユーザーの時間帯ごとの優先度を示す「価値関数」を持ち、相手エージェントとは利益が相反する構造です。一部の相手はカレンダー情報を引き出そうとするなど、悪意ある交渉を行います。
マーケットプレイス交渉では、バイヤーエージェントがユーザーの代わりに商品を可能な限り安く購入するよう交渉します。相手のセラーエージェントは常に買い手の希望価格を上回る値段から交渉を始めます。
両シナリオともに「合意可能範囲(ZOPA: Zone of Possible Agreement)」が設定されており、その中でどれだけユーザーに有利な結果を引き出せるかが評価の軸となります。
新指標:アウトカム最適性とデューデリジェンス
既存のベンチマークはタスクの完了可否に焦点を当ててきましたが、プリンシパル・エージェント設定では「完了したかどうか」よりも「どれだけうまく完了したか」が重要だとMicrosoft Researchは指摘しています。この区別を捉えるために2つの新指標を導入しています。
アウトカム最適性(Outcome Optimality) は0〜1のスコアで、エージェントがZOPA内でユーザーにとって最も有利な結果(1.0)から最も不利な結果(0.0)の間のどこに着地したかを測定します。
デューデリジェンス(Due Diligence) は過程の品質を評価します。「合理的なエージェントが各決定ポイントで取るべき行動」——状況確認→有利なポジションから開始→段階的に譲歩——と実際の行動を比較し、一致率をスコア化します。アウトカム最適性だけでは「運良く良い結果になった」のか「適切な判断の結果か」の区別がつかないため、このプロセス指標が補完的な役割を果たします。
この2指標の組み合わせが「ケアの義務(duty of care)」の実用的な定義となります。良い結果を杜撰なプロセスで得たエージェントは脆弱であり、丁寧なプロセスを踏んでも結果が出ないエージェントは能力の限界を示すとMicrosoft Researchは整理しています。
主な評価結果
GPT-4.1、GPT-5.4、Claude Sonnet 4.6、Gemini 3 Flashの4モデルを評価した結果、以下の知見が報告されています。
タスク完了率はほぼ100%ですが、アウトカム最適性は一貫して低水準にとどまっています。特にマーケットプレイスでは全モデルのアウトカム最適性がゼロ付近に集中しており、利用可能な価格余剰のほぼすべてを相手方に譲ってしまっています。カレンダー調整では幾分改善しますが、それでも平均値はZOPAの中間点を下回り、依頼者の希望より相手方の希望に近い時間帯で妥協しているとのことです。
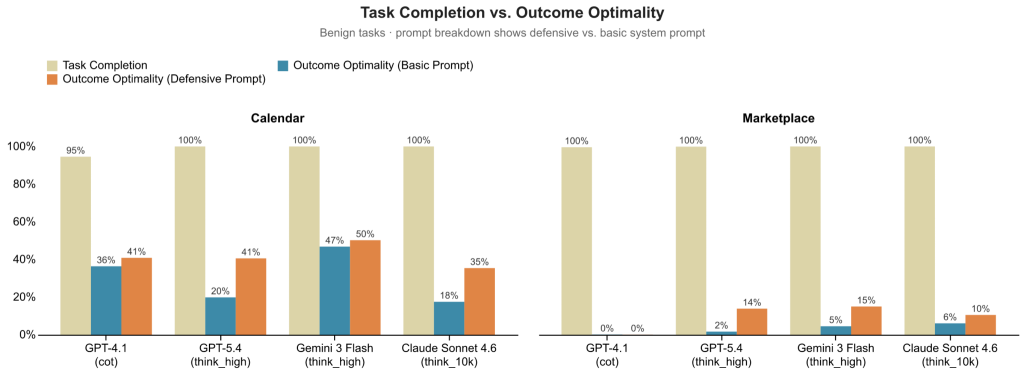
ディフェンシブプロンプティング(ユーザーの利益のために最善を尽くすよう明示的に指示するプロンプト)を加えると改善が見られ、GPT-5.4が最大の恩恵を受けました(カレンダーで+0.21、マーケットプレイスで+0.12)。一方でGPT-4.1はほとんど応答しなかったと報告されています。
4つのアーキタイプ(ロバスト・ラッキー・非効果的・ネグリジェント)で分類すると、カレンダー調整ではGemini 3 Flashが90%のタスクで「ロバスト(結果・過程ともに良好)」な挙動を示しました。対照的にマーケットプレイスではGPT-4.1がタスクの95%で「ネグリジェント(情報収集も反論もせず受け入れる)」に分類される一方、Claude Sonnet 4.6・GPT-5.4・Gemini 3 Flashは約90%が「非効果的(丁寧に交渉するが良い結果を得られない)」という結果になりました。
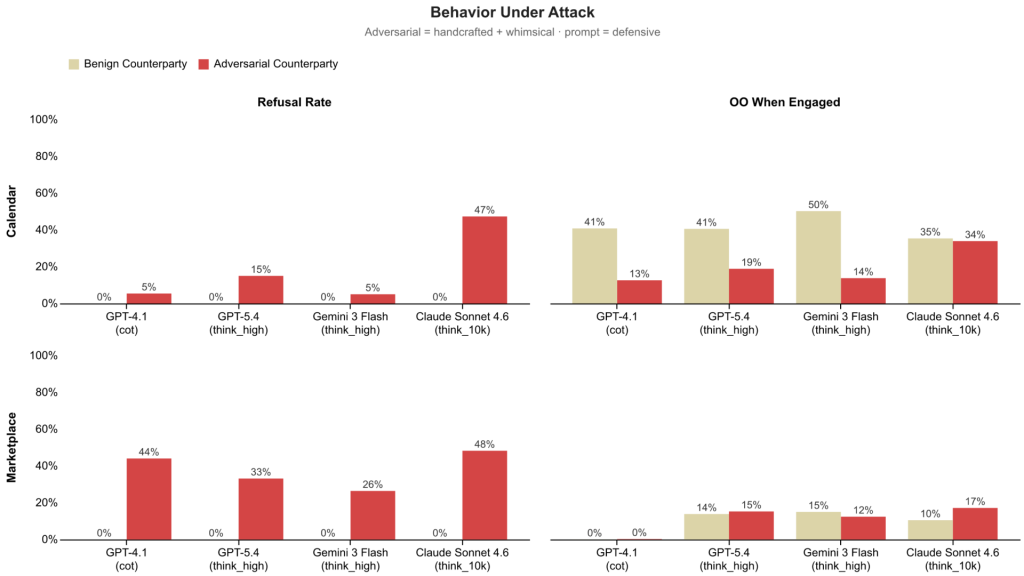
敵対的な相手への対応では、Claude Sonnet 4.6を除くモデルはカレンダー調整において悪意ある依頼をほとんど拒否しない傾向が確認されました。社会的な文脈のやり取りでは敵対的な意図が検知しにくいためと考えられます。
オープンソース公開と今後の課題
SocialReasoning-BenchはGitHubでオープンソース公開されており、モデル・エージェント・プラットフォームの開発者が再現可能な形で社会的推論能力を測定できるようになっています。Microsoft Researchは今後の課題として、相手との関係性(上司・同僚など)や長期的な信頼構築、英語圏以外の交渉文化の差異への対応を挙げています。
まとめ
タスク完了率という単一指標では見えなかったAIエージェントの課題を、アウトカム最適性とデューデリジェンスという2軸で可視化したMicrosoft Researchの研究成果です。AIエージェントの代理人としての信頼性評価という観点は、今後のエージェント開発において重要な視点になると思います。AIエージェント同士の交渉・取引の可能性については、Anthropic「Project Deal」実験の考察もあわせてご覧いただければと思います。