はじめに
Googleは2026年11月19日、Gemini APIの新機能「Tool Retrieval」をInteractions APIでプレビュー公開しました。本稿では、ツールのスキーマを必要なときだけ読み込む仕組みと設定方法、クライアント側での検索、料金と対応モデルをコード付きで解説します。
参考記事
- タイトル: Introducing Tool Retrieval in the Gemini API
- 著者: Lucia Loher(Product Manager, Gemini API)、Nora Kassner(Research Scientist, Google DeepMind)
- 発行元: Google
- 発行日: 2026年11月19日
- URL: https://blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval/
関連記事
要点
- Tool Retrievalは、エージェントが多数のツールを持つ場合に、パラメータスキーマを必要なときだけ読み込む機能である
- tool_searchツールを追加し、読み込みを遅らせたいツールに defer_loading: true を設定するだけで有効になる
- 検索はGeminiのサーバー側で実行され、インデックスの構築やホスティングは不要である。自前の検索を使うクライアント側実行にも対応する
- 追加料金はなく、Gemini 3.6以降のモデル(Gemini 4の全モデルを含む)がInteractions APIで利用できる
詳細解説
Tool Retrievalが解決する問題
エージェントが数十〜数百のツールに接続していると、リクエストのたびにすべてのツールのパラメータスキーマ(引数の型や必須項目を定義したJSON)を送ることになります。Googleによれば、これは入力トークン数を膨らませ、レイテンシを増やし、候補が増えるほどツール選択の精度を下げるとされています。
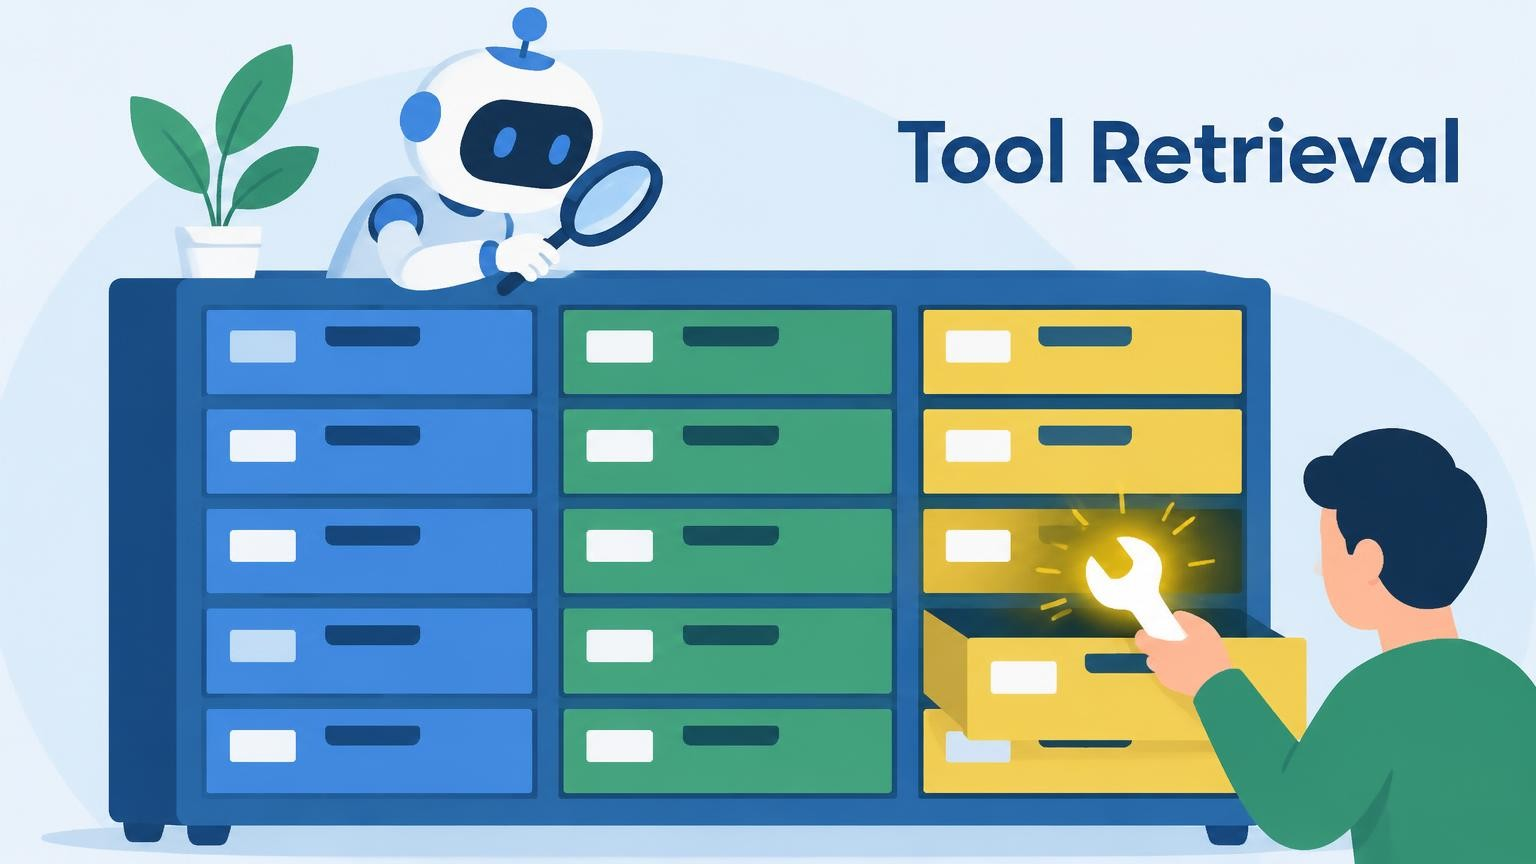
Tool Retrievalを使うと、エージェントはツールライブラリ全体を待機させておき、今のタスクに必要なツールのスキーマだけを読み込めます。
関数呼び出し(function calling)を使ったことがある方なら、ツールを増やすほどプロンプトが長くなり、モデルが似た名前のツールを取り違えるといった経験があるかもしれません。本稿としては、Tool Retrievalはこの「ツールの数とモデルの判断精度のトレードオフ」をAPI側の仕組みで緩和しようとする機能だと受け止めています。
前提条件・環境構成
コード例を動かすには、次の環境が必要です。
- Gemini APIのAPIキー
- Python版のGoogle Gen AI SDK(コード中の
from google import genaiで読み込むライブラリ) - Interactions APIで利用できるGemini 3.6以降のモデル(Gemini 4の全モデルを含む)
注意: Tool Retrievalは現時点でプレビュー機能であり、Interactions APIでのみ利用できます。従来のAPIエンドポイントを使っている場合は、Interactions APIへの移行が前提になります。
基本的な仕組み
Tool Retrievalを有効にするには、リクエストに tool_search ツールを追加し、読み込みを遅らせたいツールに defer_loading: true を設定します。動作は次のとおりです。
- モデルは、遅延読み込みにしたツールも含め、すべてのツールの名前と説明(description)を参照できる。そのため、どのツールが利用可能かは把握している
- パラメータスキーマはコンテキストに含まれない
- モデルがツールを必要とすると、名前を指定してそのツールを要求する
- APIが完全なスキーマを読み込み、モデルが関数を呼び出す。ここまでがすべて同じリクエストの中で完結する
次のコードは、返金処理のツールを遅延読み込みに設定した例です。
from google import genai

client = genai.Client()

tools = [
   # Tool Retrievalを有効にするためのツール
   {"type": "tool_search"},
   {
       "type": "function",
       "name": "issue_refund",
       "description": "Refund an order to the original payment method.",
       # このツールのスキーマは必要になるまで読み込まない
       "defer_loading": True,
       "parameters": {
           "type": "object",
           "properties": {
               "order_id": {"type": "string"},
               "amount": {"type": "number"},
           },
           "required": ["order_id", "amount"],
       },
   },
   # ... ほかに50以上の遅延読み込みツール(頻繁に使うツールは遅延させない)
]

interaction = client.interactions.create(
   model="gemini-4-hydrogen",
   input="Order A-1042 arrived damaged. Please refund 40 dollars.",
   tools=tools,
)サンプルでは軽量・高速モデルのGemini 4 Hydrogenが使われています。description(ツールの説明文)はモデルがツールを選ぶ唯一の手がかりになるため、遅延読み込みにするツールほど、説明文を具体的に書くことが重要になると考えられます。
interaction.stepsで処理の流れを確認する
この1回のAPI呼び出しの中で、モデルは issue_refund を検索し、APIがそのスキーマを読み込み、モデルが function_call を出力します。3つのステップはすべて interaction.steps に記録されるため、ツール名や説明文を調整する際に、モデルがどのツールを検討したかを確認しやすくなっています。
"steps": [
 {
   "type": "tool_search_call",
   "id": "tsc_7f2a",
   "arguments": {"function_names": ["issue_refund"]},
   "signature": "..."
 },
 {
   "type": "tool_search_result",
   "call_id": "tsc_7f2a",
   "result": [{"type": "function", "name": "issue_refund", "parameters": {...}}],
   "signature": "..."
 },
 {
   "type": "function_call",
   "id": "fc_91c3",
   "name": "issue_refund",
   "arguments": {"order_id": "A-1042", "amount": 40}
 }
]
各ステップの意味は次のとおりです。
- tool_search_call: モデルが名前を指定してツールを検索する
- tool_search_result: APIが該当ツールの完全なスキーマを返す
- function_call: モデルが読み込んだスキーマに沿って関数を呼び出す
ここから先は通常の関数呼び出しと同じで、アプリ側のコードが返金処理を実行し、function_result を返します。
サーバー側実行の利点
サーバー側で動くTool Retrievalには、次の特徴があるとされています。
- インデックスの構築・ホスティングが不要: 検索はGeminiのサーバー側で実行される。コードの変更は、新しいツールの追加と、遅延させたいツールへのフラグ設定だけで済む
- よく使うツールとの併用: 頻繁に使うツールは最初から読み込んでおき、使用頻度の低い多数のツールだけを遅延させられる
- プレフィックスキャッシュとの相性: 遅延したスキーマはプロンプトの冒頭に入らず、モデルが読み込んだスキーマは会話の後ろに追加される。そのため、キャッシュされるプロンプトの先頭部分がターンごとに変わらない
- リモートMCPサーバーへの対応: mcp_server ツールに defer_loading: true を設定すると、そのサーバーが公開するすべてのツールがオンデマンドで読み込まれる。大規模なMCPサーバーでも、ツールを1つずつ列挙せずに接続できる
特にMCPサーバー単位で遅延読み込みできる点は、本稿としては実用上の効果が大きいと考えています。外部サービスのMCPサーバーは数十のツールを公開していることが多く、複数つなぐとそれだけでスキーマがコンテキストを圧迫しがちだからです。
クライアント側で検索を実行する方法
独自のツールレジストリ、埋め込みベクトルのインデックス、ユーザーごとの権限フィルタなどを持っている場合は、tool_search を “execution”: “client” で宣言し、検索パラメータを定義します。この場合はアプリ側で検索を実行するため、検索ごとに1往復が追加されます。
一方で、ツールを事前に宣言しておく必要がないため、ユーザーが新しい連携サービスを接続したときに、会話の途中から新しいツールを公開することもできます。
tools = [{
    "type": "tool_search",
    # 検索をアプリ側で実行する
    "execution": "client",
    "name": "search_tools",
    "description": "Search the internal tool registry for functions.",
    "parameters": {
        "type": "object",
        "properties": {"query": {"type": "string"}},
        "required": ["query"],
    },
}]

# モデルが "search_tools" の function_call を出力したら、
# 一致する {"type": "function", ...} 形式のスキーマを function_result で返す
followup = client.interactions.create(
    model="gemini-4-hydrogen",
    previous_interaction_id=interaction.id,
    tools=tools,
    input=[{
        "type": "function_result",
        "name": "search_tools",
        "call_id": step.id,
        "result": my_registry.search(**step.arguments),
    }],
)
注意: このコードの my_registry は利用者側で用意するツールレジストリ、step は直前の応答に含まれる search_tools の function_call ステップを指します。いずれも記事のサンプルでは定義が省略されているため、自身の環境に合わせて実装する必要があります。
サーバー側とクライアント側の使い分けを整理すると、次のようになります。
- サーバー側(既定): 追加の往復がなく、実装も簡単。ツールを事前に宣言しておく必要がある
- クライアント側(”execution”: “client”): 検索ごとに1往復増えるが、独自の検索ロジックや権限管理を組み込め、会話中に新しいツールを追加できる
ユーザーごとに使えるツールが異なるSaaSのような環境では、権限フィルタを自前で適用できるクライアント側実行のほうが設計上扱いやすいと思います。
料金と対応モデル
Tool Retrievalに別料金はかからず、入力・出力トークンは呼び出すモデルの標準料金で課金されます。料金面のポイントは次のとおりです。
- tool_search を有効にすると、小さな固定サイズの入力トークンが追加される
- モデルが読み込んだスキーマは、その後の会話を通じて入力トークンとして課金される。これは最初から宣言したツールと同じ扱い
- 読み込まれなかったスキーマの分が、読み込まれた分を上回れば節約になる。大規模なツールライブラリでは通常こちらに当てはまる
Googleは、効果は実際のトラフィックで測定するよう勧めています。対応モデルは、Interactions APIで利用できるGemini 3.6以降のモデルで、Gemini 4の全モデルが含まれます。
ツールが少ない場合は固定の追加トークン分だけ割高になる可能性があるため、導入前に「1リクエストあたり何個のツールが実際に使われているか」をログから確認しておくと判断しやすいと考えられます。
始め方
Googleは次のリソースを案内しています。
- ドキュメントを読む: 例を含む完全なセットアップガイド
- Geminiモデルを比較する: 用途に合ったモデルを探す
- Discordの議論に参加する: チームにフィードバックを送る
まとめ
Tool Retrievalは、tool_searchと defer_loading の設定だけで、多数のツールを扱うエージェントの入力トークンと選択ミスを抑えられます。Interactions API正式版の解説もご覧ください。