はじめに
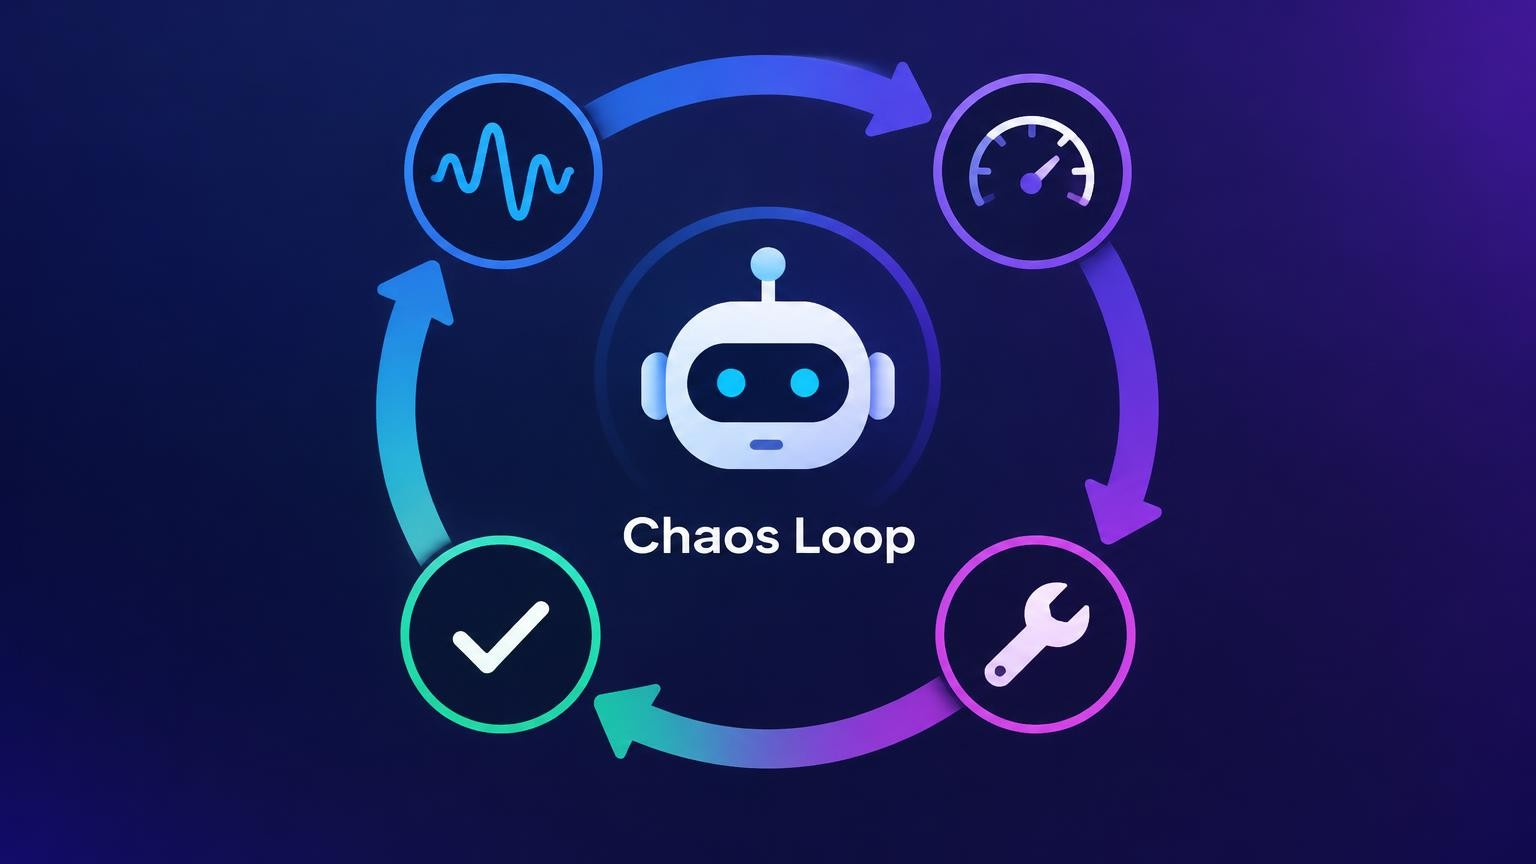
Anthropicは、Claudeに検証環境のサービスを約2週間壊させ続け、弱点をその場で直させました。この「カオスループ」でClaude Docsの公開に備えた結果、20億件のリクエストでサーバーエラーは60件でした。同社の2026年11月17日の記事をもとに、仕組みと結果、限界を解説します。
参考記事
- タイトル: Using a “chaos loop” to harden the Claude Docs launch: 60 server errors across billions of requests
- 発行元: Anthropic
- 発行日: 2026年11月17日
- URL: https://claude.dev/blog/chaos-loop-claude-docs-launch/
関連記事
要点
- Anthropicは、Claude Docs公開の約2週間前から、Claude Codeに検証環境への負荷試験と修正を続けさせる「カオスループ」を実施した。
- 9月16日の公開から22日までに460万件超のドキュメントが作成され、20億件のリクエストでサーバーエラーは60件、ロールバックは一度もなかった。
- 計測の拡充、Rustの採用、依存ライブラリの最小化により、Claudeがメモリ増加の原因を突き止め、必要なpod数の見積もりは500超から約50に減った。
- 推論費用はClaude Fable 5.2のAPI定価換算で約12万5,000ドルである。小規模サービスなら3,000〜1万ドル程度と著者は概算しているが、実際には試していない。
詳細解説
カオスループの仕組み
Claude Docsは公開の3週間前まで、1台のノード(サーバー)で動く試作段階でした。利用者は社内の数千人だけです。一方で、公開後の数日で数百万件のドキュメントが作られると見込まれていました。
公開時と同じ量の実トラフィックを用意して試すことはできません。チームには、どの程度の速さで展開できるかを決める証拠が必要でした。負荷試験はシナリオ作り、分析、修正の繰り返しに人手がかかります。限られた期間でそれをどこまで回せるかが課題でした。
9月4日、公開の約2週間前に、著者はClaudeにステージング環境を動かさせ始めました。ステージング環境は、本番とほぼ同じ構成の検証用環境です。Claudeは1日100万件超の合成ドキュメント(テスト用の自動生成文書)で負荷をかけ、中核部品をわざと壊しました。
使われたのは、Anthropic開発陣が誕生の経緯を語ったClaude Codeです。1つのセッションを調整役(コーディネーター)として動かし続け、作業の多くをサブエージェントに割り振りました。サブエージェントは、調整役から仕事を任される別のClaudeです。最も忙しい週は常時11体ほど、ピーク時は30体が並行して動きました。
調整役は、Slack MCPを通じて社内版のClaude Tag(ベータ)ともやり取りしました。MCP(Model Context Protocol)は、Claudeを外部のツールやデータにつなぐ共通規格です。相手は、似たサービスの拡張を経験した社内インフラチームのエージェントです。過去にはまった落とし穴がないかを、拡張方針に照らして確認しました。
1回の反復は次の8ステップで、そのうち2つが人の判断です。
- ハーネスが負荷をかける
- Claudeがテレメトリーを読む
- Claudeが選択肢を提案する
- 人が1つを選ぶ
- Claudeが変更を書く
- Claudeが別のセッションで変更をレビューする
- 人が承認する
- Claudeがステージング環境にデプロイし、1に戻る
ハーネス(試験を自動実行する仕組み)は、機能を1つ選んで限界まで負荷をかけます。Claudeは監視サービスDatadogのMCPでテレメトリー(動作状況の計測データ)を読みます。そして選択肢と推奨案を短くまとめて返しました。取り消しやすい変更なら、Claudeが書いて反映し、テストをやり直しました。
シナリオは、著者自身が考えすぎだと思えるものを選んでいます。
- 1日で1,000万件の新規ドキュメントが作られる
- 2万2,000本のライブ接続が一斉に再接続する
- 数百人が閲覧する人気ドキュメント、読み込み途中でのサーバー停止、データベースの応答停止
公開週の結果
Claude Docsは9月16日に公開され、公開時の負荷に耐えました。主な数値は次のとおりです。
- 最初の100万件のドキュメントが作られるまで約30時間
- 9月22日までに作成されたドキュメントは460万件超
- 20億件のリクエストで発生したサーバーエラーは60件
- 9月中に本番環境へ629回デプロイし、ロールバック(以前の版へ戻すこと)は一度もなし
- Docsサービス全体は、メモリ最適化podおよそ50個で稼働
サーバーエラー60件は、計算上は約3,300万件に1件の割合です。ただし、これはAnthropicの自社サービスでの数値です。性質や規模が違うサービスで同じ結果になるとは限りません。
ステージング環境で予行演習した10のシナリオのうち、7つが実際に本番で起きました。Claudeは修正をランタイムフラグ(再デプロイせずに機能を切り替えるスイッチ)の裏に組み込んでいました。そのため負荷がかかった場面の多くは、フラグの切り替えだけで済みました。
費用と、小規模サービスでの試し方
8月末から公開日までの推論費用は、Claude Fable 5.2のAPI定価(2026年11月時点)で約12万5,000ドルでした。数年前なら、エンジニアのチームで約6か月かかったと著者は推測しています。
費用の大半は、テレメトリーの読み取り、提案、修正の生成、コードレビューに使われました。公開規模が特に大きく、その規模でしか意味のないインフラにも多くを費やしています。構成を試す間もループは動き続けており、今の知見なら約半分で済んだと著者はみています。
著者は、小規模チームでよくある構成でも概算しました。適度な大きさのKubernetesノード2台程度と、Postgresのインスタンス1つです。そのうえで、次のような不要な作業を除きました。
- 社内の他サービスとの連携
- 規模対応の作業と混在していた、クライアント・製品側の作業
- 多数のpodにまたがる運用
- きめ細かなレート制限(利用回数の上限管理)
残った変更は全体の約3分の1でした。さらに模索期のミスを除き、2週間で3,000〜1万ドルと見積もっています。ただし実際には試しておらず、大まかな感覚です。
前提は、Claude Codeを使うエンジニア1人、ステージング環境、オブザーバビリティ(監視)サービスの3つです。トークン消費が多すぎる場合は、単一のエージェントでも十分うまくいくはずだと著者は述べます。試す手順は次の5つです。
- Claudeにテレメトリーへのアクセス権を渡す。多くの監視サービスには、Claudeが使えるMCPサーバーがあります。
- 実際のトラフィックの10倍をステージング環境に送り、わざと障害を起こす負荷スクリプトをClaudeに書かせる。手始めは、インスタンスの停止、データベースの応答停止、アクセス急増中のデプロイです。あとは壊れたものを直させ続けます。
- 技術スタックは、Claudeが最も測りやすいものに寄せる。Anthropicの場合は、Rustとできるだけ少ない依存ライブラリでした。
- 始める前に、最も重要な技術的な不変条件を書き出してClaudeに渡す。
- 取り消しにくい変更では、Claudeに作業を止めさせ、明確な推奨案を添えた選択肢をいくつか出させる。
外部の例として、Vercelも似た監督付きのエージェントループで、ビルドツールTurborepoを最大96%高速化しました。
人が判断する範囲と、守り続ける2つの条件
ループの開始前に、著者は自分の承認が必要な判断をClaudeに伝えました。基本は取り消しにくいものすべてです。
- データベースのスキーマ(データの構造定義)やキーの配置の変更
- ドキュメントの保存方法や、保存データから文書の状態を組み立てる方法(マテリアライズ)の変更
Claudeはこうした判断に当たると作業を止め、多くは推奨案を添えて尋ねました。著者はその推奨案を承認することが多かったそうです。スキーマ変更は妥当な答えが複数あり、後から変えると負担が大きいため、相談を受けたい典型例でした。
全期間を通じて、Claudeは次の2つの不変条件を守る必要がありました。
- 長い編集履歴を持つものも含め、ドキュメントがほぼ瞬時に開けること
- サーバーが受け付けを確認した編集が、テストで消えずに残っていると示されること
性能向上のための変更が、使い勝手やデータの安全性を損なわないための歯止めです。
Claudeが原因をたどれる計測と技術選択
著者は、同僚のFelix Rieseberg氏のチュートリアルを紹介しています。要点は、個々の作業ではなく望む結果をClaudeに頼むことです。たとえば個別のクラッシュではなく、アプリをクラッシュしない状態にするよう頼みます。Anthropic自身もまだ道半ばですが、着実に前進しているそうです。
この任せ方には、Claudeが自分でクラッシュ報告を取得し、再現と修正確認ができる環境が要ります。今回チームは、サービスをClaudeにとって読み取りやすく(legible)するため、2つの取り組みをしました。
1つ目は診断ループです。反復のたびにClaudeがテレメトリーを読み、足りない計測を自分で追加しました。サービスのすべての処理には計測が付いています。たとえばクエリは名前と、走査・返却した行数を毎回記録します。これで無駄の多いクエリを見つけて書き直せました。
メモリの例が分かりやすいでしょう。初期には、ある大きなドキュメントが1つのpodで約3GBを使っていました。Claudeはまずキャッシュの1つを小さくしました。しかし次の実行で、原因は依存ライブラリ内の別のキャッシュだと分かり、変更を取り下げました。
より細かいプロファイリングの結果、キー入力のたびに文書が複数のデータ構造へコピーされていると判明しました。毎回数MBずつ増えていたのです。Claudeはこれを、必要になるまで複製しないコピーオンライト方式に切り替えました。
約3日間の反復で、このドキュメントのメモリは最大でも約180MBに収まりました。必要なメモリ最適化podの見積もりも500超から約50に下がりました。計測が細かいほど、誤った修正を早く取り消せるとみられます。
2つ目は技術選択です。Claudeが測った数値を、自分たちのコードまでたどれるようにしました。モデルは雑音の少ない信号があるときに最も着実に改善できる、というのが理由です。ガベージコレクション(GC)は、動くタイミングでメモリや遅延を揺らすと予想されていました。
- サービスをRustで書いた: GCがなく、メモリはすべて自分たちのデータ構造に収まります。原因の構造を特定し、次の反復で減ったかを確かめられました。
- 依存ライブラリを最小限にした: 必要な少数はベンダリング(ソースをリポジトリに取り込むこと)し、自分たちで読んで測れるようにしました。
ただしRustとGoを比較検証したわけではありません。社内にはGo向けの優れたツールもあります。Rustは人には難しい言語ですが、ClaudeはRustを問題なく書けるため、今ではその点はずっと小さな問題です。
長期間の作業を支えたモデルの進歩
使ったのは、Claude Fable 5.2とおおむね同等の社内研究用モデルです。著者は、数か月前ならおそらくうまくいかなかったと述べています。
以前のモデルは、長いループの10〜20回目あたりで最適化の目標を忘れ始めました。社内では「ゴールドリフト(目標のずれ)」と呼ぶ人もいます。今回のClaudeは、何度もコンパクション(文脈の要約)を経ても不変条件をすべて保ちました。1つの目標を数週間保てることが、短期間での公開につながったとされます。
まだ分からないこと・限界
- 使われたのは、Claude Fable 5.2とおおむね同等の社内研究用モデルです。
- 成功の大きな要因は、長期間1つの目標を保てるモデルの進歩に置かれています。
- RustとGoは比較しておらず、GCが雑音を生むという点も事前の予想です。
- 小規模サービス向けの3,000〜1万ドルは、試していない大まかな見積もりです。
- エンジニアのチームで約6か月という比較は、著者の推測です。
- 費用には試行錯誤が含まれ、約半分にできたと著者はみています。
- 取り消しにくい判断は人が承認しており、すべてをClaudeに任せたわけではありません。
- 社内インフラや社内版Claude Tagなど、Anthropic固有の環境での1サービスの結果です。
まとめ
Claude Docsの公開前、Claudeは約2週間、検証環境を壊しては直す作業を続けました。成果を支えたのは、人が持つ判断の線引きと、原因をたどりやすい計測と技術選択です。小規模なサービスでも、守る条件と承認の範囲を先に決めることから試せそうです。Docs機能の追加については、ClaudeのチャットとCoworkの統合を扱った解説もご覧ください。