はじめに
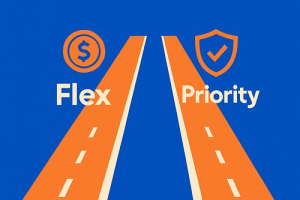
GoogleはGemini APIに新たなサービスティア「Flex Inference」と「Priority Inference」を2026年4月2日に追加しました。本稿では、この発表内容をもとに、2つのティアの仕組みと使い分け方、開発現場での活用ポイントを解説します。
参考記事
- タイトル: New ways to balance cost and reliability in the Gemini API
- 著者: Lucia Loher、Hussein Hassan Harrirou
- 発行元: Google Blog
- 発行日: 2026年4月2日
- URL: https://blog.google/innovation-and-ai/technology/developers-tools/introducing-flex-and-priority-inference/
要点
- Gemini APIに新たなサービスティアとして「Flex Inference」と「Priority Inference」が追加された
- Flex Inferenceは標準APIの半額(50%削減)で利用できる遅延許容型のコスト最適化ティアである
- Priority Inferenceはピーク時でも高い信頼性を保証するプレミアムティアで、上限超過時は標準ティアへ自動降格する仕組みがある
- 両ティアともにservice_tierパラメータを設定するだけで切り替えでき、非同期バッチAPIへの依存が不要になる
- FlexはすべてのPaidティアで利用可能、PriorityはTier 2/3のPaidプロジェクトが対象である
詳細解説
なぜ今、推論ティアが必要になったのか
AIがシンプルなチャットから複雑な自律型エージェントへと進化するにつれ、開発者はアプリケーション内で「即応性は不要だが大量処理したいタスク」と「ユーザーに直接応答する高信頼性が求められるタスク」の2種類を同時に扱う場面が増えています。Googleの発表によれば、従来はこの2種類に対応するために、標準の同期APIと非同期のバッチAPIを組み合わせるアーキテクチャが必要でした。FlexとPriorityは、この分断を解消する目的で設計されています。
バッチAPIは大量処理においてコスト効率が高い一方、入出力ファイルの管理やジョブ完了のポーリング処理など、実装上の手間が伴います。FlexとPriorityは同期インターフェースを維持しつつ、コストと信頼性の制御をservice_tierというシンプルなパラメータ設定に集約した点が特徴と言えます。
Flex Inference:バックグラウンド処理を50%オフで
Flex InferenceはGoogleが説明する「レイテンシ許容型ワークロード向けのコスト最適化ティア」です。標準APIと比べて50%のコスト削減を実現しますが、その代わりにレスポンスの信頼性とレイテンシ(応答速度)はやや下がります。
想定される活用場面として、GoogleはバックグラウンドでのCRM(顧客管理システム)データ更新、大規模な研究シミュレーション、AIがバックグラウンドで「思考」や「ブラウジング」を行うエージェント型ワークフローを挙げています。即座の応答が不要で、処理量が多い用途に適していると言えます。
使い方はservice_tierパラメータを”flex”に設定するだけです。
# Flexティアを使ったバックグラウンド要約の例

response = client.models.generate_content(
    model="gemini-3-flash-preview",
    contents="Summarize this massive transcript...",
    config={"service_tier": "flex"},
)

# 実際にどのティアで処理されたか確認
print(response.sdk_http_response.headers.get("x-gemini-service-tier"))
FlexティアはGenerateContentおよびInteractions APIのリクエストを対象に、すべての有料ティアで利用できます。
Priority Inference:ピーク時も落ちない最高信頼性ティア
Priority Inferenceは、プレミアム価格帯で提供される最高信頼性のティアです。Googleによれば、ピーク時のプラットフォーム負荷が高い状況でも、Priorityリクエストは他のトラフィックに優先して処理されます。
注目すべき機能のひとつがグレースフルダウングレード(graceful downgrade)です。Priorityの利用上限を超えたリクエストは、エラーを返すのではなく自動的に標準ティアで処理されます。これにより、アプリケーションの稼働継続性が保たれ、ビジネスへの影響を最小限に抑えられます。また、APIレスポンスにはどのティアで処理されたかが明示されるため、パフォーマンスと課金の透明性も確保されています。
想定される用途として、Googleはリアルタイムのカスタマーサポートボット、ライブコンテンツモデレーションパイプライン、時間的余裕のない重要リクエストを挙げています。設定方法はFlexと同様で、service_tierを”priority”に指定するだけです。
# Priorityティアを使った重要アラートのトリアージ例
response = client.models.generate_content(
    model="gemini-3-flash-preview",
    contents="Triage this incoming security alert immediately.",
    config={"service_tier": "priority"},
)
Priority InferenceはGenerateContent APIおよびInteractions APIを対象に、Tier 2/3の有料プロジェクトで利用できます。
2つのティアの使い分けの考え方
FlexとPriorityは、それぞれ異なる用途に最適化されています。ユーザーの操作に直接応答するチャットボットや重要なアラート処理にはPriority、夜間のデータ集計やエージェントの思考プロセスのようにバックグラウンドで動く処理にはFlexを使うという分け方が基本になると思います。両方を組み合わせることで、コストと信頼性のバランスを用途に応じて調整しやすくなると考えられます。詳細な料金体系についてはGemini API公式ドキュメントで確認できます。
まとめ
Googleは2026年4月2日、Gemini APIにFlexとPriorityの2つの推論ティアを追加しました。service_tierパラメータひとつで切り替えられるシンプルな設計で、コスト重視のバックグラウンド処理から高信頼性が求められるインタラクティブ機能まで、用途に応じた最適化が可能になります。エージェント型AIを構築する開発者にとって、アーキテクチャ設計の選択肢が広がる変更と言えます。