はじめに
MITニュースが2026年2月25日に報じた内容をもとに、本稿ではMITとハーバード大学のBroad InstituteおよびETHチューリッヒ/ポール・シェラー研究所(PSI)の研究チームが開発したAI駆動の細胞解析フレームワークを紹介します。複数の計測手法から得られる細胞情報を、より正確に整理・統合するこのアプローチは、がんや神経変性疾患の研究加速につながる可能性があります。
参考記事
- タイトル: AI to help researchers see the bigger picture in cell biology
- 著者: Adam Zewe
- 発行元: MIT News
- 発行日: 2026年2月25日
- URL: https://news.mit.edu/2026/ai-help-researchers-see-bigger-picture-cell-biology-0225
要点
- MITらの研究チームが、細胞の複数の計測モダリティ間で「共有される情報」と「固有の情報」を自動的に識別するAIフレームワークを開発した
- このフレームワークは修正版オートエンコーダを用いており、共有表現空間とモダリティ固有の表現空間を同時に学習する2段階の訓練手順を採用している
- 合成データセットおよび実際のシングルセルデータセットでの検証において、既知の共有情報とモダリティ固有情報を正確に識別することが確認された
- がん・アルツハイマー病・糖尿病など複数の疾患メカニズム解明への応用が見込まれ、研究成果は学術誌『Nature Computational Science』に掲載された
詳細解説
研究の背景:なぜ「複数の計測」が必要なのか
細胞の状態を理解するには、一つの計測手法だけでは不十分なことが多いとされています。たとえば、RNA(リボ核酸)を計測すれば細胞が成長しているかどうかを確認でき、クロマチン形態を計測すれば外部の物理的・化学的シグナルへの応答を把握できます。つまり、それぞれの計測手法は細胞の異なる側面を映し出すものであり、がんの起源を特定したり治療効果を予測したりするためには、複数の手法を組み合わせて情報を統合することが必要です。
ただし、従来の機械学習を用いたマルチモーダル解析(複数の計測手法を組み合わせた解析)では、各手法から得られた情報が一括りにまとめられてしまい、「どの情報がどの計測手法から来たものか」を判別することが難しいという課題がありました。また、研究者が個別の実験を繰り返して手作業で比較するアプローチは時間と手間を要するため、情報収集の量に限界が生じていました。
フレームワークの仕組み:ベン図のように情報を整理する
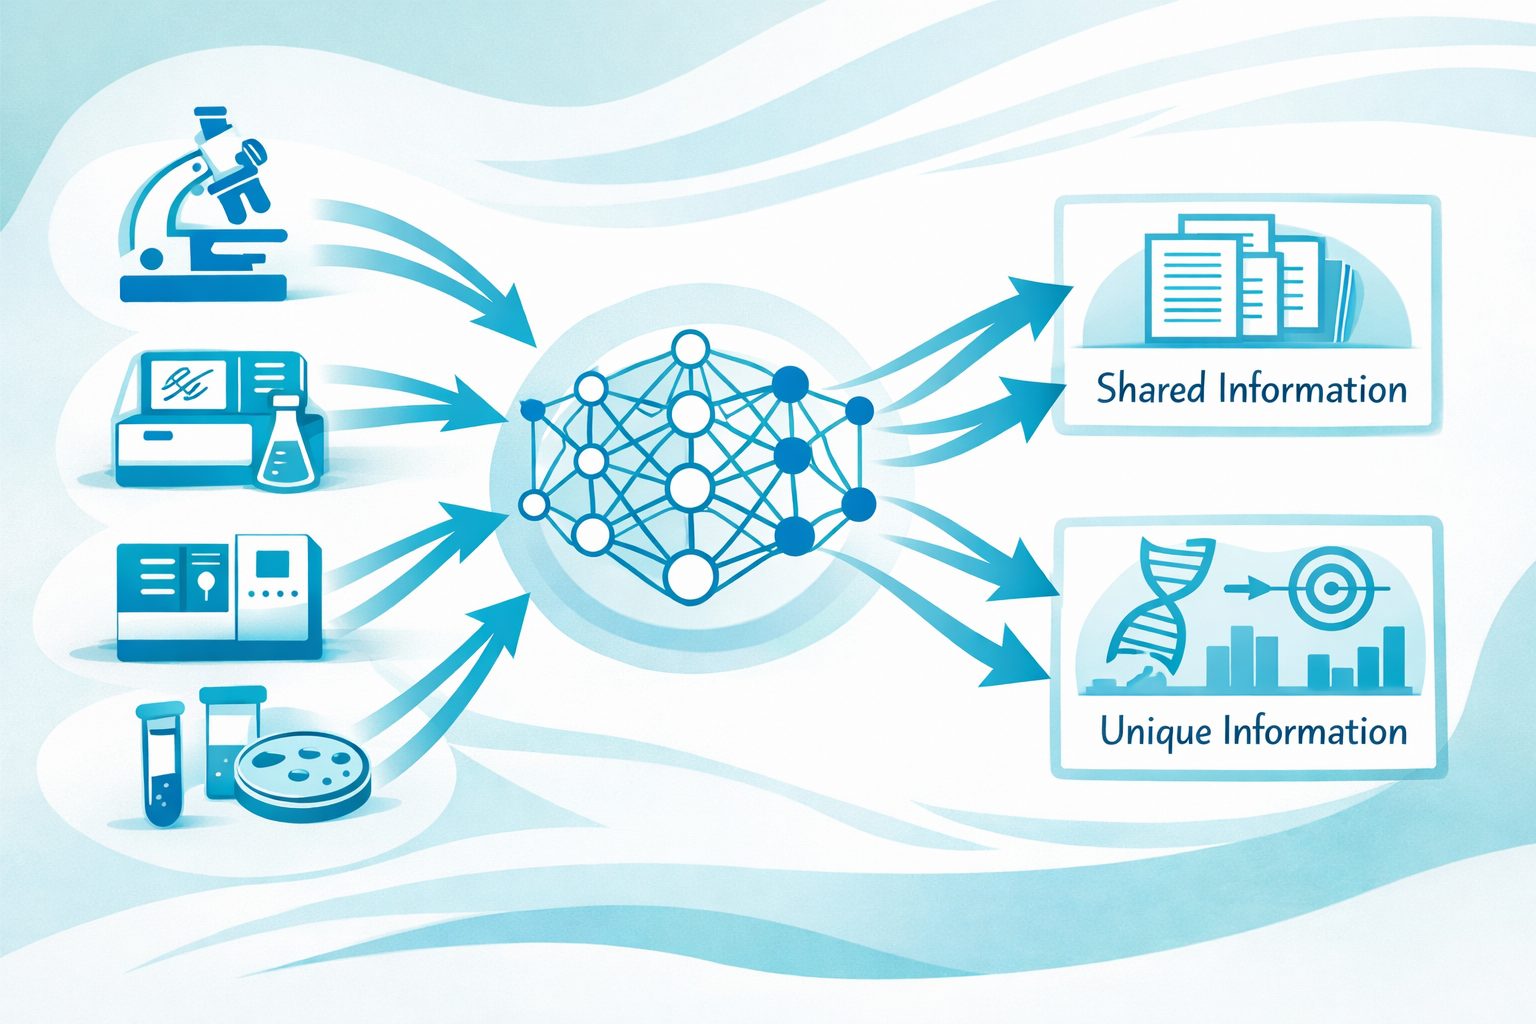
MIT・Broad InstituteおよびETHチューリッヒ/PSIの研究チームは、この課題を解決するために新しい機械学習フレームワークを構築しました。MIT Newsによれば、このフレームワークは複数のモダリティ間で重複する情報と、特定のモダリティにのみ存在する情報を自動的に区別して学習します。
技術的な構造としては、機械学習モデルの一種であるオートエンコーダ(入力データを圧縮・再現することで特徴表現を学習するモデル)を改変した設計を採用しています。通常のマルチモーダル解析では、各計測手法ごとに独立したモデルが置かれ、それぞれが別々の表現を学習します。これに対し、今回開発されたフレームワークでは、複数のモダリティに共通する情報を格納する「共有表現空間」と、各モダリティ固有の情報を格納する「固有表現空間」の両方を持つ構造になっています。研究チームはこれを「細胞データのベン図」と表現しており、直感的にイメージしやすい説明と言えます。
また、複数のデータモダリティにまたがる共有・非共有情報の分類という複雑な問題に対応するために、2段階の訓練手順が採用されています。訓練後は、モデルが未見の細胞データを入力として受け取った場合でも、共有情報と固有情報を自動的に識別できます。シングルセル解析(個々の細胞を個別に解析する手法)のような高次元データの扱いにおいて、こうした識別能力は研究の再現性と効率向上に寄与すると考えられます。
検証結果:合成データから実データまで
MIT Newsの報告によれば、合成データセットを用いたテストでは、既知の共有情報とモダリティ固有の情報を正確に識別することが確認されました。さらに、実際のシングルセルデータセットに適用した際には、トランスクリプトミクス(遺伝子発現の網羅的解析)とクロマチンアクセシビリティ(DNAの構造的開閉状態の解析)という2つのモダリティ間で共有される遺伝子活性を包括的かつ自動的に識別する一方、各モダリティに固有の情報も正確に特定できたとされています。
加えて、がん患者の細胞に存在するDNA損傷の指標となるタンパク質マーカーが、どの計測手法によって捉えられているかを特定する用途にも活用されています。このような情報は、臨床研究者がどの計測技術を優先すべきかを判断する際に直接的な指針になると思います。
研究を主導したシニア著者のCaroline Uhler氏(MIT電気工学・コンピュータ科学科教授)は、「すべてのモダリティを計測することは現実的に不可能であり、どれを計測してどれを予測するかを選択するためのツールが必要だ」と述べており、本フレームワークがその問いに答えるものだと説明しています。
今後の展望
研究チームは今後、モデルが提供する細胞状態に関する情報の解釈可能性をさらに高めることや、細胞情報の識別が正確に行われているかを確認するための追加実験を実施する予定です。また、より幅広い臨床的な問いへの適用も視野に入れています。本研究はEric and Wendy Schmidt Center at the Broad Institute、スイス国立科学財団、米国国立衛生研究所(NIH)、米国海軍研究局(ONR)、AstraZeneca、MIT-IBM Watson AI Lab、MIT J-Clinic for Machine Learning and Health、Simons Investigator Awardなどの資金援助を受けています。
まとめ
本稿では、MITとETHチューリッヒ等の研究チームが開発した、細胞の複数の計測モダリティから共有・固有情報を自動識別するAIフレームワークを紹介しました。複雑な細胞データの整理を自動化するこのアプローチが、がんや神経変性疾患の研究においてどのような成果につながるか、今後の展開が注目されます。