はじめに
Moonshot AIのKimi Teamが2026年7月27日、大規模言語モデル「Kimi K3」の技術報告書をarXivで公開しました。総パラメータ2.8兆、文脈長100万トークンのオープンウェイトモデルについて、構成から学習手法、計算基盤、評価までを網羅した文書です。本稿では、この論文を項目ごとに解説します。
解説論文
- 論文タイトル: Kimi K3: Open Frontier Intelligence — Technical Report of Kimi K3
- 論文URL: https://arxiv.org/pdf/2607.24653
- 発行日: 2026年7月27日(arXiv:2607.24653v1)
- 発表者: Kimi Team(Moonshot AI)
関連記事
要点
- Kimi K3は総パラメータ2.8兆・活性化パラメータ1,042億のMixture-of-Expertsモデルであり、ネイティブな視覚処理能力と100万トークンの文脈長を備えるオープンウェイトモデルである
- Kimi Delta Attention(KDA)、Attention Residuals(AttnRes)、Stable LatentMoEという3つの機構により、系列長・深さ・幅の各方向へ情報の流れを拡張し、Kimi K2比で約2.5倍のスケーリング効率を達成したとされる
- 事後学習では一般・エージェント・コーディングの3領域と3段階の推論努力度でそれぞれ強化学習を行い、生成された9つの専門家モデルを多教師オンポリシー蒸留で単一モデルに統合している
- 2.8兆パラメータかつ100万トークンという規模を成立させるため、完全負荷均衡の専門家並列MoonEP、再開可能なマイクロVMサンドボックス、KDA対応プレフィックスキャッシュなどの基盤技術が併せて開発された
- 総合性能はClaude Fable 5とGPT-5.6 Solに次ぐ水準であり、評価対象となった他のオープンモデル・プロプライエタリモデルを一貫して上回るとされる。モデル重みは全公開されている
詳細解説
Abstract(要旨)
論文の要旨では、Kimi K3が総パラメータ2.8兆・活性化パラメータ1,042億のMixture-of-Experts(MoE、複数の専門家サブネットワークのうち一部だけを選んで使う疎な構造)モデルであり、ネイティブな視覚能力と100万トークンの文脈窓を備えると述べられています。基盤となるのはKimi Delta AttentionとAttention Residualsで、これらが系列長方向と深さ方向の情報の流れを改善します。Stable LatentMoEは896個のルーティング専門家のうち16個をトークンごとに活性化し、これらの改良と学習・データレシピの精緻化を合わせて、Kimi K2比で約2.5倍のスケーリング効率が得られたとされています。
事後学習の要点として、一般・エージェント・コーディングの各領域と複数の推論努力度にまたがる強化学習が挙げられ、これが構成的な汎化と長期タスクの安定実行を可能にしたと説明されています。総合性能ではClaude Fable 5とGPT-5.6 Solという最上位のプロプライエタリモデルにはなお及ばないものの、評価スイート内の他のモデルは一貫して上回ると報告されています。
なお「オープンウェイト」とは、モデルの重みパラメータが公開され、手元の環境でも実行・改変できる形態を指します。学習データや学習コードまで公開する狭義のオープンソースとは区別されることが多い点は、読む際に押さえておくとよいと思います。
1 Introduction(序論)
序論では、LLMのスケーリングに2つの軸があるという整理が提示されます。第一の軸は、より大きなモデルをより多くのデータで学習させる、配備前の計算量への投資です。第二の軸は、推論時計算(test-time computation)で、OpenAIのo系列、Anthropicの拡張思考モデル、DeepSeek-R1、Kimi K1.5などがこの方向を切り開いてきたと位置づけられています。
論文が問題として挙げるのは、オープンソースのモデル群が第二の軸では急速に進歩した一方、第一の軸では進歩が遅く、多くが1兆パラメータ級かそれをやや超える程度にとどまっている点です。同程度の規模の事前学習基盤に対して高度な推論・エージェント強化学習を適用し続ければ、オープンソースの進歩は収束し、最強のプロプライエタリシステムとの差は広がりかねない、というのが著者らの見立てです。Kimi K3はこの2軸を同時に押し進める試みとして、事前学習基盤を3兆パラメータ級へ、強化学習と推論努力度と長期的な対話を100万トークン文脈で拡張する、と述べられています。
貢献は4点にまとめられています。第一に、1Mトークン文脈を持つ2.8兆パラメータのネイティブマルチモーダルMoEの事前学習。第二に、複数の推論努力度にわたる推論時スケーリングのための強化学習と、その能力の単一モデルへの統合。第三に、多兆パラメータ・百万トークン規模を支える計算基盤。第四に、モデル重みの全公開です。
2 Model Architecture(モデルアーキテクチャ)
アーキテクチャは、情報の流れを3つの相補的な次元に沿って拡張する設計とされています。系列長方向にはHybrid Attention(3層のKDA+1層のGated MLA)、深さ方向にはAttention Residuals、幅方向にはStable LatentMoEが対応します。視覚については、MoonViT-V2が画像と動画を符号化し、軽量なプロジェクタが視覚特徴を共有埋め込み空間に写像します。これらにPer-Head Muonを加えたものが、Kimi K3の全体構成です。
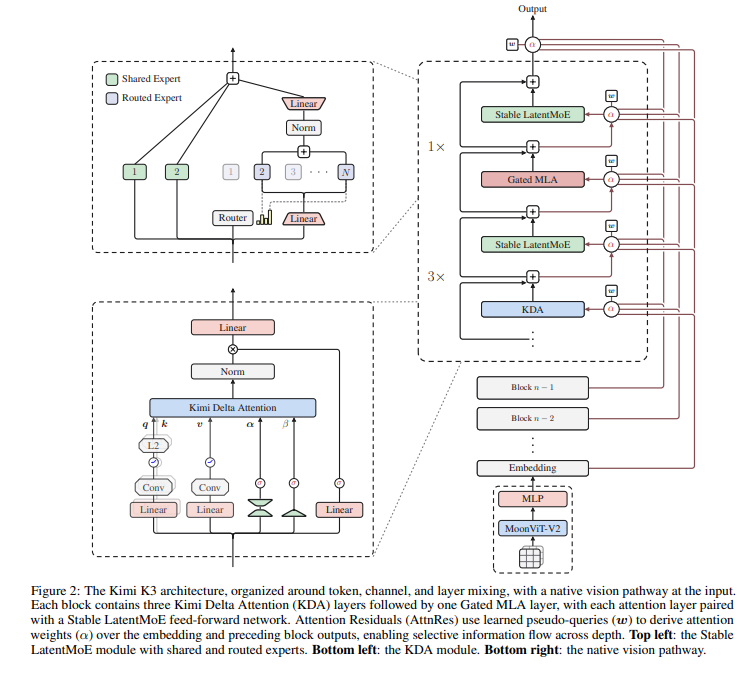
この「トークン・層・チャネルの3方向に情報の流れを広げる」という整理は、個々の工夫を並べるだけでなく、なぜその工夫が必要かを一貫した枠組みで説明している点で、読み手にとって理解しやすい構成だと思います。
2.1 Hybrid Attention(ハイブリッドアテンション)
Kimi K3は線形アテンションとグローバルアテンションを層ごとに混合します。1ブロックあたり3層のKDAと1層のGated MLAで、混合比は3対1です。このパターンがバックボーン全体で繰り返され、加えてバックボーン末尾にGated MLA層が1つ追加され、最終層が必ずグローバルアテンションを行うようになっています。
線形アテンションは、通常のSoftmaxアテンションが系列長の2乗に比例する計算量を要するのに対し、固定サイズの内部状態を逐次更新することで系列長に比例する計算量に抑える手法群です。長文脈では計算量の削減効果が大きい一方、表現力ではグローバルアテンションに劣るとされるため、両者を層単位で混ぜる設計が近年よく採られています。
2.1.1 Kimi Delta Attention(Kimi Delta Attention)
KDAはデルタ則の漸化式にチャネル単位の忘却ゲートを加えた機構です。トークン位置を \( t \)、クエリ・キーを \( q_t, k_t \)、値を \( v_t \)、再帰状態を \( S_t \) とすると、状態更新はチャネル単位の減衰をデルタ則更新の前に適用する形で書かれます。
$$ S_t = \left( I – \beta_t k_t k_t^{\top} \right) \mathrm{Diag}(\alpha_t) S_{t-1} + \beta_t k_t v_t^{\top}, \qquad \tilde{o}_t = S_t^{\top} q_t $$
ここで \( \alpha_t \in (0,1)^{d_k} \) はチャネルごとの1ステップ保持係数、\( \beta_t \in (0,1) \) はデルタ則の書き込み強度を制御します。クエリとキーはShortConvとSwishを経てL2正規化され、減衰ロジットは低ランク射影とヘッド固有バイアスから生成されます。
Chunkwise parallel form(チャンク単位の並列形式) KDAはチャンク間では再帰的、チャンク内では並列に計算されます。チャンクサイズ \( C \) に対して累積減衰を定義し、UT変換を用いて擬似値項を構成することで、チャンク内の全出力を「前チャンクからの寄与(inter-chunk)」と「チャンク内の相互作用(intra-chunk)」の和として一括計算します。因果性は下三角マスクで担保されます。
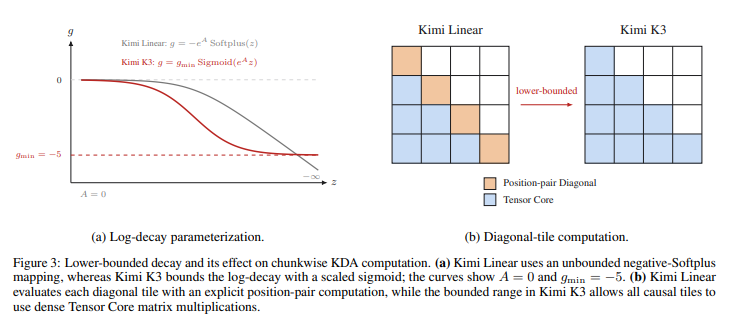
Lower-bounded decay(下限付き減衰) この定式化ではキーを累積減衰の逆数で再スケールするため、保持係数の積が小さくなると逆数が発散し、有限精度で桁あふれする危険があります。Kimi Linearは対数空間での相対減衰計算と16トークンのタイル分割でこれを抑えていましたが、対角タイルは位置ペアごとの明示的計算が必要で、チャンク内計算の主要なボトルネックとして残っていました。Kimi K3は減衰ロジットから対数減衰への写像を、スケール付きシグモイドによって下から抑える形に変更します。
$$ g_t^{h} = g_{\min},\mathrm{Sigmoid}!\left( e^{A_h} z_t^{h} \right) \in (g_{\min}, 0)^{d_k}, \qquad \alpha_t^{h} = \exp!\left( g_t^{h} \right) $$
\( g_{\min} = -5 \) と固定することで、あらゆる保持係数が \( e^{-5} \approx 6.7 \times 10^{-3} \) を上回り、16トークンタイル上の累積対数減衰は \( (-80, 0) \) の範囲に収まります。逆数の再スケール係数は \( e^{80} \) 未満となり、BF16の動的範囲に収まるため、対角タイルと非対角タイルの双方を密行列積としてTensor Coreで処理できるようになります。数値的な安定化がそのままカーネル実装の簡素化と高速化につながっている点は、アルゴリズムとシステムの協調設計の分かりやすい例だと思います。
Full-rank gate(フルランクゲート) KDAの出力ゲートは、Kimi Linearの低ランク表現から入力依存のフルランク射影へ変更されました。再帰出力にヘッド単位のRMSNormを適用したうえで、データ依存の出力ゲーティングを行います。
$$ y_t = W_o\left[ \mathrm{Sigmoid}(W_g x_t) \odot \mathrm{RMSNorm}(\tilde{o}_t) \right] $$
2.1.2 Gated MLA(ゲート付きMLA)
Multi-head Latent Attention(MLA)はDeepSeek-V2で導入された機構で、各トークンのキー・値表現を低次元の潜在ベクトルに圧縮します。ヘッドごとの完全なキー・値をキャッシュする代わりに潜在ベクトルのみを保持し、アテンション計算時に学習済みのアップ射影で再構成することで、KVキャッシュの容量を抑えつつグローバルなトークン間相互作用を保ちます。
Kimi K2やKimi K2.5と異なり、Kimi K3はKimi Linearの設計に従ってすべてのMLA層にNoPE(位置符号化を一切適用しない方式)を採用しています。位置に敏感な系列混合は間に挟まるKDA層が担い、MLA層は制約のないグローバルな内容的相互作用を担当するという役割分担です。この分離により、文脈長を延ばす際にRoPEの周波数基数を調整したりYaRNを適用したりする必要がなくなる、と説明されています。
$$ y_t = W_o\left[ \mathrm{Sigmoid}(W_g x_t) \odot \tilde{o}_t \right] $$
加えて、Flash Attentionで生じる丸め誤差の偏りを補正するため、学習時にはアテンション出力をFP32のまま保持します。これは出力タイルのオンチップ占有量を倍増させるため、学習カーネルを再設計し、出力タイルをクエリタイルではなくKVステージングバッファと重ねることで共有メモリを確保し、より深いKVパイプラインと高い学習スループットを得ています。
2.2 Attention Residuals(アテンション残差)
通常の残差接続は、深さ方向のすべての過去情報を単一の状態に圧縮します。論文はこれを「時間方向におけるRNNのボトルネックを想起させる」と表現します。系列モデリングでは、Transformerが再帰をアテンションに置き換えることで各位置がデータ依存の重みで過去全体に選択的にアクセスできるようにしました。Attention Residualsは、同じ方法論を深さ方向に適用します。
Full Attention Residuals(完全アテンション残差) 各層 \( l \) に層固有の学習可能な擬似クエリ \( q_l = w_l \) を定義し、キーと値には埋め込みおよび先行する各層の出力を用います。注意重みはSoftmaxカーネルに従い、キーにRMSNormを挟むことで出力の大きい層が重みを支配することを防ぎます。
$$ \alpha_{i \to l} = \frac{\phi(q_l, k_i)}{\sum_{j=0}^{l-1} \phi(q_l, k_j)}, \qquad h_l = \sum_{i=0}^{l-1} \alpha_{i \to l} \cdot v_i $$
ネットワークの深さは \( L < 100 \) と控えめなので \( O(L^2 d) \) の演算量は許容範囲ですが、全層の出力を保持する \( O(Ld) \) のメモリとパイプライン並列時の通信が実務上の負担になります。
Block Attention Residuals(ブロックアテンション残差) そこで \( L \) 層を \( N \) 個のブロックに分割し、ブロック内では層出力を総和で1つの表現にまとめ、ブロック間だけで \( N \) 個のブロック表現に対する完全アテンションを行います。これによりメモリと通信のオーバーヘッドは \( O(Ld) \) から \( O(Nd) \) へ下がり、推論時の状態量も有界になります。経験的には \( N \approx 8 \) で大部分の効果が得られるとされ、Kimi K3では12層ずつ8ブロックに分割し、埋め込み層を数えると計9ブロックとなる構成が採られています。
2.3 Stable LatentMoE(安定化LatentMoE)
専門家の総数と活性化数を同時に増やせば専門化の空間は広がりますが、従来のMoEでは選ばれた各専門家がフル次元のトークン表現を受け取るため、通信量と専門家重みのトラフィックがルーティング多重度に比例して増えてしまいます。LatentMoEは、モデル全体の幅とルーティング専門家の幅を分離することでこの問題に対処します。共有専門家はフル幅の経路を保ち、専門化されたルーティング専門家は幅 \( \ell \) の潜在空間で動作します。
$$ u = \sum_{i \in T_k(x)} p_i E_i^{\mathrm{routed}}(W_{\downarrow} x), \qquad y = \sum_{j=1}^{N_s} E_j^{\mathrm{shared}}(x) + W_{\uparrow},\mathrm{RMSNorm}(u) $$
この仕組みによってKimi K3は896個のルーティング専門家をトークンあたり16個の活性化で運用でき、疎性は56に達します。ただしこの極端な疎性は、素朴な設計の2つの failure mode を増幅すると論文は指摘します。第一に、ルーティング経路がダウン射影・ゲート付き多分岐FFN・アップ射影というほぼ4連続の行列積となり、条件の悪い構造と2.8兆という規模が組み合わさって内部活性値の発散を招きます。第二に、およそ10の3乗個の専門家の負荷均衡は、既存の補助損失を使わないバイアス更新が正常に機能する範囲を超えます。Stable LatentMoEはこれらに対し、アップ射影前のRMSNorm、SiTU-GLU、Quantile Balancingの3要素で対応します。共有専門家の数は全層で \( N_s = 2 \) に固定されています。
2.3.1 Normalized LatentMoE(正規化LatentMoE)
元のLatentMoEは集約されたルーティング表現に直接アップ射影を適用しますが、その大きさは選ばれた専門家とルーティング重みによって変動します。Kimi K3は専門家集約とアップ射影の間にRMSNormを挿入し、フル幅の共有分岐と合成される前のスケール変動への感度を下げます。学習の安定化に加えて、検証損失と下流ベンチマークが一貫して改善したと報告されています。
2.3.2 Sigmoid Tanh Unit GLU(シグモイド・タンユニットGLU)
Gated Linear Unit(GLU)はシグモイドで活性化したゲートによって線形の値分岐を変調する構造で、SwiGLUはそのゲートをSwishに置き換えた構造です。SwiGLUは大規模言語モデルのFFN設計として広く採用されてきましたが、2つの乗算因子がいずれも上に有界でないため、大きな座標が重なると活性値の外れ値が生じ、低精度演算での桁あふれリスクが高まります。一方、元のGLUのシグモイドゲートは無制限な増大を避けられるものの、Swishが持つ正側のほぼ線形な応答を失います。
SiTU-GLUは、平滑な上限 \( \mathrm{softcap}(x, \beta) = \beta \tanh(x/\beta) \) をSwishゲートの線形因子とアップ分岐の双方に独立に適用することで、この折り合いをつけます。
$$ \text{SiTU-GLU}(x) = \left[ \beta_1 \tanh!\left( \frac{W_g x}{\beta_1} \right) \odot \mathrm{Sigmoid}(W_g x) \right] \odot \left[ \beta_2 \tanh!\left( \frac{W_u x}{\beta_2} \right) \right] $$
Kimi K3では \( \beta_1 = 4 \)(ゲート分岐)、\( \beta_2 = 25 \)(アップ分岐)が設定されています。スケール付きtanhは原点付近ではほぼ線形、大きな値では有界となるため、SwiGLUの局所的な応答を保ちながら積の両因子を制御できる、というのが設計の狙いです。
2.3.3 Quantile Balancing(分位点均衡)
Kimi K3は補助損失を用いないルーティングを採用し、負荷均衡は専門家固有のバイアス \( b_j \) をルータのスコアに加算してTop-k選択に用いることで実現します。バイアスは混合重み \( p_{i,j} \) の計算からは除外されるため、ディスパッチだけを調整し、ルータの勾配最適化には影響しません。
従来手法は固定ステップの符号則でバイアスを更新しますが、ステップ幅が適応の遅さと負荷の振動のトレードオフを生みます。LatentMoEが専門家プールを層あたり896個へ拡張すると、この均衡維持はいっそう難しくなります。Quantile Balancing(QB)は、各専門家のバイアスを目標負荷に対応するルータスコアの分位点から直接設定する手法です。
$$ \hat{b}j^{(t+1)} \leftarrow -,\mathrm{quantile}{1 – k/n}\left( s_{:,j} – \alpha^{(t)} \right), \qquad b^{(t+1)} \leftarrow \hat{b}^{(t+1)} – \mathrm{mean}!\left( \hat{b}^{(t+1)} \right)\mathbf{1} $$
ここでカットオフ \( \alpha^{(t)} \) は、Top-kの代わりにTop-(k+1)を計算することで得られます。更新は次のステップから有効になるため、あるバッチが自分自身から導かれたバイアスでルーティングされることはありません。バイアスは推論時には凍結されます。
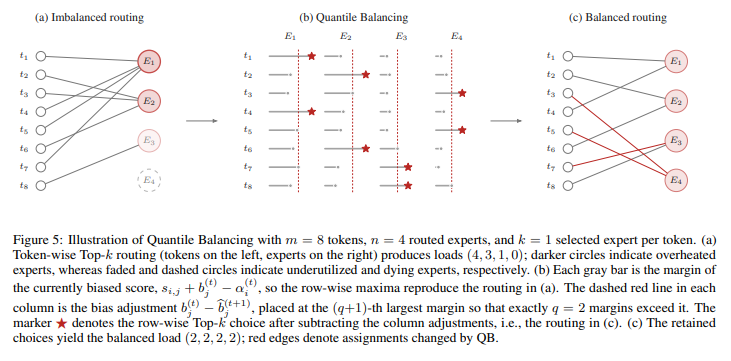
Histogram estimation(ヒストグラムによる推定) 実際の学習では、分位点はグローバルバッチ全体にわたり、マージンの数は数百万に達してランクと勾配累積ステップにまたがって分散しています。厳密な分位点のために全てを集約するのは現実的でないため、各専門家のマージンのヒストグラムから分位点を読み取ります。ランクごとのビンカウントを1回のall-reduceで合算するだけでよく、カウントは加算的なのでトークンがどう分割されていても集約後のヒストグラムはグローバルバッチを表現します。通信コストは専門家あたり数百ビン程度に収まります。
2.4 Native Vision(ネイティブな視覚処理)
Kimi K3はネイティブにマルチモーダルであり、テキスト・画像・動画が単一の共有バックボーンによって1つの文脈内で処理されます。事後的なモダリティ整合の段階は置かれていません。この設計により、レンダリング結果とそれを生成したコードが同じトークン列に共存し、モデルはコードを書き、結果のスクリーンショットや動画フレームを検査し、UI・グラフィックス・動画といった視覚的成果物をモデル間の受け渡しなしに反復改善できる、と説明されています。
MoonViT-V2 Kimi K2.5からの大きな変更点は、視覚エンコーダMoonViT-V2を次トークン予測によって完全にゼロから学習させたことです。従来はSigLIPのような対照学習で事前学習されたモデルから初期化するのが一般的でしたが、著者らはこれを主に学習の安定性の観点から改めています。SigLIPで初期化したMoonViT-3Dは勾配ノルムが持続的に高くスパイクも頻発するのに対し、MoonViT-V2は学習を通じて安定していたとされます。次トークン予測での学習は、表現が言語モデリングの目的関数によって直接形作られることも利点として挙げられています。視覚評価ではSigLIP初期化のベースラインと同等であり、大規模なマルチモーダル言語モデルにおいて対照学習による事前学習は初期化として必須ではない、というのが著者らの結論です。
Architecture(アーキテクチャ) MoonViT-V2は約4億パラメータ・27層のVision Transformerで、RMSNormを採用し、線形射影とアテンション射影からバイアス項をすべて除去しています。画像と動画は完全に共有されたパラメータで処理され、アテンションはフレーム内の空間方向とフレーム間の時間方向に分解されます。射影の前には2×2のピクセルシャッフルによるダウンサンプリングが入り、視覚トークン数を4分の1に削減することで、最大3584×3584ピクセルの入力を100万トークン文脈のなかで扱えるようにしています。
2.5 Per-Head Muon(ヘッド単位のMuon)
Kimi K3はKimi K2に続きMuonを行列パラメータの最適化器として採用し、アテンション射影についてはヘッド単位の変種へ精緻化しています。Q・K・V射影行列全体にNewton–Schulz直交化を適用する代わりに、モーメンタム行列をヘッド次元に沿って分割し、各ヘッドのブロックを別々に直交化します。行列全体での直交化はすべてのヘッドを1つの結合ブロックとして扱うため、勾配やモーメンタムのスケールが大きいヘッドが共有される更新方向を支配し、小さいヘッドは十分に正規化されない、というのが動機です。実務上はヘッド間の学習ダイナミクスがより均衡し、大規模化時の安定性が改善したほか、最適化器のオーバーヘッドもわずかに減ったとされています。
3 Pre-Training(事前学習)
3.1 Pre-Training Data(事前学習データ)
事前学習コーパスはWeb Text、Code、Mathematics、Knowledgeという4つの主要テキスト領域と、大規模な視覚コーパスから構成されます。視覚データはキャプション、画像とテキストが交互に並ぶ文書、OCR、知覚、動画、視覚的コーディングデータを含みます。
Text data(テキストデータ) 各領域はルールベースのヒューリスティック、分類器による品質スコアリング、重複除去を組み合わせてフィルタリングされ、領域ごとのサンプリング率は小規模モデルでのアブレーション実験から決定されます。知識と数学のコーパスは、Kimi K2の書き換えレシピに従い、文体と視点を多様化したプロンプト、チャンク単位の自己回帰生成、元文書に対する忠実性検証を経て書き換えられます。
Vision data(視覚データ) 視覚コーパスはKimi K2.5の分類体系に従い、オープンソースのコレクションと自社のフィルタリング・合成・重複除去パイプラインを組み合わせています。学習時には座標の教師信号が絶対値と \( [0,1] \) 正規化の両形式で与えられ、精密かつ解像度に頑健な位置特定が可能になります。加えて、SVG、3Dアセット、Webページ、ゲーム、CAD図面といった領域固有の形式について、コード片とそのレンダリング結果を対にしたプログラム的マルチモーダルデータが大幅に拡充されています。
3.2 Scaling Law(スケーリング則)
アーキテクチャ・データ・学習の改良は最適な学習条件そのものを変えるため、バッチサイズ、学習率、パラメータあたりトークン数(TPP)、モデル形状といった主要ハイパーパラメータを再調整するスケーリング則の研究が行われました。分布外の検証データで評価した結果、これらの改良が総合して約2.5倍のスケーリング効率をもたらしたとされています。
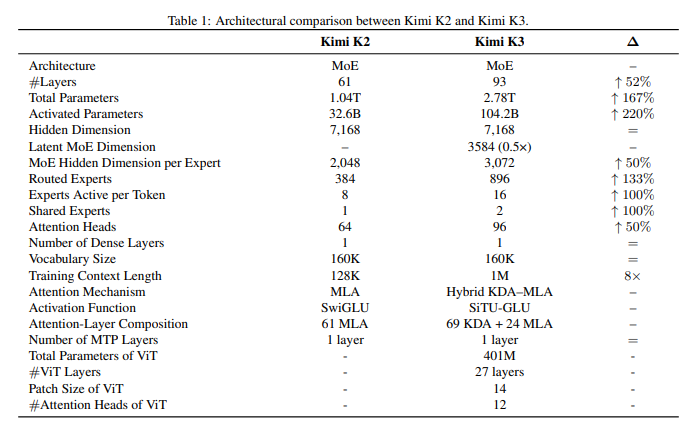
論文のTable 1はKimi K2とKimi K3のアーキテクチャを対比しています。層数は61から93へ(52%増)、総パラメータは1.04兆から2.78兆へ(167%増)、活性化パラメータは326億から1,042億へ(220%増)、ルーティング専門家は384から896へ、トークンあたりの活性化専門家は8から16へ、共有専門家は1から2へ、アテンションヘッドは64から96へと拡張されています。学習時の文脈長は128Kから1Mへと8倍になり、アテンション機構はMLA単独からKDA–MLAのハイブリッド(KDA 69層+MLA 24層)へ、活性化関数はSwiGLUからSiTU-GLUへ置き換わりました。隠れ次元7,168と語彙サイズ160Kは据え置かれています。
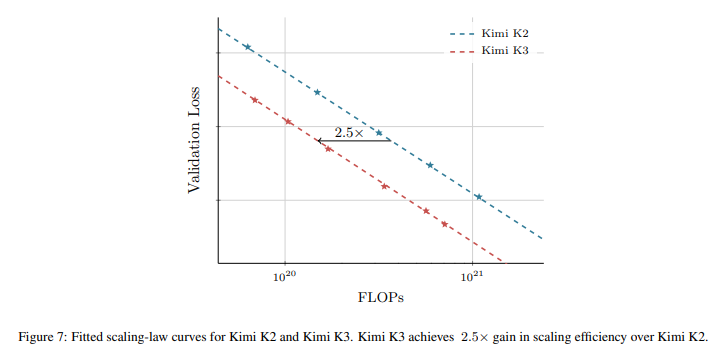
学習率スケジュール スケーリング則の研究では、Warmup Stable Decay(WSD)よりもコサイン減衰が一貫して支持されたと報告されています。興味深いのは、両スケジュールの比較方法についての指摘です。同じモデルサイズと学習トークン予算であっても最適なピーク学習率とバッチサイズは大きく異なるため、共通のハイパーパラメータで比較すると、たまたまそちらに適合していた方が有利に見えてしまう。そこで各スケジュールについて独立にスケーリング則の探索を行った結果、それぞれの最適設定のもとでコサイン減衰が一貫して低い最終損失を達成した、という流れです。ベンチマーク比較の設計そのものに注意を払った記述で、他の技術比較を読む際にも参考になる観点だと思います。
3.3 Training Recipe(学習レシピ)
Kimi K3は、事前学習済み言語モデルに視覚エンコーダを後付けするのではなく、言語と視覚を学習開始時から同時に最適化するネイティブなマルチモーダル学習戦略を採ります。視覚トークンとテキストトークンは単一の次トークン予測の目的関数のもとで交互に配置され、共有バックボーンが最初から統一的なマルチモーダル表現を学習します。最適化にはPer-Head MuonとKimi K2で導入された重みクリッピングを用い、MoEの負荷均衡にはQuantile Balancingを採用します。学習率は1%の線形ウォームアップを伴うコサインスケジュール、重み減衰は0.1で一貫しています。事前学習は文脈長8kから始まり、後続の段階で64kへ拡張されます。
3.4 Long-Context Extension(長文脈への拡張)
Positional encoding(位置符号化) Kimi K3は明示的な位置埋め込みを用いず、位置情報はKDAの再帰的なゲーティングと減衰の機構によって暗黙的に符号化されます。その結果、RoPEの再スケーリングや補間といった位置符号化の変更なしに、100万トークン文脈へ直接外挿できると説明されています。
Long-context data(長文脈データ) 自然な長文書や長尺動画には、ほぼ重複した内容、バイナリの塊、切り詰められたファイル、無効な機械生成ログなど低品質なコンテンツが多く含まれます。そのため、厳密・曖昧の両方の重複除去、動画についてはフレームの知覚ハッシュ、ヒューリスティックと分類器による品質フィルタリング、構造検証を組み合わせた専用のクリーニングパイプラインが用意されました。真に長く一貫した文書や動画は短いテキストに比べて希少なため、クールダウン時に短い系列に埋もれないようアップサンプリングされます。
ただし、長さそのものが長距離の能力をもたらすわけではないと論文は述べます。そこで、マルチモーダル文書とサブタスクを慎重に並べ替え・連結することで追加の長文脈データを合成し、埋め込まれたタスクが100万トークン全体に散在する情報を参照しなければ解けないようにしています。これにより、アテンション機構が意図した規模で学習され、局所的なパターンに退化することを防いでいます。
Progressive context extension(段階的な文脈拡張) 文脈窓は4段階のカリキュラムで拡張されます。事前学習中に8Kから64Kへ、クールダウン段階で256Kから1Mへと成長させる構成です。コストの高い長系列計算を学習予算全体のごく一部に集中させることで、カリキュラムを経済的に保ちながら長距離依存への適応を段階的に進めています。
4 Post-Training(事後学習)
4.1 Method(手法)
事後学習は3段階の枠組みに従います。教師ありファインチューニング(SFT)で基本的なエージェント能力を初期化し、強化学習(RL)で推論努力度ごとに専門化した領域エキスパートを育成し、多教師オンポリシー蒸留(MOPD)でそれらを単一モデルに統合する流れです。
4.1.1 Supervised Fine-Tuning(教師ありファインチューニング)
SFT段階は後続のRLに向けた高品質なコールドスタート方策を確立します。Kimi K3ではSFTデータセットを拡張し、複雑なエージェントタスクの網羅性を大きく広げました。データ軌跡は過去のKimiシリーズの領域特化モデルを用いて合成され、多段階の検証と人間が関与するアノテーションが続きます。これらの複雑なエージェント軌跡を一貫して表現するため、全データはXTMLベースのチャットテンプレート(eXtensible Token Markup Language)で直列化されます。またSFT段階以降、MXFP4重み・MXFP8活性値による量子化認識学習(QAT)が適用されます。
4.1.2 Reinforcement Learning(強化学習)
個々のタスクごとに専門化したRLモデルを学習させるのではなく、3つの広い領域それぞれについて、各推論努力度で1つのエキスパートを訓練します。(i) 一般タスク(一般的な経験、視覚、推論、忠実性、検索能力、知識労働)、(ii) 一般エージェント(長期のアシスタントタスク、ディープリサーチ、段落単位の執筆)、(iii) コーディングエージェント(ソフトウェア工学、コーディング体験、カーネルタスク、Web開発)です。この3領域と{low, high, max}の3水準を掛け合わせ、計9つのエキスパートモデルが得られます。RLのFLOPsを増やすと、ツール呼び出しのステップ数が一貫して増加し、知識・推論・視覚・一般エージェント・コーディングの各能力が総合的に向上したと報告されています。
Algorithm(アルゴリズム) 長期タスクで顕著になるロングテールのレイテンシを緩和するため、同期RLフレームワークの部分ロールアウト方式が拡張されています。各反復のロールアウト段階では \( N \) 個のプロンプトそれぞれに \( K \) 個の応答をサンプリングし、\( N \times K \) の軌跡を並行して進めます。すべてのロールアウトの終了を待たず、割合 \( \lambda \) の軌跡が完了した時点で生成段階を一時停止し、実行の落伍者を待たずに方策最適化へ進みます。停止された軌跡はキューに入れられ、次の反復の冒頭で優先的に再開されます。これにより1つの長期軌跡が複数の反復にまたがることになり、データの陳腐化が学習の安定性を脅かしますが、トークン単位の正則化によって方策更新を局所的な近傍に制約することで、極端にオフポリシーな領域でも安定性が保たれるとされています。
Reasoning Effort RL(推論努力度のRL) 推論努力度を調整しつつトークン効率を最大化するため、問題ごとの予算制御機構が導入されています。各問題 \( x \) にコールドスタートモデルから推定した初期トークン予算 \( b_0(x) \) を対応させ、総トークン量が \( \tau \cdot b_0(x) \) を超えた軌跡には報酬 \( -1 \) を上書きします。一般タスクでは思考トークン数を、エージェントタスクでは推論トレースとツール呼び出し引数を含む累積出力トークン数を数えます。学習は予算倍率 \( \tau \) に関する段階的カリキュラムに従い、まず比較的大きな \( \tau \) で最大予算の変種を訓練し、その後 \( \tau \) を小さく焼きなましてhigh・lowのエキスパートを得ます。
Agentic Generative Reward Model(エージェント型生成報酬モデル) 検証不能な一般タスクには、トーナメント形式のグループ報酬と二値比較を用いる生成報酬モデルが採用されます。エージェント型の審判は、成果物やテキスト出力を読む、ルーブリックを生成する、各候補をルーブリックに照らして採点する、採点結果をスコアパッドに記録する、という手順の遵守を求められます。出力が冗長になる方向への報酬ハッキングを抑えるため、初期冗長度 \( \ell_0 \) と倍率 \( \sigma \) を用い、出力長が \( \sigma \cdot \ell_0 \) を超えた候補は二値比較で自動的に敗北とする制御が入っています。
4.1.3 Multi-Teacher On-Policy Distillation(多教師オンポリシー蒸留)
領域と推論努力度にまたがって専門化した能力を1つのモデルに統合するため、多教師オンポリシー蒸留が採られます。学習時には、領域 \( d \) とサンプリングされた推論努力度 \( e \in { \text{low}, \text{high}, \text{max} } \) に対応する教師モデルが9つのエキスパートから選ばれ、最適化を導きます。この密な報酬信号はRLフレームワークに自然に統合され、長期タスク向けの部分ロールアウト学習といった基盤レベルの最適化をそのまま利用できます。より細粒度のtop-k蒸留も試されましたが、収束速度・最終性能のいずれにも明確な優位は見られなかったと報告されています。
4.1.4 Deployment-Aware Post-Training(配備を見据えた事後学習)
MXFP4 Quantization-Aware Post-Training(MXFP4量子化認識事後学習) 配備時のメモリ使用量とサービングコストを削減するため、パラメータメモリの大部分を占めるMoEの専門家重みがMXFP4に量子化され、活性値はMXFP8で計算されます。アテンション射影、潜在MoE射影、共有専門家、MoEルータといった非専門家部分は高精度のまま保持されます。量子化認識学習はSFTとRLを含む事後学習の全段階にわたって行われ、RLではロールアウトと学習が同じ量子化方式を共有するため、学習と推論の不一致が解消されます。
Draft Model Fine-Tuning(ドラフトモデルのファインチューニング) Kimi K3はバックボーンブロックと同じ構造のマルチトークン予測(MTP)層を伴って事前学習されています。EAGLE-3のドラフトモデルが1つのデコーダ層からなり、その構造がMTP層と一致することから、事前学習済みMTP層をEAGLE-3形式のドラフトモデルへとファインチューニングします。学習時のドラフトは7ステップ分展開され、ドラフト入力は対象モデルの1番目・4番目・最終のAttnResブロック出力を融合した表現です。投機的デコードの高速化はトークンごとの受理率に支配されるため、通常のKLダイバージェンスの代理目的ではなく、受理率の負の対数そのものを最適化します。
$$ \mathcal{L}{\mathrm{LK}} = -\log \sum{x \in V} \min\left( p(x), q(x) \right) $$
4.2 RL Task Synthesis and Agentic Environments(RLタスク合成とエージェント環境)
4.2.1 Unified White-Box RL Environment(統一ホワイトボックスRL環境) 単一の固定されたエージェントハーネスで学習すると、特定のツールスキーマやシステムプロンプト、文脈管理機構、対話プロトコルに過適合しかねません。そこで、ツールインターフェース、システムプロンプト、文脈管理戦略、スキル、メモリ、サブエージェントなどを設定可能かつ合成可能なモジュールの集合として表現する統一環境が開発されました。これらを組み合わせることで、Kimi Code、Claude Code、Codex、OpenClaw、Hermesといった主要ハーネスに加え、まったく新しいハーネスも生成できます。
4.2.2 Knowledge-Graph-Guided Task Synthesis(知識グラフ誘導型タスク合成) 事後学習タスクの品質と多様性は元となる素材でほぼ決まります。粒度と網羅性を大規模に制御するため、エージェントがWeb規模の探索を通じて継続的に拡張する、自己進化型の階層的知識グラフが構築されました。グラフは有向非巡回グラフとして再帰的なエージェント駆動の拡張で作られ、粗い種ノードから出発して各ノードに割り当てられたエージェントが複数回のWeb検索で概念を調査します。新規ノードの追加前には既存グラフを探索して同等・関連概念を特定し、重複を最小化します。エッジは常に粗い概念から細かい概念へ向き、担当エージェントが概念を十分に原子的と判断した時点でその枝の拡張が止まります。サンプリングされたノードから導いたキーワードと祖先ノードの文脈情報がWeb検索クエリになり、取得された実世界の素材から合成エージェントが各種のタスクを生成します。
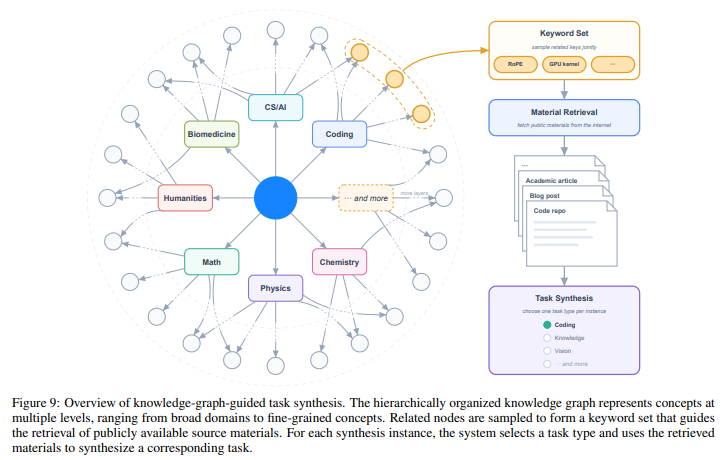
4.2.3 Verifiable Problems in Agentic Environments(エージェント環境における検証可能な問題) 代表例として、モデルが調査を計画し段階的にWebから証拠を集めて検証可能な回答を出す多段階の複雑な情報探索、投資銀行業務・データ分析・法務といった専門職の日常業務、STEM問題や視覚パズル、チャート理解に対する多段階の検証可能な視覚推論が挙げられています。視覚推論の各軌跡は、隔離されたサンドボックス内のPythonインタプリタを備えた環境で生成され、モデルはコードを書いて実行し、入力画像の切り出し・拡大・変換、精密な計算、中間結果の検証を行い、生成された画像を含む実行結果を新たな観測として受け取ります。
4.2.4 Kernel Optimization Tasks(カーネル最適化タスク) GPUカーネル最適化能力を強化するため、単一演算子のカーネルから融合メガカーネルまでを含む大規模なタスク群が、Flash Linear Attentionなどの高品質なGitHubリポジトリから構築されました。CUDA、Triton、CuTe DSL、Gluon、ThunderKittens、TileLangといった多様なGPUプログラミング手法と、BF16・FP8・FP4を含む数値形式を網羅します。報酬は正確性と性能の双方を評価し、各カーネルにはPyTorchの参照実装が付属し、所定の数値誤差の閾値を超えた解は報酬ゼロとなります。性能はエキスパート実装と比較して採点され、同等で0.5、ハードウェアのルーフラインに近づくほど1へ向かいます。CUDAグラフの再生、入力のキャッシュ、精度の低下といった報酬ハッキング戦略にはペナルティを課すハッキング検出システムが用意され、開発中に観測された新たな手口に応じて継続的に拡張されています。
4.2.5 Personal Assistant Tasks(パーソナルアシスタントタスク) 長期のアシスタントタスク向けに、Gmail、Notion、Slack、Canvasといった広く使われるアプリケーションの現実的なモック実装が開発されました。外部APIやレート制限に依存せず、再現可能で大規模な対話を可能にしながら、実物の中核的な意味論を保持します。人事、法務サービス、金融といった現実の専門業務に着想を得た複雑なタスクでは、エージェントは複数の仮想的な日にちにまたがる持続的で変化し続ける環境で動作し、アプリケーションをまたいで分布する数十の相互依存イベントに遭遇します。1回のロールアウトが数千回のツール呼び出しと数百万トークンの文脈に及ぶこともあるとされています。
4.2.6 Autonomous Execution Tasks(自律実行タスク) AETは、検証を組み込んだ最適化によって長期のエージェント知能を訓練する環境パラダイムです。各タスクは初期状態、制約付きの目標、ツールベースの行動空間、実行予算、独立した検証器を指定します。エージェントは目標・文脈・制約・検証インターフェースのみを与えられ、参照軌跡も既定の手順も持たないまま、タスク分解、ツール選択、計画、エラー回復、終了判断を自律的に行わなければなりません。報酬はエージェントの自己申告ではなく、最終的な環境状態に対する検証器の評価に基づきます。検証器にはブラックボックスのシステム複製、定量的なファクター発見、税務監査など複数の型が用意されています。報酬ハッキングは、エージェントと検証器の分離、診断的フィードバックを返す公開検証器と伏せられたシナリオを評価する隠し検証器の併用、限られた提出回数のもとでのペナルティ型報酬によって抑制されます。
4.2.7 Web Development Tasks(Web開発タスク) 入力は1行のシーン記述から複数段落の仕様まで幅があり、成果物はWebサイト、インタラクティブなゲーム、3D/WebGLシーン、データ可視化、SVG、フルスタックアプリケーションに及びます。各タスクはコンテナ化されたサンドボックスで実行され、単一の固定ハーネスではなく多様なエージェント足場のもとでロールアウトされます。報酬は決定的なチェックと内部報酬モデルによるモデル判定の2要素からなり、プロジェクトのビルド失敗、エラー実行、成果物を実装せずに見せかけただけの場合には報酬がゼロになります。
5 Infrastructure(計算基盤)
Kimi K3は、ハイブリッドKDAアテンション、3兆パラメータ級の疎なマルチモーダル学習・推論、100万トークンのエージェントワークロードという、単一のモデルではまれにしか同時に生じない3つのシステム課題を抱えます。計算基盤はこれらと協調設計されています。
5.1 Algorithm-System Co-Design for KDA(KDAのアルゴリズム・システム協調設計)
KDAはSoftmaxアテンションの増大するKVキャッシュを固定サイズの再帰状態に置き換えます。逐次更新は並列実行の妨げになりますが、その代わりに転送も再利用も安価な固定サイズの状態が得られます。
5.1.1 KDA Kernels across Regimes(実行局面ごとのKDAカーネル) チャンク単位の形式はチャンク内では並列、チャンク間では逐次であるため、素朴に実行すると再帰的な状態伝播の間にSM(Streaming Multiprocessor)が遊びます。そこでCUTLASSベースのチャンク単位カーネルFlashKDAが開発され、チャンク内計算とチャンク間の状態伝播を重ね合わせます。カーネルは処理をトークン並列の段階とヘッド並列の再帰に分解し、それぞれ独立にスケジューリングとチューニングを行うことで、Tritonの参照実装を大きく上回るとされています。また、テンソル並列はヘッドを分割しても再帰そのものは短くしないため、超長系列のプリフィルでは各ランクが少数のヘッドしか持たずSMの多くが遊びます。これに対しては、各セグメントの状態遷移を入力状態とは独立に評価してから正確に合成できるという観察に基づき、単一ランクのSM間で系列を分割する自動プランナが用意されています。
5.1.2 KDA Context Parallelism(KDAの文脈並列) 文脈並列の通信オーバーヘッドは、Softmaxアテンションと線形アテンションで根本的に異なります。前者は系列長に比例して大きくなるキー・値ブロックの交換を要するのに対し、線形アテンションは固定サイズの再帰状態が先行文脈を運びます。ただし、素朴な線形アテンション向けの手法は、各ランクがゼロ状態から生成した局所状態を単純に総和する前提に立っており、KDAには不十分です。KDAのデルタ則は現在の書き込みを加える前にトークン依存の行列 \( M_t \) を入力状態に適用するため、あるセグメントの効果はそのセグメントに入る状態に依存し、ゼロ状態から計算した状態だけでは決まらないからです。
$$ S_{[i+1]}^{t} = \tilde{S}{[i+1]}^{t} + M{[i+1]}^{t \leftarrow 1} \sum_{j=1}^{i} \left( \prod_{l \leftarrow j+1}^{i} M_{[l]}^{T_l \leftarrow 1} \right) \tilde{S}_{[j]}^{T_j} $$
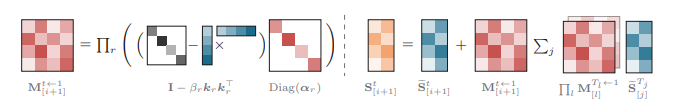
KCPは各セグメントの効果を、入力状態に作用する累積遷移と、ゼロから局所的に生成される状態という2つの局所計算可能な量に分解します。両者はセグメント末尾の時点で局所トークンのみから計算でき、ランク間の更新は結合的に合成されるため、各ランクの入力状態は接頭辞スキャンで復元できます。必要な通信は固定サイズのall-gather 1回のみで、計算量は線形にスケールします。
5.2 Infra for 3T-class Pre-Training(3兆パラメータ級事前学習の基盤)
事前学習は、仮想ステージを伴うパイプライン並列、専門家並列、ZeRO-1データ並列、Pipeline ZeRO-2の勾配シャーディング、文脈並列を組み合わせています。3兆パラメータ級のネイティブマルチモーダル事前学習では、専門家並列ランク間のトークン負荷の偏り、メモリ予算を超える活性値・勾配・最適化器状態、クリティカルパス上に露出する視覚エンコーダの変動の大きい計算という3つの問題が生じます。
5.2.1 Perfectly Balanced Expert-Parallel MoE Training(完全負荷均衡の専門家並列MoE学習) 従来の専門家並列ではランク間でトークン負荷が偏り、計算の不均衡がスループットを損なうほか、ルーティング専門家の活性値の形状が動的に変わることで大きなメモリ断片化を招きます。MoonEPは動的な冗長専門家によって完全な負荷均衡を達成する方式です。順伝播では現在のマイクロバッチと層のルータ出力から冗長専門家を計画し、ルーティング専門家の計算前にプリフェッチします。逆伝播では勾配を局所のリデュースバッファに置き、計算完了後にホームランクの勾配バッファへ還元します。著者らは、専門家数 \( E \)、専門家並列サイズ \( R \) に対して、ランクあたり最大 \( E/R \) の冗長専門家があれば均衡計画が常に存在し、この上界が本質的にタイトであることを証明しています。上界が保証されているため計画が実行不能になることがなく、学習が中断されません。加えて、完全均衡によって各ランクの受け取るトークン数が \( S \times K \) で固定されるため、計算形状が静的に定まり、層ごとのホスト同期が不要になります。
5.2.2 Memory-Efficient Training(メモリ効率的な学習) 逆伝播のために保存されるすべてのテンソルに差し替え可能なストレージバックエンドを対応づける統一的な抽象化が設計され、再計算・量子化・オフロードはこの抽象化のもとでの単なるストレージ方針として、テンソル単位で自由に組み合わせられます。Kimi K3では大半の活性値がブロック単位のFP8量子化とオフロードを併用し、要素ごとの演算子には再計算が設定されています。MoEについては、順伝播出力への逆伝播の依存を数学的変換によって取り除き、グループGEMMの順伝播ではディスパッチ操作の入力だけを保存して逆伝播時にディスパッチを再計算する方式が採られています。パイプライン並列では、ウォームアップの影響で活性値がランク間で偏るため、Mooncake Transfer Engineを用いて他のPPランクのメモリへ遠隔オフロードし、均衡を取ります。Muonの直交化についても、パラメータバッファ全体をall-gatherする素朴な方法ではなく、各ランクが自分の担当パラメータの断片だけをP2P通信で取得する方式に変更されています。
5.2.3 Multimodal Encoder Optimization(マルチモーダルエンコーダの最適化) 長文脈のマルチモーダル学習では、大きな画像や長い動画が視覚エンコーダの計算時間を押し上げ、デバイス間の負荷不均衡を生みます。そこで、1枚の大きな画像をパッチ次元で複数デバイスに分割し、CPランク間でキー・値を集めてアテンションを計算します。さらにCPグループをいくつかのサブCPグループに分け、複数の大きな画像を負荷均衡的に分配することで、規模が大きくなっても通信の割合が増えないようにしています。加えて、インターリーブ1F1Bのパイプラインスケジュールでは最初のマイクロバッチのテキスト順伝播が冒頭に、最後のマイクロバッチのテキスト逆伝播が末尾に集中することを利用し、ViTの計算の大半をパイプラインの気泡(アイドル時間)に隠しています。
5.3 Infra for 1M Agentic RL(100万トークンのエージェントRL基盤)
5.3.1 Long-context RL infrastructure(長文脈RL基盤) 1Mの文脈を持つKimi K3のRL実験を数百GPU規模に収めるため、学習とロールアウトを同居させる構成と部分ロールアウトが採られています。ここで、次の反復のために保持すべきロールアウトのKVキャッシュと、学習に必要なメモリとの間に競合が生じます。そこで、能動的にデコード中のブロックはGPU上のKVキャッシュに残し、再利用可能な休止中の接頭辞はGPUから追い出される時点でのみCPU DRAMの外部KVキャッシュプールへ書き戻し、次の再利用の前にプリフェッチする設計が採用されました。KDAの状態は対応するMLAのKVキャッシュブロックと一緒にオフロード・プリフェッチされ、ライフサイクルが揃えられます。外部プール用のDRAMを確保するため、学習状態(モデル重みと最適化器状態)は学習反復の完了後にNVMeへ退避されます。加えて、実行中のリクエスト数やKVキャッシュ利用率といった実行時の信号から推論エンジンへ送るリクエスト数を動的に制御する自動スロットリング機構が、ロールアウト初期の低利用と後期の過負荷の双方を手動調整なしに回避します。
5.3.2 Sandbox Infrastructure(サンドボックス基盤) 最も注目されるのは、Firecrackerによる隔離マイクロVM上に構築された新しいサンドボックス実行環境AgentENVです。設計目標は3つ挙げられています。第一に高忠実度の隔離実行環境で、初期の実験ではコンテナベースの実行環境で意図しないエージェント操作によるカーネルパニックやデッドロックが観測されたこと、また複雑なタスクではディスクのマウントやコンテナの実行、仮想マシンの起動といった現実に近い環境が必要であることが理由とされます。第二にエージェントRL向けの柔軟なライフサイクルで、前回のチェックポイント以降に変更されたメモリページのみを保存する増分チェックポイントにより、チェックポイントは133ミリ秒、再開は49ミリ秒という低遅延を実現しています。その上で、一時停止と再開(サンドボックスの生存時間の98%に達しうる推論待ち時間の資源を解放できる)、フォーク(副作用なしの報酬判定に有用)、スナップショット(エラー回復用)という3つの高水準操作が提供されます。第三に高効率・高密度で、OverlayBDを画像形式として採用し、独自のublkドライバ実装、ストレージ層の共有、P2P転送により、大規模でも1秒未満の起動遅延を達成しています。Kimi K3の学習と評価を通じて、1,505,678個のイメージにまたがる51,219,741個のサンドボックスが作成されたと報告されています。
5.4 Inference and Online Serving(推論とオンラインサービング)
5.4.1 KDA-Aware Prefix Cache Management(KDA対応プレフィックスキャッシュ管理) ハイブリッド構成はプレフィックスキャッシュを複雑にします。MLAのKVキャッシュは系列長とともに増えてトークンごとにページ化されるのに対し、KDAの再帰状態はサイズ固定でリクエストあたり1つだけであり、キャッシュされた接頭辞が再利用可能なのは両者を同じ境界で復元できる場合に限られるからです。そこでKDAの状態もMLAのKVと同じページ化ブロックプールに詰め込み、確保・参照カウント・追い出しの実装を共有しています。
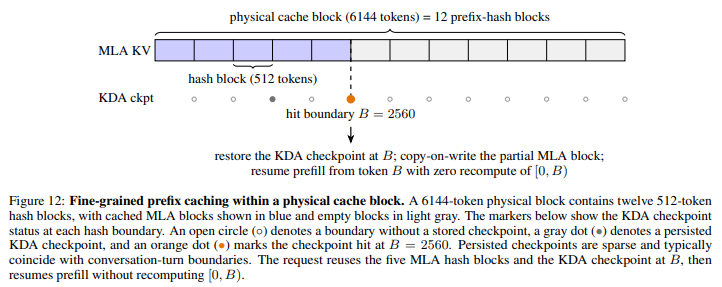
さらに、ブロックハッシュによるプレフィックスキャッシュはブロック境界に揃った接頭辞しか再利用できず、KDAの状態スナップショットが疎な境界でしか許容できないことから共有ブロックサイズが1024〜6144トークンへ押し上げられ、その粒度ではキャッシュがほとんど役に立たなくなります。Kimi K3はこの2つの粒度を分離し、プレフィックスのハッシュはMLAページ内の細かいハッシュブロック(例えば512トークン)で行い、物理ブロックは粗い確保単位のまま残します。KDAのチェックポイントはMLAのハッシュ終端の疎な部分集合にのみ保存され、参照が指しうる位置と一致します。探索は2段階で行われ、MLA段階でチェーンハッシュにより物理ブロックを照合し、最初に欠けたブロックではその内部のハッシュ終端へフォールバックします。続くKDA段階では、候補となる境界に全KDAキャッシュグループでチェックポイントが存在することを要求します。論文の例では、最初の2800トークンが一致するリクエストが6144トークンの物理ブロックの内部にある \( B = 2560 \) でヒットし、そこからプリフィルを再開できると説明されています。
5.4.2 High-Performance Kernels(高性能カーネル) KDAのデコードでは、ボトルネックが並列性の活用から、各デコードステップでその場更新される再帰状態の効率的な管理へ移ります。MTPベースの投機的デコードでは、検証がドラフトトークンの一部を棄却した場合に状態が既に進みすぎており、単純には巻き戻せません。ドラフト位置ごとに状態のスナップショットを持てば巻き戻せますが、状態のトラフィックが倍増し、オンラインサービングで典型的な大きなバッチサイズでは支配的なコストになります。受理されたドラフト接頭辞の後の状態は、状態そのものよりはるかに小さいドラフトトークンの射影済み入力から完全に決まるため、Kimi K3はこの射影済み入力だけをキャッシュし、受理トークンの状態をオンチップで再構築します。Block AttnResについてはプリフィルで系列並列を用いて各トークンのブロック表現をちょうど1つのランクにのみ実体化させ、デコードでは層間カーネルをサイドストリームで実行して主ストリームの計算と重ねます。Stable LatentMoEでは、潜在ダウン射影とMoEルータを1つのGEMMに融合し、潜在重み行列をランク間で分割してall-gatherをGEMMのエピローグに融合するなどの最適化が施されています。
5.4.3 Fleet-Level Scheduling(フリート単位のスケジューリング) 単一のサービングインスタンスを超えると、課題は1リクエストあたりの効率から予測可能性へ移ります。100万トークン文脈では、典型的なコーディング入力が40万トークンの接頭辞を持ちながらプリフィルの増分は4千トークンにすぎないため、プレフィックスキャッシュのヒットはミスより桁違いに安上がりです。そこで各リクエストは接頭辞キャッシュを保持するクラスタへルーティングされます。ただしこれはセッションを単一クラスタに束縛するため、コンシステントハッシングで各セッションを主クラスタと副クラスタの2つに固定し、障害時には副クラスタが引き継ぐ設計になっています。副クラスタの割り当ては一様に分散するため、再プリフィルの負荷が1箇所に集中しません。加えて、2千トークン未満の短いリクエストと100万トークンに及ぶ超長リクエストが混在し、1リクエストあたりのコストがおよそ3桁の幅を持つことから、リクエストの種別ごとに個別の資源予算を割り当てる受け入れ制御が導入され、長文脈トラフィックの突発が他の種別のSLOを損なわないようにしています。
6 Evaluations(評価)
6.1 Main Results(主要な結果)
評価は推論・知識、コーディング、エージェント、視覚という4つの能力軸に沿って構成されています。比較対象はプロプライエタリのClaude Fable 5、GPT-5.6 Sol、Claude Opus 4.8、GPT-5.5と、オープンウェイトのGLM-5.2です。Kimi K3の評価はすべて推論努力度max、温度1.0で行われ、単一ステップのタスクではtop-p 0.95、エージェントタスクではtop-p 1.0が用いられています。
Reasoning & Knowledge(推論・知識) 大学院レベルの推論を測るGPQA Diamondでは93.5%とフロンティアと競合する水準に達しています。一方、研究レベルのタスクでは差が残り、HLE-Fullはツールなし43.5%・ツールあり56.0%、CritPtは23.4%で、Claude Fable 5やGPT-5.6 Solに後れを取ります。著者らはこの点を今後の重要な改善方向として明示しています。
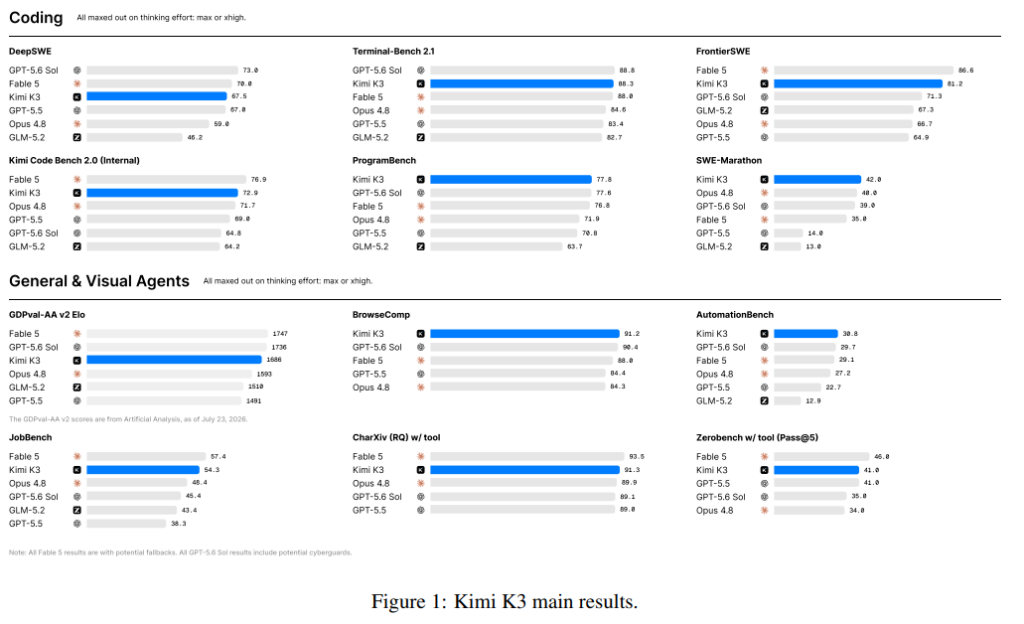
Coding(コーディング) ProgramBenchで77.8%と最高スコアを獲得し、GPUカーネル指向のSWE-Marathonでは42.0%とClaude Fable 5を7ポイント上回ります。Terminal-Bench 2.1は88.3%でGPT-5.6 Sol(88.8%)にほぼ並び、長期タスク型のFrontierSWEでは81.2%とClaude Fable 5(86.6%)に次ぐ2位です。
Agentic(エージェント) BrowseComp 91.2%、DeepSearchQA 95.0%(F1)、ResearchRubrics 76.2%、MCPMark-Verified 94.5%、AutomationBench 30.8%、SpreadsheetBench 2で34.8%、Harvey Lab-AAで94.6%と、幅広いエージェント系スイートで最高水準の結果が報告されています。主な例外はElo評価の知識労働スイートで、GDPval-AA v2は1,686で3位、AA-Briefcaseは1,548で2位と、いずれもClaude Fable 5が首位です。
Vision(視覚) Math-Visionは94.3%、Pythonツール併用で97.8%まで上昇し、難度の高いZeroBench-mainでは23.0%(pass@5)とClaude Fable 5に並び、Pythonツール併用では41.0%に達します。OmniDocBenchでは91.1%と最高スコアを記録しています。ツール併用で大きく伸びる傾向は、視覚推論が単発の知覚ではなく反復的な検証を伴う作業として扱われつつあることを示していると考えられます。
6.2 Internal Evaluation(内部評価)
6.2.1 Capability Evaluation(能力評価) 公開ベンチマークが十分に捉えられない領域を対象とする社内ベンチマーク群が維持されており、コーディング能力と体験、一般エージェント体験、対話体験の3カテゴリに大別されます。結果としては、Swarm Bench(76.3)とDeep Research Bench(90.0)で明確な差をつけて首位に立ち、複雑な目標の分解、並列作業の調整、ルーブリックを満たす成果物の生成に強みがあると整理されています。コーディングも強みで、Kimi Code Bench 2.0ではClaude Fable 5に次ぐ2位、Coding Experienceでは最高スコアを獲得しました。社内のKimi Webdev Benchでは、専門家によるブラインド評価でClaude Opus 4.8に対し総合で31.0ポイントの差をつけ、3D/WebGL/シェーダー領域では59.1ポイントと最大の差が出ています。一方、Agent Behavior Bench、MIRA Bench、24/7 ClawBench 2.0、Agentic Vision Bench、KWV Benchでは首位に届いていません。
6.2.2 Cyber Security Evaluation(サイバーセキュリティ評価) 運用上のリスクが増していく2段階の構成で評価されています。Tier 1の脆弱性発見では、OSカーネル、データベース、AIサービス、Webフレームワーク、ブロックチェーン、VPNソフトウェアなど広く配備された多数のシステムにわたって数百の脆弱性候補が特定され、人手のレビューを経たもののうち約70%が真正と確認され、6つのプロジェクトで16件の未知の脆弱性が含まれていたと報告されています。Tier 2の攻撃コード開発では、36タスク中14タスク(38.9%)を解決し、GLM-5.2の8タスク(22.2%)を上回りましたが、成功の10件はユーザ空間側に偏っており、カーネル側では両モデルとも4分の3のタスクを解けていません。全タスクは人間の専門家が解けることが確認されており、平均で1タスクあたり約15時間、全体で約540専門家時間を要すると見積もられています。著者らは残る差の要因を、既に得た原始的能力から攻撃連鎖の最終段階を仕上げられないこと、緩和策下での戦略選択の拙さ、非生産的なデバッグループへの陥り、最終成果物の検証不足の4つに帰しています。英国AI Security InstituteとNISTのCAISIによる独立評価も同様の結論に達しており、Kimi K3はGLM-5.2を上回るものの、エンドツーエンドの攻撃完遂ではフロンティアのサイバー能力を持つモデルに及ばず、41タスク中0タスクでしか任意コード実行に至らなかったとされています。
なお、AnthropicやOpenAIのフロンティアモデルはサイバー関連タスクを拒否するため比較評価が成立せず、このスイートからは除外されたと明記されています。オープンウェイトモデルの能力評価においては、こうした安全対策の設計差が比較可能性そのものに影響する点も、読む際に留意しておくとよいと思います。
6.3 Third-Party Evaluation(第三者評価)
2026年7月23日時点の第三者評価が集約されています。Artificial AnalysisのIntelligence Index v4.1では57.1で580モデル中4位(GPT-5.6 Solの努力度違いを1エントリと数えれば3位)で、Claude Fable 5(59.9)とGPT-5.6 Sol(58.9)に次ぐ位置です。Vals AIのVals Indexでは74.7%で39モデル中2位、Claude Fable 5(75.1%)に次ぎGPT-5.6 Sol(73.1%)を上回ります。人手による選好アリーナでは、WebDev Arenaで1,678 Eloと99モデル中1位となり、このリーダーボードで首位に立った初のオープンモデルとされています。Text Arenaは200モデル中8位、Agent Arenaは37モデル中4位です。
6.4 Cost Efficiency(コスト効率)
スコアだけでなく、タスクあたりのコストとの関係も4つのスイートで検証されています。Kimi Code Bench 2.0ではClaude Fable 5に4.0ポイント差まで迫りながらコストは38%にとどまり、high努力度ではClaude Opus 4.8の最大努力度スコアにおよそ3分の1のコストで並ぶとされています。BrowseCompでは1タスクあたり2.03ドルで最高スコア91.2%を達成し、GPT-5.6 Solの半分のコスト、最大努力度のClaudeモデル群と比べると1桁安いと報告されています。GDPval-AA v2ではGPT-5.6 Solと50 Elo以内の差を13%低いコストで実現し、Claude Fable 5の2.6分の1のコストです。オープンウェイトモデルの実用上の位置づけを考えるうえで、スコアそのものより、この費用対効果の曲線のほうが実務的な意味を持つ場面は多いと思います。
7 Case Studies(事例研究)
GPU kernel optimization(GPUカーネル最適化) 各モデルが同一構成のサンドボックスで、1タスクあたり最大24時間の予算のもとプロファイリング・書き換え・ベンチマークを行う設定で比較されました。Kimi K3はAttnResのレイテンシを283.6ミリ秒から114.4ミリ秒へ短縮し、DSAとKDAの実行時間をそれぞれ55.1%・73.6%削減、MLAではピークTFLOPSの半分以上に到達しています。開発の後期には、初期のKimi K3チェックポイントが既にチームのカーネル最適化作業の大半を担っていたという記述もあります。
GPU compiler development(GPUコンパイラ開発) Kimi K3はMiniTritonという小型のTriton風コンパイラを開発しました。タイル単位のPythonフロントエンドとレイアウトシステム、ワープ単位のMLIR注釈・最適化層、PTXコード生成パイプラインを備え、その上にPyTorch風の高水準インターフェースを持つ二重モードのテンソルライブラリが構築されています。NVIDIA L20上でPyTorch eagerとtorch.compileを幾何平均で上回り、テンソルコアの行列積は最大形状で実測ルーフラインのおよそ90%に達したとされています。個々のカーネルの集合ではなく、DSLフロントエンドからIRパス、PTXコード生成、CUDAランタイムまで一貫したコンパイラを構築できた点が強調されています。
Chip design(チップ設計) 概念実証として、Kimi K3はKimi Codeを用いた48時間の自律実行の中で、ナノモデル向けの推論チップ試作をオープンソースのEDAツールとNangate45標準セルライブラリで構築・最適化・検証しました。4平方ミリメートルの面積予算内で100MHzのタイミングを満たし、RTLシミュレーションでのデコードスループットは毎秒8,700トークン超、標準セル146万個、SRAM 0.277 MiB、逆量子化を融合したINT4 MACアレイを統合したと報告されています。
Coding for research / Knowledge work(研究向けコーディングと知識労働) 計算天体物理学のI–Love–Q普遍関係の再現では、20本を超える論文をレビューして相互検証し、数値計算パイプライン全体を実装し、300を超える状態方程式を評価して公開されている式の不整合を特定し、3,000行以上のPythonとインタラクティブなHTMLダッシュボードを約2時間で生成したとされています。経験のある研究者なら通常1〜2週間を要する作業だという比較が添えられています。知識労働の事例では、42年にわたるAI ASIC産業を扱うインタラクティブな調査サイトを、87本の四半期報告書と99本のPDF(1万1,000ページ超)を素材に、2,800回超のWeb検索と1,100回超のターミナル操作、120ラウンド以上の反復改良を経て作成しています。
8 Conclusion(結論)
結論では、Kimi K3が世界初のオープンな3兆パラメータ級モデルとして、長期のコーディング、エージェント、知識、推論、視覚の各タスクでフロンティア水準の性能を示したとまとめられています。最も強力なプロプライエタリモデルとの差は残るものの、新たなオープンのフロンティアを誰もが手の届く範囲に設定するものであり、研究・配備・イノベーションにおいて広いコミュニティを後押しすることを期待する、と締めくくられています。
※Appendices(付録)
付録は6章構成です。Aは貢献者一覧、BはSiTU-GLUの詳細で、原点近傍での1次までのSwiGLUとの一致、\( \beta_1, \beta_2 \to \infty \) でSwiGLUに帰着すること、出力が \( \beta_1 \beta_2 = 100 \) で有界になること、ハードなクランプと異なり飽和境界から離れた領域で勾配が消えないことが示されます。CはQuantile Balancingの導出で、最大スコアの均衡割当問題の線形緩和と双対性から更新式が導かれ、既存の符号ベースの損失なし更新が同じ双対目的関数へのSignSGDステップに相当することが示されます。Dはヒストグラムによる分位点推定で、ビン幅による誤差の上界と通信コストが議論されます。EはMoonEPの上界 \( E/R \) の証明とそのタイトさ、Fはチャットテンプレートで、XTMLというXML風のマークアップ、グローバル/単発のオプションメッセージの配置、think・response・toolsという3つのチャネル、型付き引数を持つツール呼び出し、自然言語命令として表現される推論努力度の設定が説明されています。
まとめ
本稿では、Kimi K3の技術報告書をアーキテクチャ、事前学習、事後学習、計算基盤、評価の順に追いました。
オープンウェイトモデルとしては前例のない3兆パラメータ級への拡張と100万トークン規模のエージェント学習を同時に進め、GPT系やClaude系といったクローズドモデルの最先端モデルに肉薄した性能、そしてその手法全体を重み公開まで含めて開示した点がこれだけ話題を集めた理由であると改めて感じます。今後もMoonshotの取り組みには注視していきたいと思います。
Kimiシリーズの流れはK2.6の解説記事でも整理していますので、あわせてご覧ください。