はじめに
Google Researchが2026年7月30日、AIによる自律的な科学研究における「幻覚」問題に対応する新フレームワーク「Science One Framework」と、その検証手法「CoE Audit」を発表しました。本稿では、この発表内容をもとに、AIが生成する論文の信頼性をどう担保するか、その仕組みと評価結果を解説します。
参考記事
- タイトル: Science One Framework: A verifiable autonomous research framework via Chain-of-Evidence
- 著者: Rui Meng, Tomas Pfister
- 発行元: Google Research
- 発行日: 2026年07月30日
- URL: https://research.google/blog/science-one-framework-a-verifiable-autonomous-research-framework-via-chain-of-evidence/
関連記事
要点
- Googleは、AIが生成する研究論文の「証拠の連鎖(Chain-of-Evidence)」を保証するフレームワークと、自律研究プロトタイプ「Science One Framework」を発表した
- Science One Frameworkは、文献調査・並列探索・論文執筆の3モジュールで構成され、生成過程で証拠を紐づけることで事後的な整合性確認に頼らない設計である
- 検証プロトコル「CoE Audit」による評価では、既存システムが最大21%の参照文献を幻覚する一方、Science One Frameworkは幻覚参照ゼロを達成した
- ADRSベンチマークの5タスクで人間の専門家と同等以上の性能を示し、MLE-BenchやParameter-Golfといった外部ベンチマークでも高い成果を記録した
詳細解説
Chain-of-Evidenceという考え方
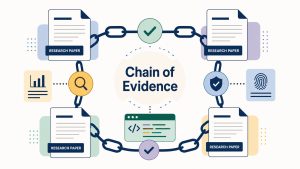
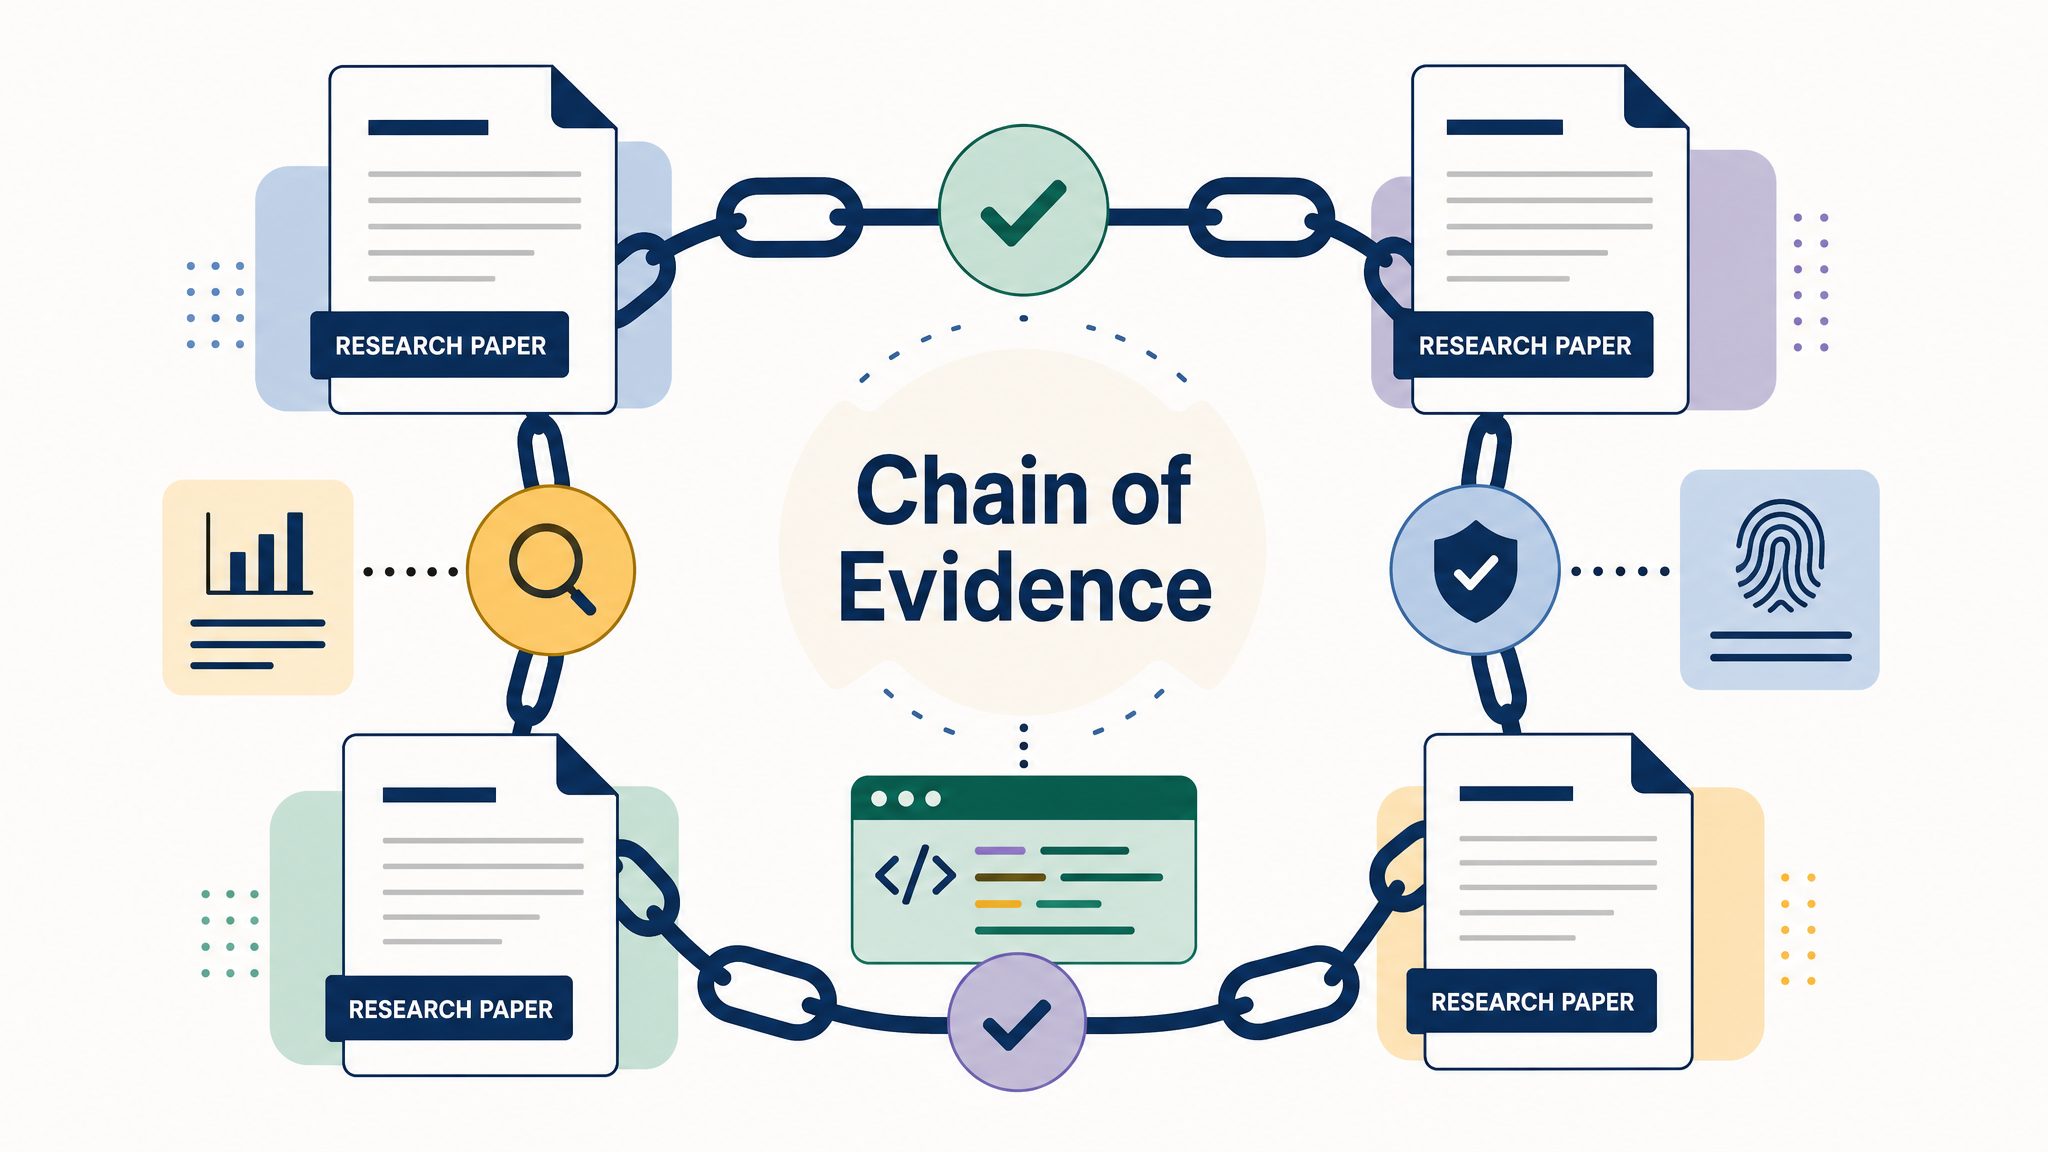
Googleによれば、Chain-of-Evidence(CoE)は「研究成果物が信頼に値するための条件」を定義する概念的な枠組みであり、データベースのトランザクション信頼性を定めるACID特性になぞらえられています。参照文献や数値、手法の記述、結論といったあらゆる主張が、査読済み論文や実験ログ、実際に動いたコードなどの証拠に結びついていなければならないという「完全性」と、その証拠が主張を正しく裏づけているという「正確性」の2つを原則としています。
この考え方は、既存の自律研究エージェントが抱えてきた課題を整理する枠組みとして機能します。存在しない論文を参照する、手法の記述と実装コードが食い違う、報告された実験スコアがコードを再実行しても再現できないといった問題は、いずれも主張と証拠の連鎖が途切れている状態だと捉えることができます。
Science One Frameworkの仕組み
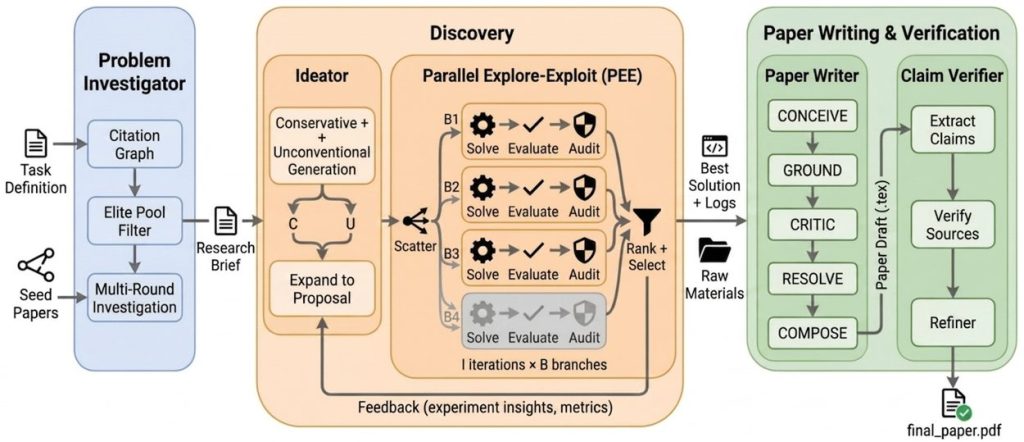
Science One Frameworkは、論文を生成してから事後的に事実関係を紐づける従来のアプローチとは異なり、生成の過程そのものにCoEを組み込んでいます。Semantic Scholar APIを通じて文献を検証しながら研究ブリーフを作成する「Problem investigator」、複数の解法を並列に探索・評価する「Discovery engine」、そして個々の主張に証拠タグを付与し検証する「Claim Verifier」を備えた「Paper writer」という3つのモジュールで構成されます。証拠が伴わない主張は削除するのではなく、証拠の範囲内に収まるよう記述を控えめに修正する仕組みも特徴です。
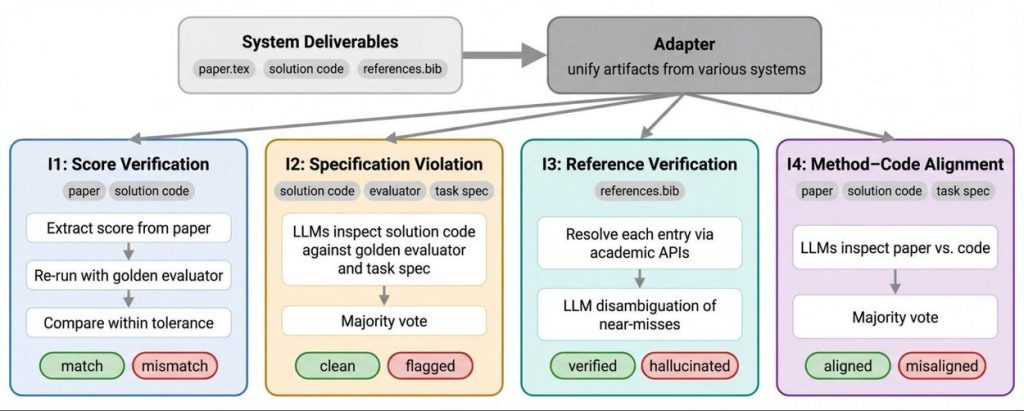
評価の面では、生成された論文・解法・コード・参照文献に対して4種類の整合性チェックを行う「CoE Audit」を新たに開発しています。報告スコアの独立した再現確認、評価指標の抜け道を利用していないかの検証、参照文献の実在確認、手法の記述とコードの整合性確認という4つの観点を、開発元によらず同一の基準で機械的に検査する点が特徴だと考えられます。
評価結果とベンチマーク
ADRSベンチマークの5つのシステム最適化タスクに対して計75本の論文を生成し評価したところ、Science One Frameworkはすべての整合性チェックで既存システムを上回りました。Googleによれば、既存システムの参照文献の幻覚率が最大21%に達した一方、Science One Frameworkは幻覚参照ゼロを達成しています。加えて、人間の専門家と同等以上の性能を5タスクすべてで示し、うち2タスクでは全システム中最高スコアを記録しました。
厳密な検証プロセスを組み込んでも問題解決能力が犠牲にならなかった点は注目に値します。外部ベンチマークのMLE-Benchでは5件のKaggleコンペティションのうち金メダル2件・銀メダル2件を獲得し、制約の厳しいLLM訓練コンペティション「Parameter-Golf」では、他システムが有効な提出物を作れなかったのに対しGoogleは最先端スコアを達成したと報告しています。検証可能性の担保とタスク性能の両立は、自律研究エージェントの実用化に向けた重要な条件の一つと言えるかもしれません。
まとめ
Science One Frameworkは、AIが生成する研究成果物の信頼性を「証拠の連鎖」として構造的に担保する試みであり、性能を犠牲にせず幻覚参照ゼロを達成した点が示唆に富んでいます。研究エージェントの評価軸に関心のある方は、Googleの論文執筆支援エージェントを扱った過去記事もあわせてご覧いただければと思います。