はじめに
中国のMoonshot AIが2026年4月、オープンソースAIモデル「Kimi K2.6」を公開しました。長時間コーディング・エージェントスウォーム・コーディング駆動デザインの3領域で前バージョンを大きく上回る性能を発揮するとされ、Modified MITライセンスで商用利用も可能です。本稿では、発表内容をもとにその特徴・ベンチマーク結果・実際の利用方法を解説します。
参考記事
- タイトル: Kimi K2.6: Advancing Open-Source Coding
- 著者: Moonshot AI
- 発行元: kimi.com
- 発行日: 2026年4月
- URL: https://www.kimi.com/blog/kimi-k2-6
関連記事
要点
- Kimi K2.6はMixture-of-Experts(MoE)構造を採用し、総パラメータ数は1兆、推論時に動作するアクティブパラメータは320億(32B)である
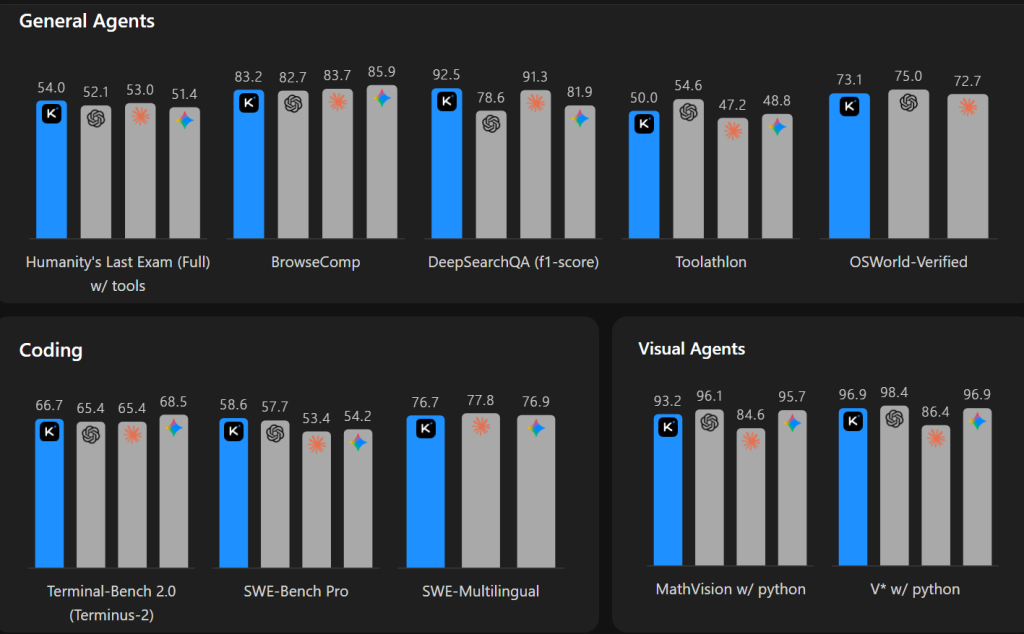
- コーディングベンチマークSWE-Bench ProでGPT-5.4(57.7%)やClaude Opus 4.6(53.4%)を上回る58.6%を記録した
- エージェントスウォームがK2.5の100サブエージェント・1,500ステップから300サブエージェント・4,000ステップへ約3倍規模に拡張された
- 公式APIはOpenAI/Anthropic互換で、ThinkingモードとInstantモードの切り替えが可能であり、画像・動画入力にも対応している
- vLLM・SGLang・KTransformers対応でセルフホストが可能であり、Modified MITライセンスで公開されている
詳細解説
モデルアーキテクチャ:大規模MoEの効率的な運用
Kimi K2.6はMixture-of-Experts(MoE)アーキテクチャを採用しています。MoEとは、大量の「エキスパート」と呼ばれるサブネットワークを持ちながら、各推論時には一部のエキスパートだけを選択・活用する設計です。全パラメータを常時動かすDenseモデルと比べて計算コストを抑えつつ、大規模なモデルの表現力を確保できる点が特長です。
Moonshot AIの発表によれば、K2.6の主な仕様は以下のとおりです。
| 項目 | 値 |
| アーキテクチャ | Mixture-of-Experts(MoE) |
| 総パラメータ数 | 1兆(1T) |
| アクティブパラメータ数 | 32B(推論時) |
| エキスパート数 | 384(推論ごとに8つ選択) |
| コンテキスト長 | 256K トークン |
| ビジョンエンコーダ | MoonViT(4億パラメータ) |
| ライセンス | Modified MIT |
Kimi K2.5と同アーキテクチャを採用しているため、K2.5向けに整備したデプロイ環境をそのまま流用できる点も実用上の利点です。
長時間コーディングの実力
Kimi K2.6がとくに強調しているのが「長時間コーディング」能力です。Rust・Go・Pythonといった多様な言語に加え、フロントエンド・DevOps・性能最適化など幅広いドメインで安定した性能を発揮するとされています。
Moonshot AIが公開した具体的な事例を2つ紹介します。
1つ目は、macOS上でのAIモデル推論最適化です。Kimi K2.6が、Zig言語(普及率が低いニッチなプログラミング言語)を用いてQwen3.5-0.8Bモデルのローカル推論を実装・最適化し、4,000回以上のツール呼び出しと12時間以上の連続実行・14回の反復改善を経て、スループットを約15トークン/秒から約193トークン/秒へ向上させたとのことです。最終的にLM Studioより約20%高速な性能を達成したと報告されています。
2つ目は、8年間運用されてきたオープンソースの金融マッチングエンジン「exchange-core」の最適化です。13時間の実行の中で12の最適化戦略を試み、1,000回以上のツール呼び出しで4,000行超のコードを修正。スレッド構成の変更をはじめとする根本的なリファクタリングにより、中間スループットを0.43 MT/sから1.24 MT/sへ 185% 向上させ、ピーク性能も1.23 MT/sから2.86 MT/sへ 133% 改善したと報告されています。
コーディングベンチマークの主な結果は以下のとおりです(Moonshot AI発表)。
| ベンチマーク | Kimi K2.6 | GPT-5.4 | Claude Opus 4.6 | Gemini 3.1 Pro | Kimi K2.5 |
| SWE-Bench Pro | 58.6% | 57.7% | 53.4% | 54.2% | 50.7% |
| Terminal-Bench 2.0 | 66.7% | 65.4% | 65.4% | 68.5% | 50.8% |
| SWE-Bench Verified | 80.2% | — | 80.8% | 80.6% | 76.8% |
| LiveCodeBench (v6) | 89.6% | — | 88.8% | 91.7% | 85.0% |
SWE-Bench Proは実際のGitHubリポジトリのバグ修正タスクを評価する指標で、K2.6はGPT-5.4やClaude Opus 4.6を上回っています。一方、LiveCodeBenchではGemini 3.1 Proが最高値を記録しており、コーディングの種類によって得意不得意が存在すると考えられます。
APIの使い方:ThinkingモードとInstantモードの切り替え
公式APIはOpenAI互換のエンドポイントを提供しており、既存のOpenAIクライアントライブラリをそのまま利用できます。APIキーは https://platform.moonshot.ai で取得できます。
以下は、ThinkingモードとInstantモードを切り替える基本的なチャット実装例です(Moonshot AI公式コードより)。
import openai
def simple_chat(client: openai.OpenAI, model_name: str):
    messages = [
        {'role': 'system', 'content': 'You are Kimi, an AI assistant created by Moonshot AI.'},
        {
            'role': 'user',
            'content': [
                {'type': 'text', 'text': 'Which one is bigger, 9.11 or 9.9? Think carefully.'}
            ],
        },
    ]

    # --- Thinkingモード(推論内容も返す) ---
    response = client.chat.completions.create(
        model=model_name,
        messages=messages,
        stream=False,
        max_tokens=4096
    )

    print('=== Thinking Mode: 推論内容 ===')
    print(response.choices[0].message.reasoning)
    print('=== Thinking Mode: 応答 ===')
    print(response.choices[0].message.content)

    # --- Instantモード(推論なし、高速) ---
    response = client.chat.completions.create(
        model=model_name,
        messages=messages,
        stream=False,
        max_tokens=4096,
        extra_body={'thinking': {'type': 'disabled'}}  # 公式APIの場合
        # extra_body={'chat_template_kwargs': {"thinking": False}}  # vLLM/SGLangの場合
    )

    print('=== Instant Mode: 応答 ===')
    print(response.choices[0].message.content)
クライアントの初期化は以下のように行います。
client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.moonshot.ai/v1"
)

simple_chat(client, model_name="kimi-k2-6")
Thinkingモードでは message.reasoning に推論過程が格納され、message.content に最終回答が入ります。Instantモードは extra_body で thinking を無効化することで有効になります。
画像・動画入力の実装
K2.6はネイティブマルチモーダルに対応しており、画像と動画をBase64エンコードして渡すことができます。
画像入力の例:
import openai, base64, requests

def chat_with_image(client: openai.OpenAI, model_name: str):
    # 画像をBase64エンコード
    url = 'https://example.com/image.png'
    image_base64 = base64.b64encode(requests.get(url).content).decode()
    messages = [
        {
            'role': 'user',
            'content': [
                {'type': 'text', 'text': 'Describe this image in detail.'},
                {
                    'type': 'image_url',
                    'image_url': {'url': f'data:image/png;base64,{image_base64}'},
                },
            ],
        }
    ]

    response = client.chat.completions.create(
        model=model_name,
        messages=messages,
        stream=False,
        max_tokens=8192
    )

    return response.choices[0].message.content
動画入力の例(公式APIのみ対応、現在は実験的機能):
def chat_with_video(client: openai.OpenAI, model_name: str):
    url = 'https://example.com/demo_video.mp4'
    video_base64 = base64.b64encode(requests.get(url).content).decode()
    messages = [
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Describe the video in detail."},
                {
                    "type": "video_url",
                    "video_url": {"url": f"data:video/mp4;base64,{video_base64}"},
                },
            ],
        }
    ]

    response = client.chat.completions.create(
        model=model_name,
        messages=messages
    )

    return response.choices[0].message.content
動画入力は現在、公式API(platform.moonshot.ai)のみのサポートです。vLLM・SGLang経由のデプロイでは利用できない点に注意が必要です。
マルチターン対話での推論内容の保持(Preserve Thinking)
K2.6は preserve_thinking モードに対応しており、マルチターン対話を通じて推論内容を保持することができます。コーディングエージェントシナリオでの性能向上が期待できる機能です。デフォルトでは無効になっています。
def chat_with_preserve_thinking(client: openai.OpenAI, model_name: str):
    messages = [
        {
            "role": "user",
            "content": "Tell me three random numbers."
        },
        {
            "role": "assistant",
            # 前のターンの推論内容を明示的に渡す
            "reasoning_content": "I'll start by listing five numbers: 473, 921, 235, 215, 222, and I'll tell you the first three.",
            "content": "473, 921, 235"
        },
        {
            "role": "user",
            "content": "What are the other two numbers you have in mind?"
        }
    ]

    response = client.chat.completions.create(
        model=model_name,
        messages=messages,
        stream=False,
        max_tokens=4096,
        extra_body={'thinking': {'type': 'enabled', 'keep': 'all'}}  # 公式API
        # extra_body={"chat_template_kwargs": {"thinking": True, "preserve_thinking": True}}  # vLLM/SGLang
    )

    # assistantは推論内容(215, 222)を記憶した回答を返す
    print(response.choices[0].message.reasoning)

    return response.choices[0].message.content
reasoning_content に前ターンの推論を渡すことで、モデルが複数ターンにわたる思考の文脈を保持します。長いコーディングセッションで一貫した設計判断を維持させたい場合に有効な機能だと思います。
セルフホストのデプロイ方法
K2.6はHugging Face(moonshotai/Kimi-K2.6)でモデルウェイトが公開されており、以下の推論エンジンでのセルフホストが推奨されています。
- vLLM
- SGLang
- KTransformers
transformersのバージョン要件は >=4.57.1, <5.0.0 です。K2.5と同じアーキテクチャのため、K2.5向けのデプロイ設定をそのまま流用できます。
vLLM・SGLang経由で利用する場合の推奨パラメータは以下のとおりです。
| パラメータ | Thinkingモード | Instantモード |
| temperature | 1.0 | 0.6 |
| top_p | 1.0(デフォルト) | 0.95 |
| thinking切り替え | {“thinking”: True} | {“thinking”: False} |
なお、ベンチマーク結果を公式と一致させたい場合は公式API(platform.moonshot.ai)の利用が推奨されています。サードパーティプロバイダ経由での結果と差異が生じる可能性があり、提供されている「Kimi Vendor Verifier(KVV)」ツールで精度を事前確認できます。
エージェントスウォームと「Claw Groups」
Kimi K2.5のAgent Swarm(研究プレビュー)を発展させ、K2.6では最大 300サブエージェント・4,000ステップの並列協調実行 を実現しています。K2.5が100サブエージェント・1,500ステップだったことと比較すると、規模が約3倍に拡張されたことになります(Moonshot AI発表)。
この拡張により、広範な検索と深掘り調査の組み合わせ、大量ドキュメントの分析と長文ライティングの融合、複数フォーマットのコンテンツ並列生成といった複合タスクを1回の自律実行で完結させることが可能になったとされています。また、既存のPDF・スプレッドシート・スライド・Wordドキュメントを「スキル」として取り込み、文書の構造・スタイルを学習して将来のタスクで再現する機能も追加されました。
研究プレビューとして「Claw Groups」も公開されました。異なるデバイス・異なるモデルで動作する複数のエージェントと人間が同一の作業空間で協調するオープンなエコシステムで、K2.6がコーディネーターとして各エージェントのスキルや利用可能なツールに応じてタスクを動的に割り当てる構成です。「私のエージェント」「あなたのエージェント」「私たちのチーム」の境界が溶けた協調システムを目指すという方向性は、エージェントAIの今後を考えるうえで注目に値すると思います。
まとめ
Kimi K2.6は、SWE-Bench Proで主要商用モデルを上回り、長時間の自律コーディングや300体規模のエージェントスウォームを実現したオープンソースモデルです。公式APIはOpenAI互換で既存ライブラリがそのまま使え、vLLM・SGLangでのセルフホストにも対応しています。前バージョンとの比較や背景を理解するうえで、K2.5の解説(https://jobirun.com/kimi-k2-5-agent-swarm-open-source-multimodal-ai/)もあわせてご覧いただければと思います。