はじめに
Google Researchが2026年2月4日、大規模機械学習モデルの効率化を実現する新しいアルゴリズム「Sequential Attention」を発表しました。本稿では、この技術がどのように従来の課題を解決し、モデルの軽量化と高速化を精度を犠牲にせずに実現するのか、その仕組みと応用例を解説します。
参考記事
- タイトル: Sequential Attention: Making AI models leaner and faster without sacrificing accuracy
- 著者: Thomas Fu (Principal Engineer), Kyriakos Axiotis (Senior Scientist)
- 発行元: Google Research
- 発行日: 2026年2月4日
- URL: https://research.google/blog/sequential-attention-making-ai-models-leaner-and-faster-without-sacrificing-accuracy/
要点
- Sequential Attentionは、AIモデルの効率化における根本的な課題である「サブセット選択問題」に対する解決策である
- 従来のアテンション機構と異なり、逐次的かつ適応的に最適な要素を選択することで、NP困難な問題に対処する
- 特徴選択とブロックスパース化の両分野で最先端の性能を達成し、モデルの軽量化と高速化を精度を保ちながら実現した
- 大規模言語モデルのプルーニング、創薬、ゲノミクスなど、幅広い応用可能性を持つ
詳細解説
サブセット選択問題とは
Sequential Attentionが取り組むのは、機械学習における「サブセット選択問題」です。Googleによれば、この問題は特徴選択の一般化された形態であり、最も有用な入力変数のサブセットを特定し、無関係またはノイズとなる変数を除外するプロセスを指します。
特徴選択は、機械学習とディープラーニングの両方において基本的な課題ですが、数学的にはNP困難問題に分類されます。NP困難とは、大規模なデータセットに対して完璧かつ高速に解くことが理論上「不可能」とされる問題を意味します。現代のディープニューラルネットワークでは、複雑な非線形特徴の相互作用により、この問題はさらに難しくなっています。
ある特徴は単独では統計的に重要に見えなくても、ネットワークの非線形層内で他の特徴と組み合わさることで重要になる場合があります。逆に、単独では重要に見える特徴も、他の特徴を考慮すると冗長になることもあります。この複雑性が、効率的なモデル構築における大きな障壁となっています。
サブセット選択問題は、特徴選択だけでなく、埋め込み次元の調整やウェイトプルーニングにも適用できます。埋め込み次元の調整は埋め込みチャンクのサブセット選択、ウェイトプルーニングは重み行列のエントリのサブセット選択と捉えることができます。このため、汎用的なサブセット選択のs解法を開発することは、最も効率的なモデルを構築する上で大きな影響力を持つと考えられます。
Sequential Attentionの仕組み
Sequential Attentionは、アテンション機構の重み付け能力を活用して、サブセットを段階的に構築します。Googleの説明によれば、標準的な「ワンショット」アテンションがすべての候補を同時に重み付けするのに対し、Sequential Attentionは逐次的な決定プロセスとして扱います。
この手法の核心は、選択済み候補のセットを維持し、それらをコンテキストとして次に最も有用な候補を見つけることです。これは2つの主要な方法で実現されます。第一に、貪欲選択(greedy selection)により、各ステップでどの要素を含めるかについて局所的に最適な決定を行います。第二に、重要度評価では「アテンションスコア」を使用して、現在選択されている候補に加えて、すべての候補の重要度を定量化します。
Sequential Attentionは、標準的なアテンション機構と同様にソフトマックス関数を使用して異なるコンポーネントの重要度をランク付けしますが、ワンショットではなく逐次的に動作する点が異なります。これにより、選択アルゴリズムが以前の選択に適応できるようになり、高品質な重要度ランク付けにとって重要な特性となっています。
従来の貪欲選択手法では、各ステップで潜在的な特徴ごとにモデルを再訓練または再評価する必要があり、計算コストが膨大になるという課題がありました。Sequential Attentionは、この高コストな方法をモデルの内部アテンション重みという、はるかに安価な代理指標で置き換えることで、大規模モデルへの適用を可能にしています。
Sequential Attentionの利点
Googleによれば、Sequential Attentionの主な利点は次の3つです。
第一に、効率性と精度の両立です。候補の並列処理を可能にすることで(アテンションスコアが計算された後)、従来の逐次選択よりも高速に評価できます。
第二に、解釈可能性です。アテンションスコア自体が強力な診断ツールとなります。研究者はアテンションスコアを検査することで、モデルが特定の決定を行ったり特定のトークンを生成したりする際に、入力のどの部分を優先したかを正確に把握できます。これにより、ブラックボックスモデルよりもモデルの内部推論が解釈しやすくなります。
第三に、スケーラビリティです。大量の候補を効率的に処理する能力は、現代のニューラルネットワークにおける大規模な特徴選択にとって不可欠です。
これらの利点により、Sequential Attentionは理論的な優位性だけでなく、実用的な価値も提供していると言えます。
特徴選択への応用
Googleの論文「Sequential Attention for Feature Selection」では、Sequential Attentionアルゴリズムを特徴選択に適用した結果が報告されています。
各ステップで、Sequential Attentionアルゴリズムは残りの未選択特徴すべてに対してアテンション重みを計算し、最も高いアテンションスコア(モデルが「最も注意を払っている」もの)を持つ特徴をサブセットに永続的に追加します。その後、アルゴリズムは選択プロセス(入力データをニューラルネットワークを通じて層ごとに順伝播させて予測を生成するプロセス)を再実行し、残りの特徴に対してアテンション重みを再計算します。
この再計算により、限界利得(すでに選択された特徴を考慮した上で、ある特徴がパフォーマンスにどれだけ寄与するか)が自然に反映されます。これにより、モデルは冗長な特徴の追加を効果的に識別し回避できます。
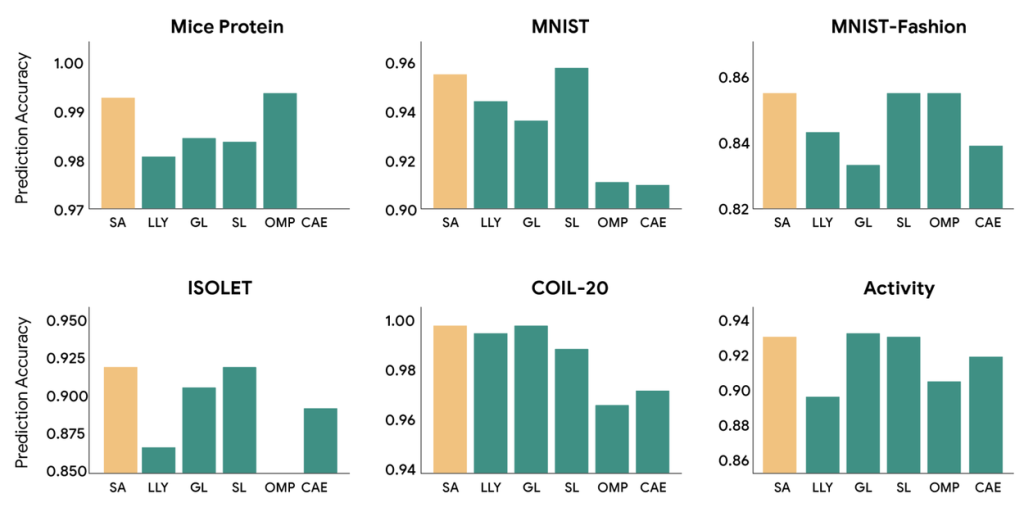
Googleによれば、Sequential Attentionアルゴリズムは複数のニューラルネットワークベンチマークで最先端の結果を達成しました。特に注目すべきは、効率性の劇的な改善です。高コストな明示的限界利得計算を必要とせず、貪欲選択の高速なワンパス実装を可能にしました。
さらに、この研究では、シンプルな線形回帰モデルに適用した場合、Sequential Attentionアルゴリズムが確立されたOrthogonal Matching Pursuit(OMP)アルゴリズムと数学的に等価であることが実証されました。この等価性は、OMPが信頼性とパフォーマンスについて証明可能な保証を持つため、重要な意味を持ちます。
プロテオミクス、画像認識、活動認識などのベンチマークで、提案手法は既存手法と比較して競争力のある、または最高の結果を達成しました。これは、手法の堅牢性を確認するものと考えられます。
ブロックスパース化への応用
ニューラルネットワークのプルーニング(不要な重みを削除してモデルサイズを削減すること)は、大規模モデルを効率的に展開する上で不可欠です。従来の研究は、訓練可能なパラメータを重要度の代理として使用する微分可能プルーニングと、最適なスパース構造を探索するアルゴリズムを使用する組合せ最適化という、2つのほぼ独立した道を追求してきました。
Googleの論文「SequentialAttention++ for Block Sparsification: Differentiable Pruning Meets Combinatorial Optimization」では、これら2つのアプローチを構造化ニューラルネットワークプルーニングのための一貫したフレームワークに統合することを目指しました。構造化プルーニングは、GPUやTPUなどのハードウェアアクセラレータでの実際の改善を実現するために、重みのブロックまたはチャネル全体を削除します。
結果として開発されたアルゴリズムSequentialAttention++は、重み行列の最も重要なブロックを発見する新しい方法を提供します。Googleによれば、ImageNet分類などの機械学習タスクにおいて、精度を犠牲にすることなく、モデル圧縮と効率性の大幅な向上を示しました。
非構造化プルーニングとは異なり、ブロックベースのスパース性はハードウェアアクセラレーションを活用して、より優れた推論パフォーマンスを実現します。これは、実用的な展開において重要な利点と言えます。
今後の展開
Googleは、Sequential Attentionの今後の応用分野として、いくつかの重要な領域を挙げています。
第一に、実際の制約を考慮した特徴エンジニアリングです。Sequential Attentionは、推薦システムで使用される大規模埋め込みモデル(LEM)の特徴埋め込み層の最適化において、大きな品質向上と効率性の節約を実証しました。これらのモデルは通常、大規模な埋め込みテーブルを持つ多数の異種特徴を持つため、特徴選択/プルーニング、特徴クロス探索、埋め込み次元最適化のタスクは非常に影響力があります。将来的には、これらの特徴エンジニアリングタスクが実際の推論制約を考慮できるようにし、完全に自動化された継続的な特徴エンジニアリングを可能にしたいとしています。
第二に、大規模言語モデル(LLM)のプルーニングです。SequentialAttention++のパラダイムは、LLMプルーニングにとって有望な方向性と考えられます。このフレームワークを適用することで、構造化スパース性(ブロックスパース性など)を強制し、冗長なアテンションヘッド、埋め込み次元、またはトランスフォーマーブロック全体をプルーニングし、予測パフォーマンスを維持しながらモデルのフットプリントと推論レイテンシを大幅に削減できる可能性があります。
第三に、創薬とゲノミクスです。特徴選択は生物科学において不可欠です。Sequential Attentionは、高次元データセットから影響力のある遺伝的または化学的特徴を効率的に抽出するように適応でき、創薬や個別化医療におけるモデルの解釈可能性と精度の両方を向上させることができます。
現在の研究は、Sequential Attentionをより効率的に大規模データセットや非常に複雑なアーキテクチャに対応できるようにスケーリングすることに焦点を当てています。さらに、より優れたプルーニングされたモデル構造を特定し、厳密な数学的保証を実際のディープラーニングアプリケーションに拡張する取り組みが続いており、業界全体でフレームワークの信頼性を固めていくとしています。
まとめ
Google Researchが発表したSequential Attentionは、AIモデルの効率化における根本的な課題であるサブセット選択問題に対する実用的な解決策を提供します。特徴選択とブロックスパース化で最先端の性能を達成し、今後はLLMプルーニングや創薬など幅広い分野への応用が期待されています。AIモデルの大規模化が進む中、精度を保ちながら効率化を実現するこの技術の重要性は、今後さらに高まっていくと考えられます。