はじめに
Google Researchが2026年2月9日、鳥などの陸上動物の音声で訓練された生物音響基礎モデル「Perch 2.0」が、水中音響の分類タスクで優れた性能を発揮することを報告しました。本稿では、この発表内容をもとに、Perch 2.0の転移学習性能、評価結果、そして陸上音声で訓練されたモデルが水中音響で機能する理由について解説します。
参考記事
- タイトル: How AI trained on birds is surfacing underwater mysteries
- 著者: Lauren Harrell, Data Scientist, Google Research
- 発行元: Google Research Blog
- 発行日: 2026年2月9日
- URL: https://research.google/blog/how-ai-trained-on-birds-is-surfacing-underwater-mysteries/
- Colab URL: https://github.com/google-research/perch/blob/main/chirp/projects/whale_demo/agile_modeling_noaa_demo.ipynb
要点
- Perch 2.0は、鳥やその他の陸上動物の音声で訓練された生物音響基礎モデルであり、訓練データに水中音声を含まないにもかかわらず、クジラの音声分類などの海洋タスクで高い転移学習性能を示した
- NOAA PIPAN、ReefSet、DCLDEという3つの水中音響データセットで評価され、Perch 2.0は一貫してトップまたは2番目の性能を記録した
- 転移学習により、少量のラベル付きデータ(クラスあたり4〜32例)から効率的にカスタム分類器を作成でき、研究者の時間と計算リソースを大幅に削減できる
- Google ColabでのEnd-to-Endチュートリアルが公開され、NOAAのPassive Acoustic Data Archiveを使用してクジラの音声分類器を作成する方法が示されている
- この転移性能の理由として、大規模モデルの汎化能力、類似音声の分類による詳細な音響特徴の学習、種を超えた音声生成メカニズムの類似性が挙げられている
詳細解説
Perch 2.0と水中音響研究の背景
Google Researchによれば、水中音響は海洋生物とその環境の見えないパターンを理解するために重要です。海洋音景には謎の音や未発見の発見が満ちており、例えば最近になってアメリカ海洋大気庁(NOAA)が、謎の「biotwang」音をニタリクジラに帰属させたことが報告されています。このように、新しい音のタイプや種の帰属が定期的に特定される継続的な課題があります。
Googleは、生物音響を使用してクジラの監視と保護を行う外部科学者との協力の長い歴史があり、2024年には多種クジラモデルをリリースしています。2025年8月、Google DeepMindは最新の生物音響基礎モデルであるPerch 2.0をリリースしました。このモデルは主に鳥やその他の陸上発声動物で訓練されていますが、訓練に水中音声を含まないにもかかわらず、海洋検証タスクでの転移学習の埋め込みモデルとして優れた性能を発揮しました。
生物音響基礎モデルとは、大量の音響データで事前訓練され、さまざまな下流タスクに適用できる汎用的なモデルを指します。こうしたモデルは、特定のタスクに特化したモデルを一から構築するよりも効率的に新しいタスクに適応できるという利点があります。
転移学習による効率的な分類器の作成
Google Researchの説明では、事前訓練された分類モデル(例えば多種クジラモデル)がすでに必要なラベルを持ち、研究者のデータセットでうまく機能する場合、それを直接使用してスコアとラベルを生成できます。しかし、新しく発見された音のためにカスタム分類器を作成したり、新しいデータでの精度を向上させたりするには、ゼロから新しいモデルを構築する代わりに転移学習を活用できます。このアプローチにより、新しいカスタム分類器を作成するために必要な計算と実験の量が大幅に削減されます。
生物音響転移学習では、事前訓練されたモデル(Perch 2.0など)を使用して、各音声ウィンドウの埋め込み(embedding)を生成します。これらの埋め込みは、大きな音声データをはるかに小さい特徴量の配列に縮小し、単純な分類器の入力として機能します。ラベル付き音声データの任意のセットに対して新しいカスタムモデルを作成するには、事前訓練されたモデルを音声データに適用して埋め込みを取得し、これをロジスティック回帰分類器の入力特徴として使用します。深層ニューラルネットワークのすべてのパラメータを学習する代わりに、ロジスティック回帰の最後のステップの新しいパラメータのみを学習すればよいため、研究者の時間と計算リソースの両方でずっと効率的です。
転移学習は、機械学習における確立された手法であり、特に訓練データが限られている場合に有効です。生物音響分野では、希少種や新しく発見された種の音声データは限られていることが多く、転移学習のアプローチが特に価値を持つと考えられます。
3つのデータセットでの評価結果
Google Researchは、Perch 2.0を、Perch Hopliteリポジトリでサポートされている他の事前訓練モデル(Perch 1.0、SurfPerch、多種クジラモデル)と比較して評価しました。水中データの評価には、3つのデータセットが使用されました。
NOAA PIPANデータセットは、NOAA太平洋諸島漁業科学センターの録音から作成されたNOAA NCEI Passive Acoustic Data Archiveの注釈付きサブセットです。このデータセットには、以前のクジラモデルで使用されたラベルに加えて、コビレゴンドウ、ザトウクジラ、イワシクジラ、シロナガスクジラ、ナガスクジラ、ニタリクジラなどのヒゲクジラ種の新しい注釈が含まれています。
ReefSetデータセットは、SurfPerchモデルのトレーニング用に開発され、Google Arts and CultureプロジェクトであるCalling in Our Coralsのデータ注釈を活用しています。このデータセットには、生物学的なサンゴ礁の音(クロークス、クラックル、グロール)、特定の種/属クラス(例:スズメダイ、イルカ、ハタ)、人為的な騒音や波のクラスが含まれています。
DCLDEデータセットは、3つの異なるラベルセットを使用して評価されました。Species(種)ラベルセットでは、シャチ、ザトウクジラ、非生物音、未知の水中音を区別します(シャチとザトウクジラのラベルには一部不確実性があります)。Species Known Bio(既知の生物種)ラベルセットでは、シャチとザトウクジラの確実なラベルのみを使用します。Ecotype(生態型)ラベルセットでは、シャチの亜集団(生態型)を区別します。これには、Transient/Biggs、Northern Residents、Southern Residents、Southeastern Alaska killer whales、Offshore killer whalesが含まれます。
評価プロトコルでは、ラベル付きデータを持つターゲットデータセットに対して、各候補モデルから埋め込みを計算します。次に、クラスごとに固定数の例(4、8、16、または32)を選択し、埋め込みの上に単純な多クラスロジスティック回帰モデルをトレーニングします。結果の分類器を使用して、ROC曲線下面積(AUC_ROC)を計算します。AUC_ROCは、1に近い値がクラス間を区別するより強い能力を示す指標です。このプロセスは、少数のラベル付き例から特定の事前訓練埋め込みモデルを使用してカスタム分類器を作成することをシミュレートしています。
Google Researchの結果によれば、クラスあたりの例が多いほど、すべてのモデルでパフォーマンスが向上しました。ただし、ReefSetデータでは例外で、多種クジラモデルを除くすべてのモデルで、クラスあたり4例でもパフォーマンスが高かったとのことです。注目すべきことに、Perch 2.0は各データセットとサンプルサイズで一貫してトップまたは2番目のパフォーマンスを示しました。
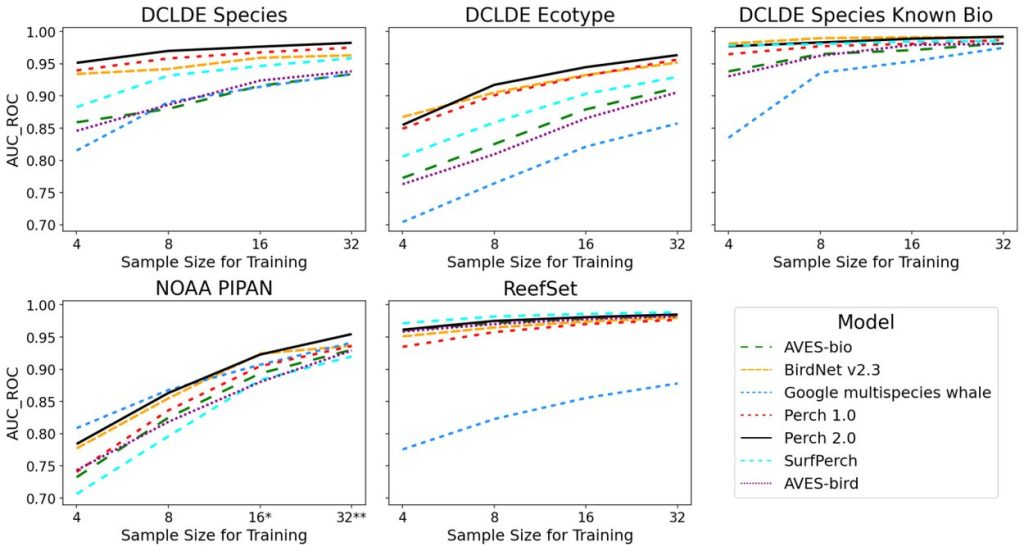
さらに、Perch 2.0はEarth Species ProjectのAVES-birdおよびAVES-bio(それぞれ鳥と生物音で訓練されたトランスフォーマー生物音響モデル)、およびCornell Lab of OrnithologyのBirdNet v2.3とも比較されました。Perch 2.0はほとんどの水中タスクでAVES-birdとAVES-bioを上回りましたが、水中音声で訓練されていない他の事前訓練モデルも良好なパフォーマンスを示したとのことです。
鳥の訓練データから水中音響への転移が機能する理由
Google Researchは、主に鳥で訓練されたモデルから水中音響への転移性能について、いくつかの理由を提示しています。
第一に、先行研究では、広範な訓練データを持つより大きなモデルがより良く汎化することが示されており、これにより生物音響モデルが訓練データセットに含まれていない種や音を分類する下流タスクでも良好に機能すると考えられます。大規模な訓練データは、モデルがより一般的な音響パターンを学習することを可能にし、それが新しいドメインへの適用を容易にするという仮説です。
第二に、類似した鳥の鳴き声を分類するという課題(「bitternのレッスン」と呼ばれる)により、モデルは詳細な音響特徴を学習することを余儀なくされ、それが他の生物音響タスクにも有益になると説明されています。例えば、北米には14種のハトがおり、それぞれが微妙に異なる「クー」という音を持っています。各種固有の「クー」を区別できる特徴を抽出するモデルは、他の音クラスを分離するのに役立つ特徴を分離する可能性が高いと考えられます。
第三に、異なる種の間での特徴転移は、音声生成メカニズム自体に関連している可能性もあります。鳥類と海洋哺乳類を含むさまざまな種が、類似した音声生成手段を進化させてきたことが知られています。つまり、生物学的に異なる種であっても、音を生み出す物理的なメカニズムには共通点があり、それがモデルの転移学習を可能にしている可能性があります。
高性能なモデルは、適用されるターゲットクラスに対して情報量が多く線形分離可能な埋め込みを持ちます。これを視覚化するために、Google Researchは各モデルからの埋め込みの要約をtSNE(t-distributed stochastic neighbor embedding)という手法を使用してプロットしました。異なる色が異なるクラスを表します。高度に情報量の多いモデルは各クラスに対して明確なクラスターを示しますが、情報量の少ないモデル(多種クジラモデルなど)ではクラスがより混在します。Google Researchの分析では、ほぼすべてのモデルがSouthern Resident killer whales(KW_SRKW)とSouthern Alaskan Residents(KW_SAR)に対して明確なクラスターを示しましたが、Northern Resident killer whales(KW_NRKW)、Transient killer whales(KW_TKW)、Offshore killer whales(KW_OKW)の音は、AVES-bio、AVES-bird、SurfPerchなどのモデルでは混在していたのに対し、BirdNet v2.3とPerch 2.0ではより明確に区別されていたとのことです。
アジャイルモデリングアプローチと今後の展開
Google DeepMind Perchチームは、Google Researchおよび外部パートナーと協力して、生物音響のためのアジャイルモデリングアプローチを開拓しています。このアプローチでは、少数のラベル付き例から数時間以内にカスタム分類器を作成できます。
Google Researchチームおよび広範なクジラ音響コミュニティをサポートするために、Google Cloud上でホストされているPassive Acoustic ArchiveデータセットのNOAAデータを使用するためのEnd-to-Endデモが作成されました。これは、埋め込みを管理するためのより効率的なPerch Hopliteデータベースを使用して、以前のチュートリアルを更新したものです。
このチュートリアルの公開により、研究者はPerch 2.0を使用してクジラの音声分類器を効率的に作成できるようになり、海洋生物の監視と保護に貢献できると考えられます。アジャイルモデリングの考え方は、新しい発見から科学的洞察へのつながりを大規模に効率化することを目指しており、生物音響研究の加速に寄与する可能性があります。
まとめ
Google Researchは、鳥の音声で訓練されたPerch 2.0が、水中音響タスクで高い転移学習性能を示すことを報告しました。3つのデータセットでの評価で一貫して優れた結果を記録し、少量のラベル付きデータから効率的にカスタム分類器を作成できることが示されています。Google Colabでのチュートリアル公開により、研究者が実際にこの手法を活用できる環境も整備されました。陸上と水中という異なる環境の音響タスク間での転移学習の成功は、生物音響研究の新しい可能性を示していると言えます。